
爬虫实现:根据IP地址反查域名
域名解析与IP地址
域名解析是把域名指向网站空间IP,让人们通过注册的域名可以方便地访问到网站的一种服务;IP地址是网络上标识站点的数字地址,为了方便记忆,采用域名来代替IP地址标识站点地址。域名解析就是域名到IP地址的转换过程,该过程由DNS服务器完成(来自百度百科)
先来了解两个知识点
1、一个域名同一时刻只能对应一个IP地址
2、一个IP地址可以解析绑定多个域名,没有限制
基于以上知识点,假如我们已知一个IP地址,我们怎么才能获取解析到该IP地址的所有域名信息呢?一种方式是国家工信部能开放查询接口以供查询(不知道会不会开放?);另外一种方式就是接下来我要分享的——爬虫实现:根据IP地址反查域名。
实现原理
实现原理其实很简单,现在已有网站提供了根据IP地址查询域名的功能,但是需要人为登录网站输入IP地址查询,我想要实现程序自动化查询,所以就想到了爬虫的方式,简单来说,就是模拟人的查询行为,将查询结果解析成我想要的域名列表。
以site.ip138.com为例,打开F12,输入一个IP查询,观察控制台请求,看到下图中信息
请求地址为:http://site.ip138.com/119.75.217.109/
请求方式为:GET

然后,分析Response,可以看到,在页面上看到的绑定域名信息就是下图红框中的内容,所以只要能将Response的内容解析出来,获取到的内容就可以得到想要的域名列表。
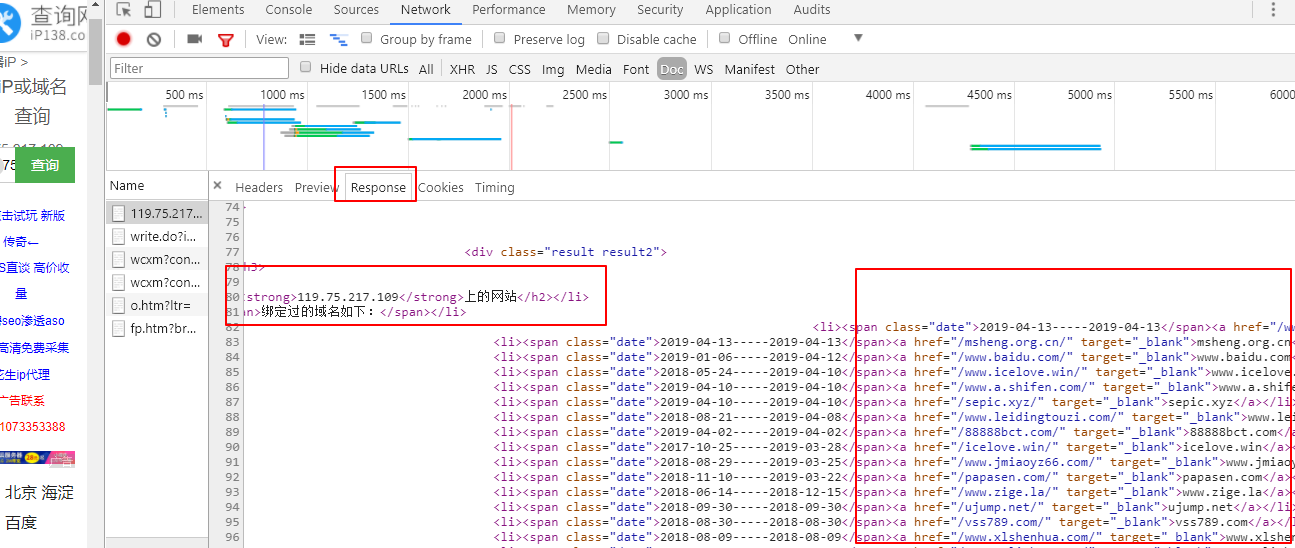
上述Response是HTML页面,使用jsoup来解析HTML简直完美。
jsoup是什么?
jsoup 是一款Java 的HTML解析器,可直接解析某个URL地址、HTML文本内容。它提供了一套非常省力的API,可通过DOM,CSS以及类似于jQuery的操作方法来取出和操作数据。
//解析成Document对象

Document document = Jsoup.parse(result);

if (document == null) {

    logger.error("Jsoup parse get document null!");

}

//根据ID属性“list”获取元素Element对象(有没有感觉很像jQuery?)

Element listEle = document.getElementById("list");

//根据class属性和属性值筛选元素Element集合,并通过eachText()遍历元素内容

return listEle.getElementsByAttributeValue("target", "_blank").eachText();
result的内容通过HttpClient模拟HTTP请求
HttpGet httpGet = new HttpGet(url);

httpGet.setHeader("Accept", "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8");

httpGet.setHeader("Accept-Encoding", "gzip, deflate");

httpGet.setHeader("Accept-Language", "zh-CN,zh;q=0.9");

httpGet.setHeader("Cache-Control", "max-age=0");

httpGet.setHeader("Connection", "keep-alive");

httpGet.setHeader("Cookie", "Hm_lvt_d39191a0b09bb1eb023933edaa468cd5=1553090128; BAIDU_SSP_lcr=https://www.baidu.com/link?url=FS0ccst469D77DpdXpcGyJhf7OSTLTyk6VcMEHxT_9_&wd=&eqid=fa0e26f70002e7dd000000065c924649; pgv_pvi=6200530944; pgv_si=s4712839168; Hm_lpvt_d39191a0b09bb1eb023933edaa468cd5=1553093270");

httpGet.setHeader("DNT", "1");

httpGet.setHeader("Host", host);

httpGet.setHeader("Upgrade-Insecure-Requests", "1");

httpGet.setHeader("User-Agent", "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36");

String result = HttpUtils.doGet(httpGet);
HTTP请求工具类
public class HttpUtils {

    private static Logger logger = LoggerFactory.getLogger(HttpUtils.class);

    public static String doGet(HttpGet httpGet) {

        CloseableHttpClient httpClient = null;

        try {

            httpClient = HttpClients.createDefault();

            RequestConfig requestConfig = RequestConfig.custom()

                    .setConnectTimeout(5000).setConnectionRequestTimeout(10000)

                    .setSocketTimeout(5000).build();

            httpGet.setConfig(requestConfig);

            HttpResponse httpResponse = httpClient.execute(httpGet);

            if (httpResponse.getStatusLine().getStatusCode() == 200 ||

                    httpResponse.getStatusLine().getStatusCode() == 302) {

                HttpEntity entity = httpResponse.getEntity();

                return EntityUtils.toString(entity, "utf-8");

            } else {

                logger.error("Request StatusCode={}", httpResponse.getStatusLine().getStatusCode());

            }

        } catch (Exception e) {

            logger.error("Request Exception={}:", e);

        } finally {

            if (httpClient != null) {

                try {

                    httpClient.close();

                } catch (IOException e) {

                    logger.error("关闭httpClient失败", e);

                }

            }

        }

        return null;

    }

}
新增Controller
@RestController

public class DomainSpiderController {

    private static Logger logger = LoggerFactory.getLogger(DomainSpiderController.class);

    @Autowired

    private DomainSpiderService domainSpiderService;

    /**

     * @param ip 119.75.217.109

     * @return

     */

    @RequestMapping("/spider/{ip}")

    @ResponseBody

    public List<String> domainSpider(@PathVariable("ip") String ip) {

        long startTime = System.currentTimeMillis();

        List<String> domains = domainSpiderService.domainSpiderOfIp138(ip);

        if(domains == null || domains.size() == 0) {

            domains = domainSpiderService.domainSpiderOfAizan(ip);

        }

        long endTime = System.currentTimeMillis();

        logger.info("完成爬虫任务总耗时:{}s", (endTime - startTime) / 1000);

        return domains;

    }

}
启动Spring Boot应用,访问浏览器:http://localhost:8080/spider/119.75.217.109
获得返回结果如下:
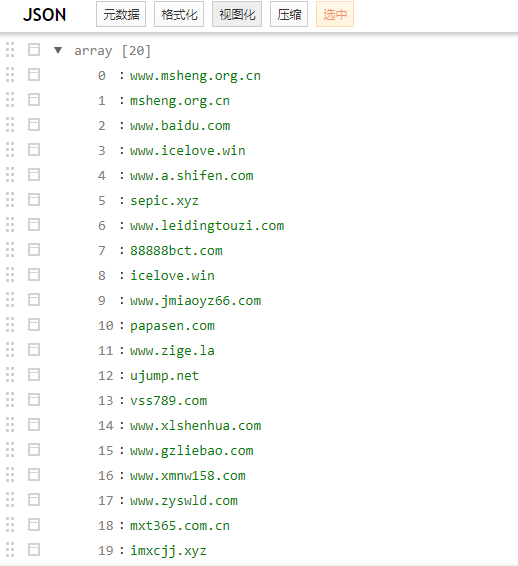
怎么样?是不是很简单?
优化改进:有时候仅仅通过一个网站查询的域名数据可能不太准确,甚至查询不到数据,我们也没法判断谁才是正确的,所以,可以通过爬取多个网站的结果结合起来使用,例如:dns.aizhan.com
提出疑问:这些提供根据IP反查域名的网站,是怎么实现的呢?我咨询过其他人,他们的回答是这些网站收集了很多IP和域名的对应关系,真实情况是这样的吗?
示例源码
- domain-spider
代码已上传至码云和Github上,欢迎下载学习
爬虫实现:根据IP地址反查域名的更多相关文章
- windows下 使用ip地址反查主机名的命令
nbtstat -a [远端或局域网某计算机的IP地址] 可以查询返回远端或局域网某计算机的主机名 C:\Documents and Settings\z00121596>nbtstat -a ...
- 自动更改IP地址反爬虫封锁,支持多线程(转)
8年多爬虫经验的人告诉你,国内ADSL是王道,多申请些线路,分布在多个不同的电信机房,能跨省跨市更好,我这里写好的断线重拨组件,你可以直接使用. ADSL拨号上网使用动态IP地址,每一次拨号得到的IP ...
- ip反查域名的详细信息(多种方法)
不多说,直接上干货! 至于这里怎FQ,很简单,请见我下面的博客! kali 2.0安装 lantern(成功FQ) shadowsocks(简称SSFQ软件)步骤详解 FQ软件lantern-inst ...
- 用淘宝ip地址库查ip
这是一个通过调用淘宝ip地址库实现ip地址查询的功能类 using System; using System.Collections.Generic; using System.Linq; using ...
- .net通过获取客户端IP地址反查出用户的计算机名
这个功能看似很少用到,但又非常实用,看似简单,但又在其中存在很多未知因素造成让人悲痛莫名的负能量... 这是公司内部最近在使用的功能,因为是DHCP,所以有时会根据计算机名做一些统计和权限的设置. 也 ...
- 访问 Tomcat支配项目去除项目名和端口号通过IP地址(或域名)访问
Tomcat去除项目名称和端口号 1. 去除端口号 将端口设为80: <Connector port="80" protocol="HTTP/1.1" c ...
- IP地址与,域名,DNS服务器,端口号的联系与概念
一,什么是IP地址? 每一个联入到Internet的计算机都需要一个世界上独一无二的IP地址,相当于人们的身份证号码! IP地址有A类,B类,C类,D类和E类之分,目前D类和E类都暂时作为保留地址! ...
- 远程拷贝、查看端口、vim常见快捷键、查找替换命令、grep命令、查看存储空间的命令、chkconfig命令、系统自动启动级别、主机名配置、IP地址配置、域名映射、防火墙设置
2.1.远程拷贝 (将/export/servers/hadoop上的文件拷贝到bigdate@192.168.1.1:/export/servers/ ) scp –r /export/server ...
- 本机ip地址怎么查
转自:https://www.192ly.com/basic/local-ip-address-lookup-method.html 百度搜索一下[IP],你就可以轻松看到你的IP地址了,百度出来的 ...
随机推荐
- Unity中AB资源打包简单的脚本
脚本应该放在Editor文件夹下 using System.Collections; using System.Collections.Generic; using UnityEngine; usin ...
- idea安装了Mybaits Plugin插件后,启动不起来了
之前安装了一些插件,谁知道重启完了之后,直接启动不起来了,报错信息如下: cannot load project fatal error initializing plugin com.seven7. ...
- 实践中 XunSearch(讯搜)更新索引方案对比
检测PHP-SDK的运行条件(查看是否支持XunSearch) $prefix/sdk/php/util/RequiredCheck.php $prefix #替换成你的安装目录 使用 XunSe ...
- c语言构建哈希表
/*哈希查找 *哈希函数的构造方法常用的有5种.分别是: *数字分析法 *平方取中法 *分段叠加 *伪随机数 *除留取余法 *这里面除留取余法比较常用 *避免哈希冲突常用的方法有4种: *开放定址法( ...
- 反编译看java for-each循环
java 1.5发行版引入的for-each循环.(引自<Effective Java>中文版第二版 第46条) 如以下对数组列表的for-each循环示例: public class F ...
- MySQL的计算时间差
一.MySQL计算两个日期的时间差 TIMESTAMPDIFF(DAY, datetime1, datetime2); 第一个参数为比较类型,有day, month, year, hour等: 第二个 ...
- 日期类时间类,日期时间类,单例模式,装箱与拆箱,数字类随机数,BigDecimal总结
1.日期类,时间类,日期时间类 初步日期使用方法及格式转换方法(旧方法): 格式://Mon Jul 30 11:26:05 CST 2018 年月日时分秒 CST代表北 ...
- 我的C#跨平台之旅(三):使用Entity Framework开发REST API
添加NuGet引用:EntityFramework 创建实体类:Book.Author 以及数据传输类:BookDTO.BookDetailDTO,代码如下: 创建DbContext类:BookDbC ...
- Python 字符串十六进制流
字符串转十六进制绕过特征检测SQL注入 Python中内置库与出色第三方库的学习 # 字符串转十六进制 mystr = "hello world" print(":&qu ...
- pyqt5安装问题
最近装了下pyqt5,遇到了很多坑,要么是模块没找到,要么是各种ddl出错什么的 后来查了一下,总结一下: 1.pyqt5和python的版本一定匹配,尤其是自己去网上下的pyqt一定要注意适配的版本 ...