
一致性Hash算法(转)
一致性Hash算法提出了在动态变化的Cache环境中,判定哈希算法好坏的四个定义:
1、平衡性(Balance):平衡性是指哈希的结果能够尽可能分布在所有的缓冲(Cache)中去,这样可以使得所有的缓冲空间得到利用。很多哈希算法都能够满足这一条件。
2、单调性(Monotonicity):单调性是指如果已经有一些内容通过哈希分派到了相应的缓冲中,又有新的缓冲加入到系统中。哈希的结果应该能够保证原有已分配的内容可以被映射到原有的或者新的缓冲中去,而不会映射到旧的缓冲集合中的其他缓冲区。
3、分散性(Spread):在分布式环境中,终端有可能看不到所有的缓冲,而只能看到其中的一部分。当终端希望通过哈希过程将内容映射到缓冲上去,由于不同终端所见的缓冲范围有可能不同,从而导致哈希的结果不一致,最终的结果是相同的内容被不同的终端映射到不同的缓冲区中。这种情况显然是应该避免的,因为它导致相同内容被存储到不同缓冲中去,降低了系统存储的效率。分散性的定义就是上述情况发生的严重程度。好的哈希算法应该能够尽量避免不一致的情况发生,也就是尽量降低分散性。
4、负载(Load):负载问题实际上是从另一个角度看待分散性问题。既然不同的终端可能将相同的内容映射到不同的缓冲区中,那么对于一个特定的缓冲区而言,也可能被不同的用户映射到不同的内容。与分散性一样,这种情况也是应当避免的,因此好的哈希算法应能够尽量降低缓冲的负荷。
在分布式集群中,对机器的添加删除,或者机器故障后自动脱落集群这些操作是分布式集群管理最基本的功能。如果采用常用的hash(object)%N算法,那么在有机器添加或者删除后,很多原有的数据就无法找到了,这样严重的违反了单调性原则。
解释使用hash(object)%N,其中N是指N个cache服务器/N个节点为啥不行:
如果N个cache服务器中编号为a的服务器故障了,需要把a从服务器群中移除,这个时候cache服务器的数量就变成了N-1台,那么所有对象(object)映射到cache服务器的计算公式就变成了hash(object)%N-1,对,影响到了所有的对象与cache服务器的映射关系,类似,由于访问加重,需要添加cache服务器,这时候cache服务器是N+1台,映射公式就变成了hash(object)%N+1,这就意味着几乎所有的cache都失效了,对于服务器而言,这是一场灾难,所有访问都会直接冲向后台服务器。
接下来主要讲解一下哈希算法是如何设计的:
环形Hash空间
按照常用的hash算法来将对应的key哈希到一个具有2^32次方个桶的空间中,即0~(2^32)-1的数字空间。现在我们可以将这些数字头尾相连,想象成一个闭合的环形。如下图
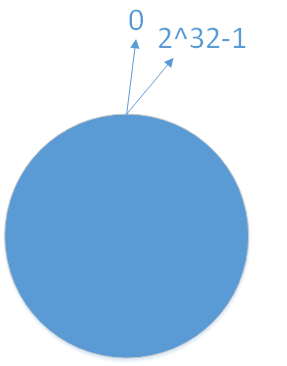
把数据(对象)通过一定的hash算法处理后映射到环上
现在我们将object1、object2、object3、object4四个对象通过特定的Hash函数计算出对应的key值,然后散列到hash换上。如下图:
Hash(object1)=key1;Hash(object2)=key2;Hash(object3)=key3;Hash(object4)=key4;

将机器通过hash算法映射到环上
在采用一致性哈希算法的分布式集群中将新的机器加入,其原理是通过使用与对象存储一样的Hash算法将机器也映射到换种(一般情况下对机器的hash计算是采用机器的IP或者唯一的别名作为输入值),然后以顺时针的方向计算,将所有对象存储到离自己最近的机器中。
假设现在有NODE1,NODE2,NODE3三台机器中,通过hash算法得到对应的KEY值,映射到环中,其示意图如下:
Hash(NODE1)=KEY1;Hash(NODE2)=KEY2;Hash(NODE3)=KEY3;
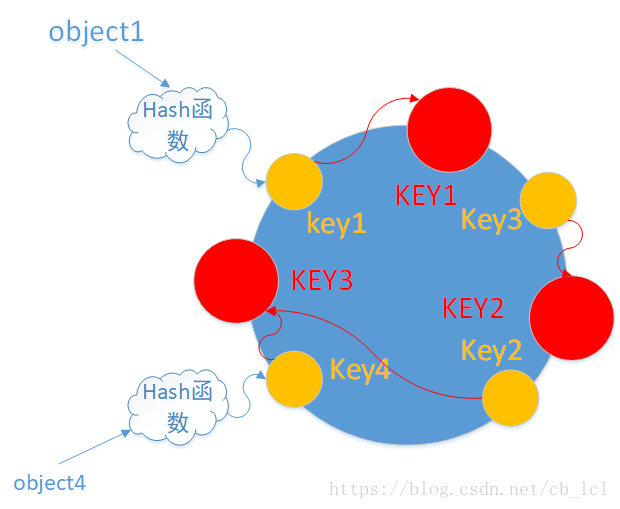
通过上图可以看出对象与机器处于同一个哈希空间中,这样按顺时针转动object1(对象)存储到了NODE1(机器)中,object3(对象)存储到了NODE2(机器)中,object2、object4(对象)存储到了NODE3(机器)中。在这样的部署环境中,hash环是不会变更的,因此,通过算出对象的hash值就能快速的定位到对应的机器中,这样就能找到对象真正的存储位置了。
机器删除与添加
普通hash求余算法最为不妥的地方就是在有机器的添加与删除以后会造成大量的对象存储位置的失效,这样就大大的不满足单调性了。下面来分析一下一致性哈希算法是如何处理的。
1、节点(机器)的删除
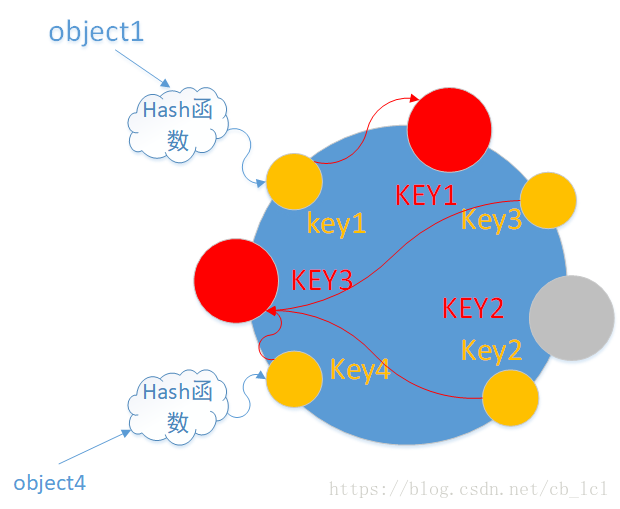
以上面的分布式集群为例,如果NODE2出现故障被删除了,那么按照顺时针迁移的方法,object3将会被迁移到NODE3中,这样仅仅是object3的映射位置发生了变化,其他的对象没有任何的变动,如下图:
2、节点(机器)的添加
如果往集群中添加一个新的节点NODE4,通过对应的Hash算法得到KEY4,并映射到环中,如下图:
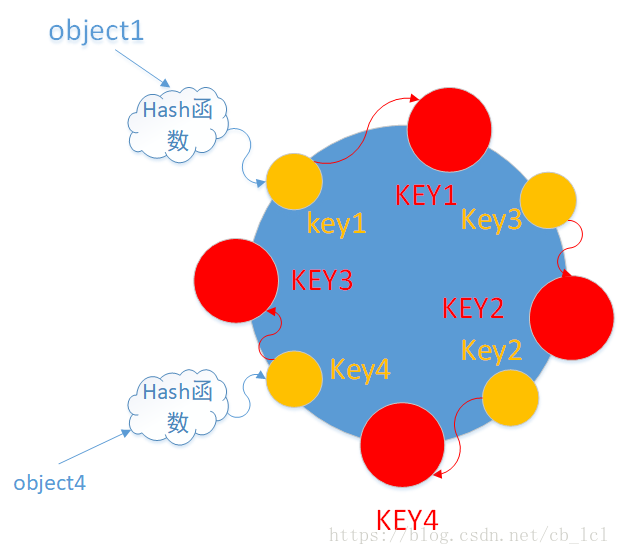
通过按照顺时针迁移的规则,那么object2被迁移到NODE4中,其他对象还保持这原有的存储位置。通过对节点的添加和删除的分析,一致性哈希算法在保持了单调性的同时,还是数据的迁移达到了最小,这样的算法对分布式集群来说非常合适的,避免了大量收数据迁移,减少了服务器的压力。
平衡性
根据上面的图解分析,一致性哈希算法满足了单调性和负载均衡的特性以及一般hash算法的分散性,但这还并不能当做其被广泛应用的原由,因为缺少了平衡性。下面将分析一致性哈希算法是如何满足平衡性的。hash算法是不保证平衡性的,如上面只部署了NODE1和NODE3的情况(NODE2被删除的图),object1存储在NODE1中,而object2、object3、object4都存储在NODE3中,这样就造成了非常不平衡的状态。在一致性哈希算法中,为了尽可能的满足平衡性,其引入了虚拟节点。
何为虚拟节点?虚拟节点(Virtual node)是实际节点(机器)在hash空间的复制品(replica),一个实际节点对应了若干个“虚拟节点”,这个对应个数也称为“复制个数”,“虚拟节点”在hash空间中以hash值排列。
在上面只部署了NODE1和NODE3的情况(NODE2被删除的图)为例,之前的对象在机器上的分布很不均衡,现在我们以2个副本(每个节点复制2个)为例,这样整个hash环就存在4个虚拟节点,最后对象映射的关系图如下:
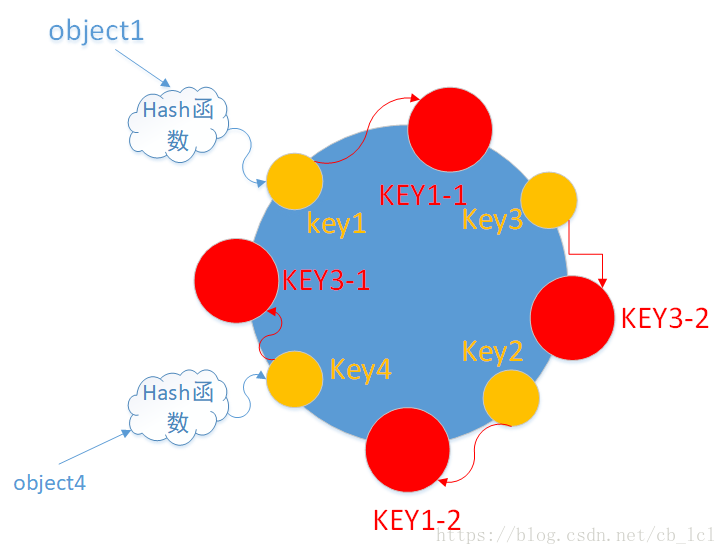
根据上图可知对象的映射关系:object1->NODE1-1,object2->NODE1-2 ,object3->NODE3-2,object4->NODE3-1,通过虚拟节点的引入,对象的分布就比较均衡了。那么在实际操作中,真正的对象查询是如何工作的呢?对象从hash到虚拟节点到实际节点的转换如下图:
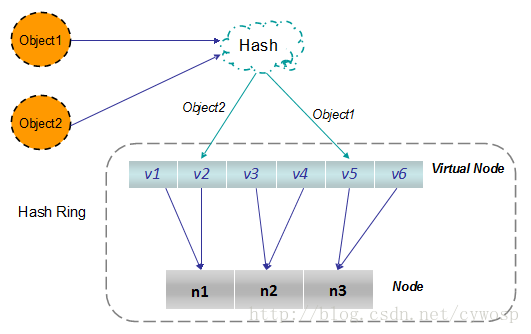
虚拟节点”的hash计算可以采用对应节点的IP地址加数字后缀的方式。例如假设NODE1的IP地址为192.168.1.100。引入“虚拟节点”前,计算 cache A 的 hash 值:
Hash(“192.168.1.100”);
引入“虚拟节点”后,计算“虚拟节”点NODE1-1和NODE1-2的hash值:
Hash(“192.168.1.100#1”); // NODE1-1
Hash(“192.168.1.100#2”); // NODE1-2
原文:https://blog.csdn.net/cb_lcl/article/details/81448570
一致性Hash算法(转)的更多相关文章
- 对一致性Hash算法,Java代码实现的深入研究
一致性Hash算法 关于一致性Hash算法,在我之前的博文中已经有多次提到了,MemCache超详细解读一文中"一致性Hash算法"部分,对于为什么要使用一致性Hash算法.一致性 ...
- 一致性hash算法详解
转载请说明出处:http://blog.csdn.net/cywosp/article/details/23397179 一致性哈希算法在1997年由麻省理工学院提出的一种分布式哈希(DHT) ...
- 一致性hash算法简介
一致性哈希算法在1997年由麻省理工学院提出的一种分布式哈希(DHT)实现算法,设计目标是为了解决因特网中的热点(Hot spot)问题,初衷和CARP十分类似.一致性哈希修正了CARP使用的简单哈希 ...
- 分布式缓存技术memcached学习(四)—— 一致性hash算法原理
分布式一致性hash算法简介 当你看到“分布式一致性hash算法”这个词时,第一时间可能会问,什么是分布式,什么是一致性,hash又是什么.在分析分布式一致性hash算法原理之前,我们先来了解一下这几 ...
- 一致性 hash 算法( consistent hashing )a
一致性 hash 算法( consistent hashing ) 张亮 consistent hashing 算法早在 1997 年就在论文 Consistent hashing and rando ...
- 一致性hash算法简介与代码实现
一.简介: 一致性hash算法提出了在动态变化的Cache环境中,判定哈希算法好坏的四个定义: 1.平衡性(Balance) 2.单调性(Monotonicity) 3.分散性(Spread) 4.负 ...
- memcache的一致性hash算法使用
一.概述 1.我们的memcache客户端(这里我看的spymemcache的源码),使用了一致性hash算法ketama进行数据存储节点的选择.与常规的hash算法思路不同,只是对我们要存储数据的k ...
- 一致性Hash算法在Redis分布式中的使用
由于redis是单点,但是项目中不可避免的会使用多台Redis缓存服务器,那么怎么把缓存的Key均匀的映射到多台Redis服务器上,且随着缓存服务器的增加或减少时做到最小化的减少缓存Key的命中率呢? ...
- 【转载】一致性hash算法释义
http://www.cnblogs.com/haippy/archive/2011/12/10/2282943.html 一致性Hash算法背景 一致性哈希算法在1997年由麻省理工学院的Karge ...
- 一致性Hash算法在Memcached中的应用
前言 大家应该都知道Memcached要想实现分布式只能在客户端来完成,目前比较流行的是通过一致性hash算法来实现.常规的方法是将server的hash值与server的总台数进行求余,即hash% ...
随机推荐
- postman批量调用接口并发测试
本文出自:https://www.cnblogs.com/2186009311CFF/p/11425913.html 接口测试在开发中很容易遇到,下面是请教别人学会的并发测试,希望能帮到需要用到的你, ...
- php将base64字符串转换为图片
昨天用一个js插件 [链接]: http://www.erdangjiade.com/js/910.html 实行了图片裁剪并预览,不过它生产的图片资源是一个base64字符串,不好保存后来在网上找到 ...
- SecureRandom的坑
之前写随机数的时候一直用SecureRandom.getInstanceStrong()方法生成SecureRandom实例,进而调用其各种next方法.突然有一次,发现next方法卡住了, 每一次调 ...
- 实习模块vue+java小型全栈开发(三)
实习模块vue+java小型全栈开发(三) --dx 背景 首先,先给自己一个答案:这篇博客我定义为(三),因为之前的两个模块页面,内容都是一样的,但是被改了几次需求,就一直拖着没有上传. 今天是真正 ...
- 用Java 实现断点续传 (HTTP)
在web项目中上传文件夹现在已经成为了一个主流的需求.在OA,或者企业ERP系统中都有类似的需求.上传文件夹并且保留层级结构能够对用户行成很好的引导,用户使用起来也更方便.能够提供更高级的应用支撑. ...
- #418 Div2 Problem B An express train to reveries (构造 || 全排列序列特性)
题目链接:http://codeforces.com/contest/814/problem/B 题意 : 有一个给出两个含有 n 个数的序列 a 和 b, 这两个序列和(1~n)的其中一个全排列序列 ...
- SpringCloud 入门知识篇
SpringCloud 入门 springcloud 学习 7天学会springcloud 教程 https://www.cnblogs.com/skyblog/category/738524.htm ...
- Html !!!了解一下
1.什么是超文本 超文本:就是指页面内可以包含图片,链接,甚至音乐,程序等非文字元素; 最常用的超文本格式:超文本标记语言(标记通用语言的下个一个应用)和富文本格式 超文本语言的特点: 简易性:超文本 ...
- lombok效率神奇使用
Lombok效率神器 标签(空格分隔): Java Lombok简介及使用 Lombok 是一种 Java实用工具,可用来帮助开发人员消除Java的冗长,尤其是对于简单的Java对象(POJO), 它 ...
- [BZOJ2839]:集合计数(组合数学+容斥)
题目传送门 题目描述 .(是质数喔~) 输入格式 一行两个整数N,K. 输出格式 一行为答案. 样例 样例输入: 3 2 样例输出: 样例说明 假设原集合为{A,B,C} 则满足条件的方案为:{AB, ...