
【大数据应用技术】作业九|安装关系型数据库MySQL 安装大数据处理框架Hadoop
本次作业的要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161
1.安装MySql
按ctrl+alt+t打开终端窗口,安装mysql需要输入命令:sudo apt-get install mysql-server
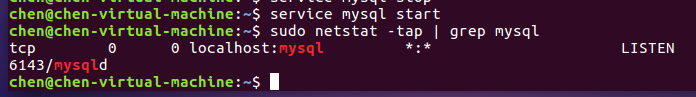
输入命令:service mysql start #启动mysql
输入命令:sudo netstat -tap | grep mysql #查看mysql是否启动成功,mysql结点处于LISTEN状态表明启动成功
如下图所示:
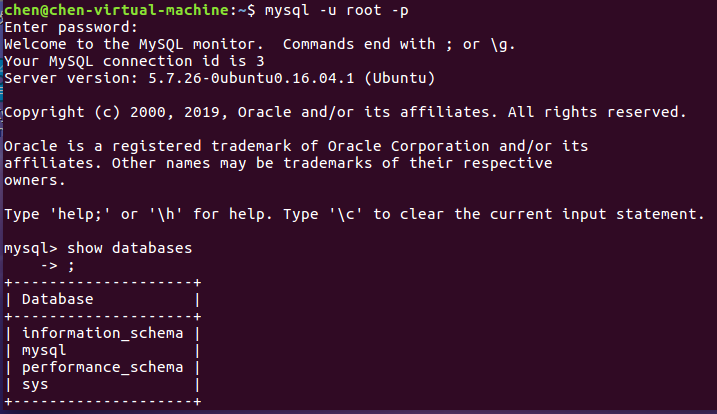
输入命令:mysql -u root -p #进入mysql shell界面
输入命令:show databases; #显示数据库
如下图所示:
2.windows 与 虚拟机互传文件
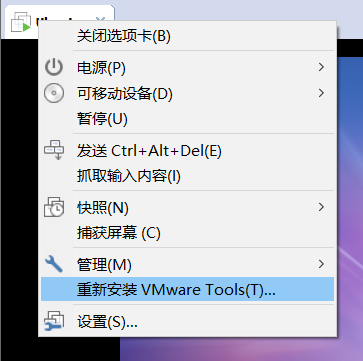
为了使windows与虚拟机互传文件,所以需要安装vmware tools工具,安装步骤可见后面部分:https://blog.csdn.net/weixin_42305895/article/details/89879220
如图所示,已经成功安装vmware tools工具。
3.安装Hadoop
我已经成功安装了hadoop,伪分布式hadoop的安装教程可见:https://blog.csdn.net/weixin_42305895/article/details/89925119
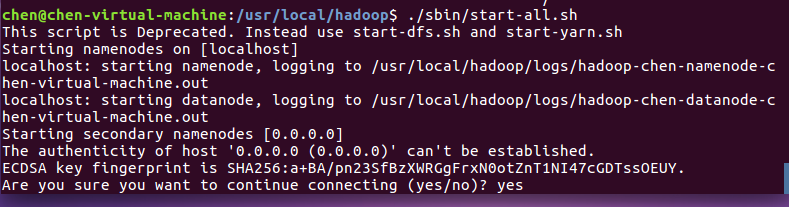
启动hadoop,如下图所示。
输入jps可查看hadoop是否启动成功,如果启动成功则会出现如下进程:“NameNode”,“DataNode”,“SecondaryNameNode”,如下图所示。

关闭hadoop,如下图所示。

4. 简述Hadoop平台的起源、发展历史与应用现状。
(1)起源
(2)发展历史
(3)应用现状
hadoop的应用现状很广泛,这里我就不一一描述了,大家可以去看国外、国内Hadoop的应用现状,描述的比较详细。
【大数据应用技术】作业九|安装关系型数据库MySQL 安装大数据处理框架Hadoop的更多相关文章
- 安装关系型数据库MySQL和大数据处理框架Hadoop
1. 简述Hadoop平台的起源.发展历史与应用现状.列举发展过程中重要的事件.主要版本.主要厂商:国内外Hadoop应用的典型案例. (1)Hadoop的介绍: Hadoop最早起源于Nutch,N ...
- 【大数据作业九】安装关系型数据库MySQL 安装大数据处理框架Hadoop
作业要求:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 4.简述Hadoop平台的起源.发展历史与应用现状. 列举发展过程中 ...
- 【大数据】安装关系型数据库MySQL安装大数据处理框架Hadoop
作业来源于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 1. 简述Hadoop平台的起源.发展历史与应用现状. 列举发展过 ...
- 【大数据】安装关系型数据库MySQL 安装大数据处理框架Hadoop
作业要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 1.安装Mysql 使用命令 sudo apt-get ins ...
- 安装关系型数据库MySQL 安装大数据处理框架Hadoop
作业要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 1.Hadoop的介绍 Hadoop最早起源于Nutch.Nut ...
- 作业——09 安装关系型数据库MySQL 安装大数据处理框架Hadoop
作业的要求来自于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 简述Hadoop平台的起源.发展历史与应用现状. 起源: 2 ...
- AI加持的阿里云飞天大数据平台技术揭秘
摘要:2019云栖大会大数据&AI专场,阿里云智能计算平台事业部研究员关涛.资深专家徐晟来为我们分享<AI加持的阿里云飞天大数据平台技术揭秘>.本文主要讲了三大部分,一是原创技术优 ...
- 中国大数据六大技术变迁记(CSDN)
大会召开前期,特别梳理了历届大会亮点以记录中国大数据技术领域发展历程,并立足当下生态圈现状对即将召开的BDTC 2014进行展望: 追本溯源,悉大数据六大技术变迁 伴随着大数据技术大会的发展,我们亲历 ...
- 大数据 --> 大数据关键技术
大数据关键技术 大数据环境下数据来源非常丰富且数据类型多样,存储和分析挖掘的数据量庞大,对数据展现的要求较高,并且很看重数据处理的高效性和可用性. 传统数据处理方法的不足 传统的数据采集来源单一,且存 ...
随机推荐
- Shallow copy and Deep copy
Shallow copy and Deep copy 第一部分: 一.来自wikipidia的解释: Shallow copy One method of copying an object is t ...
- nginx配置访问xx.com跳转www.xx.com
二.在nginx里面配置 rewrite 规则.打开 Nginx.conf 文件找到server配置段:[以下是我的server配置段] 禁止IP地址访问 server{ listen 80 defa ...
- 如何使用GUID硬盘分区格式安装新windows系统
全局唯一标识分区表(GUID Partition Table,缩写:GPT)是一个实体硬盘的分区结构.目前硬盘格式有两种,一种MBR,另一个就是GUID.一般电脑买过来是windows7以上,比如wi ...
- jhipster技术栈研究
背景: 公司新的微服务项目都用jhipster脚手架来开发,这篇博客是jhipster里面涉及到技术的汇总目录 一.官方文档中涉及到的技术栈 前端技术栈 Angular / React / Vue R ...
- css浮动float详解
https://www.cnblogs.com/iyangyuan/archive/2013/03/27/2983813.html
- session有效期设置的两种方式
/**session有效期设置的两种方式: * 1.代码设置:session.setMaxInactiveInterval(30);//单位:秒.30秒有效期,默认30分钟. * 2.web.xml中 ...
- IDEA如何配置tomcat及建一个web项目
需求:项目工程可能别人已经建好了,我需要把项目导入到自己的IDEA并配置tomcat运行; 准备工作:1.本地的tomat服务器 2.IDEA工具 3.JDK 步骤: 1.点击Run -> Ed ...
- geopy 在python中的使用
https://blog.csdn.net/learn_tech/article/details/80756788 2018年06月21日 10:35:52 learn_tech 阅读数:1182 ...
- Centos7-ssh免密登录
生成密钥 ssh-keygen 拷贝密钥 ssh-copy-id #目的IP或域名 检查配置 cat /root/.ssh/authorized_keys 登录测试 ssh ip
- 项目Alpha冲刺 7
作业描述 课程: 软件工程1916|W(福州大学) 作业要求: 项目Alpha冲刺(团队) 团队名称: 火鸡堂 作业目标: 介绍第7天冲刺的项目进展.问题困难和心得体会 1.团队信息 队名:火鸡堂 队 ...