
【大数据作业九】安装关系型数据库MySQL 安装大数据处理框架Hadoop
作业要求:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161
4.简述Hadoop平台的起源、发展历史与应用现状。
列举发展过程中重要的事件、主要版本、主要厂商;
国内外Hadoop应用的典型案例。
Hadoop发展史
一、重要的事件:
2004年——— 最初的版本(现在称为HDFS和MapReduce)由Doug Cutting和Mike Cafarella开始实施。
2005年12月——— Nutch移植到新的框架,Hadoop在20个节点上稳定运行。
2006年2月——— Apache Hadoop项目正式启动以支持MapReduce和HDFS的独立发展。2006年12月— 标准排序在20个节点上运行1.8个小时,100个节点3.3小时,500个节点5.2小时,900个节点7.8个小时。
2008年11月——— Google宣布其MapReduce用68秒对1TB的程序进行排序
2008年——— 淘宝开始投入研究基于Hadoop的系统–云梯。云梯总容量约9.3PB,共有1100台机器,每天处理18000道作业,扫描500TB数据。
2009年7月——— MapReduce 和 Hadoop Distributed File System (HDFS) 成为Hadoop项目的独立子项目。
2010年5月——— IBM提供了基于Hadoop 的大数据分析软件——InfoSphere BigInsights,包括基础版和企业版。
2011年5月——— Mapr Technologies公司推出分布式文件系统和MapReduce引擎——MapR Distribution for Apache Hadoop。
2011年5月——— HCatalog 1.0发布。该项目由Hortonworks 在2010年3月份提出,HCatalog主要用于解决数据存储、元数据的问题,主要解决HDFS的瓶颈,它提供了一个地方来存储数据的状态信息,这使得 数据清理和归档工具可以很容易的进行处理。
2011年5月——— EMC为客户推出一种新的基于开源Hadoop解决方案的数据中心设备——GreenPlum HD,以助其满足客户日益增长的数据分析需求并加快利用开源数据分析软件。Greenplum是EMC在2010年7月收购的一家开源数据仓库公司。
2011年6月——— Calxeda公司(之前公司的名字是Smooth-Stone)发起了“开拓者行动”,一个由10家软件公司组成的团队将为基于Calxeda即将推出的ARM系统上芯片设计的服务器提供支持。并为Hadoop提供低功耗服务器技术。
2011年7月——— Yahoo!和硅谷风险投资公司 Benchmark Capital创建了Hortonworks 公司,旨在让Hadoop更加鲁棒(可靠),并让企业用户更容易安装、管理和使用Hadoop。
2011年8月——— Dell与Cloudera联合推出Hadoop解决方案——Cloudera Enterprise。Cloudera Enterprise基于Dell PowerEdge C2100机架服务器以及Dell PowerConnect 6248以太网交换机
二、主要版本:
1.x:该版本是由0.20.x发行版系列的延续
2.x:该版本是由0.23.x发行版系列的延续
Hadoop1.x 指的是:1.x(0.20.x)、0.21、0.22
Hadoop2.x 指的是:2.x、0.23.x
三、主要厂商:
(1)IBM(国际商业机器公司)或万国商业机器公司,简称IBM(International Business Machines Corporation)。总公司在纽约州阿蒙克市。1911年托马斯·沃森创立于美国,是全球最大的信息技术和业务解决方案公司,拥有全球雇员 30多万人,业务遍及160多个国家和地区。
(2)EMC(易安信)为一家美国信息存储资讯科技公司, 主要业务为信息存储及管理产品、服务和解决方案。EMC公司创建于1979年,总部在马萨诸塞州霍普金顿市。2003年,EMC收购了VMware。2015年10月,EMC被DELL收购。
(3)甲骨文公司,全称甲骨文股份有限公司(甲骨文软件系统有限公司),是全球最大的企业级软件公司,总部位于美国加利福尼亚州的红木滩。1989年正式进入中国市场。2013年,甲骨文已超越IBM,成为继Microsoft后全球第二大软件公司。

(4)Cloudera成立于2008年,在企业和大型机构在寻求解决棘手的大数据问题时,往往会使用开源软件基础架构Hadoop的服务。
四、典型案例
(1)Yahoo:Yahoo是Hadoop的最大支持者,截至2012年,Yahoo的Hadoop机器总节点数目超过420000个,有超过10万的核心CPU在运行Hadoop。最大的一个单Master节点集群有4500个节点(每个节点双路4核心CPUboxesw,4×1TB磁盘,16GBRAM)。总的集群存储容量大于350PB,每月提交的作业数目超过1000万个,在Pig中超过60%的Hadoop作业是使用Pig编写提交的。
(2)IBM:IBM蓝云也利用Hadoop来构建云基础设施。IBM蓝云使用的技术包括:Xen和PowerVM虚拟化的Linux操作系统映像及Hadoop并行工作量调度,并发布了自己的Hadoop发行版及大数据解决方案。
(3)Adobe:Adobe主要使用Hadoop及HBase,同于支撑社会服务计算,以及结构化的数据存储和处理。大约有超过30个节点的Hadoop-HBase生产集群。Adobe将数据直接持续地存储在HBase中,并以HBase作为数据源运行MapReduce作业处理,然后将其运行结果直接存到HBase或外部系统。Adobe在2008年10月就已经将Hadoop和HBase应用于生产集群。
(4)Facebook:Facebook使用Hadoop存储内部日志与多维数据,并以此作为报告、分析和机器学习的数据源。目前Hadoop集群的机器节点超过1400台,共计11?200个核心CPU,超过15PB原始存储容量,每个商用机器节点配置了8核CPU,12TB数据存储,主要使用StreamingAPI和JavaAPI编程接口。Facebook同时在Hadoop基础上建立了一个名为Hive的高级数据仓库框架,Hive已经正式成为基于Hadoop的Apache一级项目。此外,还开发了HDFS上的FUSE实现。
(5)Datagraph:Datagraph主要使用Hadoop批量处理大量的RDF数据集,尤其是利用Hadoop对RDF数据建立索引。Datagraph也使用Hadoop为客户执行长时间运行的离线SPARQL查询。Datagraph是使用AmazonS3和Cassandra存储RDF数据输入和输出文件的,并已经开发了一个基于MapReduce处理RDF数据的Ruby框架——RDFgrid。
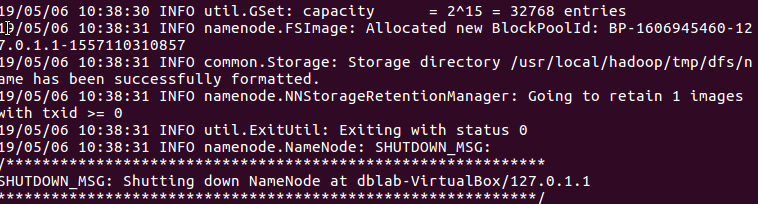
5. 下次上课之前,必须成功完成Hadoop的安装与配置。
安装截图:
程序执行成功的输出信息及其程序的执行结果:
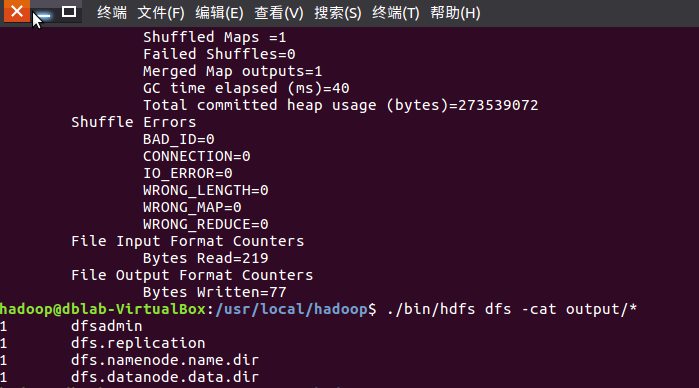
配置环境:
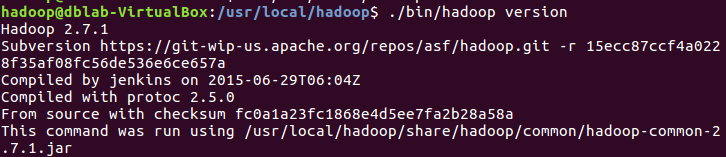
查看安装成功:

NameNode的格式化成功:
【大数据作业九】安装关系型数据库MySQL 安装大数据处理框架Hadoop的更多相关文章
- 安装关系型数据库MySQL 安装大数据处理框架Hadoop
作业要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 1.Hadoop的介绍 Hadoop最早起源于Nutch.Nut ...
- 【大数据应用技术】作业九|安装关系型数据库MySQL 安装大数据处理框架Hadoop
本次作业的要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 1.安装MySql 按ctrl+alt+t打开终端窗口,安 ...
- 【大数据】安装关系型数据库MySQL安装大数据处理框架Hadoop
作业来源于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 1. 简述Hadoop平台的起源.发展历史与应用现状. 列举发展过 ...
- 【大数据】安装关系型数据库MySQL 安装大数据处理框架Hadoop
作业要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 1.安装Mysql 使用命令 sudo apt-get ins ...
- 安装关系型数据库MySQL和大数据处理框架Hadoop
1. 简述Hadoop平台的起源.发展历史与应用现状.列举发展过程中重要的事件.主要版本.主要厂商:国内外Hadoop应用的典型案例. (1)Hadoop的介绍: Hadoop最早起源于Nutch,N ...
- 作业——09 安装关系型数据库MySQL 安装大数据处理框架Hadoop
作业的要求来自于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 简述Hadoop平台的起源.发展历史与应用现状. 起源: 2 ...
- Hadoop生态组件Hive,Sqoop安装及Sqoop从HDFS/hive抽取数据到关系型数据库Mysql
一般Hive依赖关系型数据库Mysql,故先安装Mysql $: yum install mysql-server mysql-client [yum安装] $: /etc/init.d/mysqld ...
- 大数据时代的数据存储,非关系型数据库MongoDB
在过去的很长一段时间中,关系型数据库(Relational Database Management System)一直是最主流的数据库解决方案,他运用真实世界中事物与关系来解释数据库中抽象的数据架构. ...
- 大数据时代的数据存储,非关系型数据库MongoDB(一)
原文地址:http://www.cnblogs.com/mokafamily/p/4076954.html 爆炸式发展的NoSQL技术 在过去的很长一段时间中,关系型数据库(Relational Da ...
随机推荐
- Js判断对象是否是数组的方法
1.ECMAScript5中有一个现成的方法:Array.isArray(). var obj = {1:[1],2:[2]}, arr = [1], str = "1"; Arr ...
- JavaScript克隆数组
/** * 克隆数组 * @param arr */ function cloneArray(arr){ var _arr=[]; for(var i=0;i<arr.length;i++){ ...
- opencv——图像掩码操作
使用opencv通过掩码去扣取图像中感兴趣的区域 步骤: 1.读取一张图片 2.转换颜色格式为hsv 3.设置要扣取区域颜色的上下门限 4.从原始图像中获取感兴趣区域的掩码 5.使用掩码和原始图像做云 ...
- Windows定时任务下载linux服务器批量文件到本地
编写批文件 1.1 编写main.bat文件 E: cd logs ftp -n -s:"E:\logs\mget.bat" 1.2 编写mget.bat文件 open ip地址 ...
- Linux必知必会--grep
花更少的时间,去验证一件事情:你到底是富翁,还是贫民. --一位历经沧桑的炒客 转自:https://man.linuxde.net/grep grep命令 grep(global search re ...
- Webmin<=1.920 RCE 漏洞复现
0x00 前言 本来前一阵就想复现来着,但是官网的版本已经更新了,直到今天才发现Docker上有环境,才进行了复现 0x01影响版本 Webmin<=1.920 0x02 环境搭建 dock ...
- scrapy框架爬取智联招聘网站上深圳地区python岗位信息。
爬取字段,公司名称,职位名称,公司详情的链接,薪资待遇,要求的工作经验年限 1,items中定义爬取字段 import scrapy class ZhilianzhaopinItem(scrapy.I ...
- tkinter改进了随机显示图片
随机显示,还加了圆圈,这样感觉更好点. from django.test import TestCase # Create your tests here. import random import ...
- Java线程状态、线程start方法源码、多线程、Java线程池、如何停止一个线程
下面将依次介绍: 1. 线程状态.Java线程状态和线程池状态 2. start方法源码 3. 什么是线程池? 4. 线程池的工作原理和使用线程池的好处 5. ThreadPoolExecutor中的 ...
- poj1734 Sightseeing trip(Floyd求无向图最小环)
#include <iostream> #include <cstring> #include <cstdio> #include <algorithm> ...