
爬取w3c课程—Urllib库使用
爬虫原理
浏览器获取网页内容的步骤:浏览器提交请求、下载网页代码、解析成页面,爬虫要做的就是:
- 模拟浏览器发送请求:通过HTTP库向目标站点发起请求Request,请求可以包含额外的header等信息,等待服务器响应
- 获取响应内容:如果服务器正常响应,会得到一个响应Response,响应的内容便是所要获取的页面内容,类型可能是HTML,Json字符串,二进制数据(图片或者视频)等
- 解析响应内容:获取响应内容后,解析各种数据,如:解析html数据:正则表达式,第三方解析库,解析json数据:json模块,解析二进制数据:进一步处理或以wb的方式写入文件
- 保存数据:保存为文本,数据库,或者保存特定格式的文件
简单例子:利用Urllib库爬取w3c网站教程
1、urllib的request模块可以非常方便地抓取URL内容,也就是发送一个GET请求到指定的页面,然后返回HTTP的响应:例如,对百度的一个w3c发送一个GET请求,并返回响应:
# coding:utf-8

import urllib.request

my_url='https://www.w3cschool.cn/tutorial'#要获取课程的网址

page = urllib.request.urlopen(my_url)

html = page.read().decode('utf-8')

print(html)
把发送一个GET请求到指定的页面,返回HTTP的响应写成一个函数:
def get_html(url):#访问url

    page = urllib.request.urlopen(url)

    html = page.read().decode('utf-8')

    return html
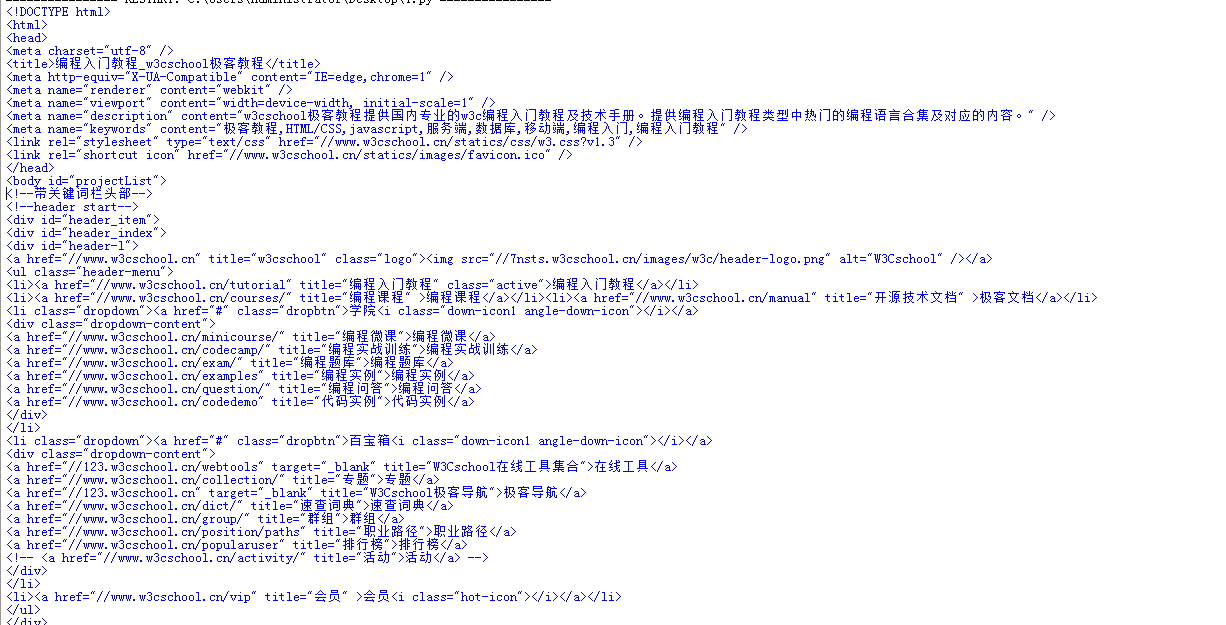
将返回如下内容,这与在浏览器查看源码看到的是一样的,接下来可以根据返回的内容进行解析:
2、利用正则表达式的分组提取课程名称、课程简介、课程链接,导入python里面的re库
reg = r'<a href="([\s\S]*?)" title=[\s\S]*?<h4>(.+)</h4>\n<p>([\s\S]*?)</p>'#运用正则表达式,分组提取数据

reg_tutorial = re.compile(reg)#编译一下正则表达式,运行更快

tutorial_list = reg_tutorial.findall(get_html(my_url))#进行匹配,
到现在代码如下:
# coding:utf-8

import urllib.request

import re

my_url='https://www.w3cschool.cn/tutorial'#要获取课程的网址

def get_html(url):#访问url

    page = urllib.request.urlopen(url)

    html = page.read().decode('utf-8')

    return html

reg = r'<a href="([\s\S]*?)" title=[\s\S]*?<h4>(.+)</h4>\n<p>([\s\S]*?)</p>'#运用正则表达式,分组提取数据

reg_tutorial = re.compile(reg)#编译一下正则表达式,运行更快

tutorial_list = reg_tutorial.findall(get_html(my_url))#进行匹配

print("一共有课程数:" + str(len(tutorial_list)))#打印出有多少课程

for i in range(len(tutorial_list)):#把课程名称、课程简介、课程链接写到excel,python里面excel从0开始计算

    print (tutorial_list[i])
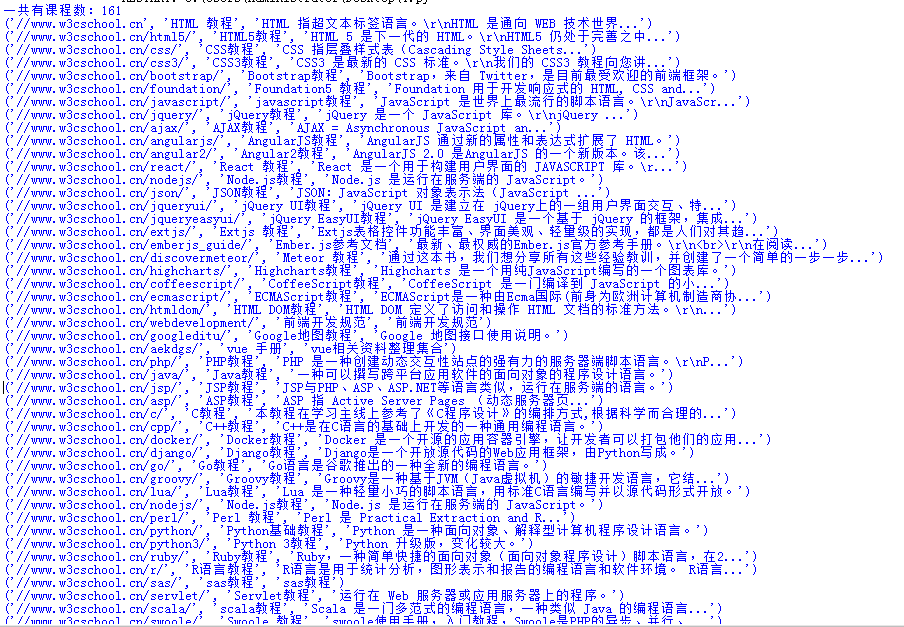
运行,打印结果:
3、保存数据,保存数据到excel里面,用到excel第三方库xlwt,也可以只用openpyxl,库的使用可以参照官网:http://www.python-excel.org/
本次需要新建一个Excel,把课程名称、课程简介、课程链接写到Excel里面,课程链接用xlwt.Formula设置超链接,Excel第一行设置为宋体,加粗,写一些课程内容外的东西
import xlwt

excel_path=r'tutorial.xlsx'#excel的路径

book = xlwt.Workbook(encoding='utf-8', style_compression=0)# 创建一个Workbook对象,这就相当于创建了一个Excel文件

sheet = book.add_sheet('课程',cell_overwrite_ok=True)# 添加表

style = xlwt.XFStyle()#初始化样式

font = xlwt.Font()#创建字体

font.name = '宋体'#指定字体名字

font.bold = True#字体加粗

style.font = font#将该font设定为style的字体

sheet.write(0, 0, '序号',style)#用之前的style格式写第一行,行、列从0开始计算

sheet.write(0, 1, '课程',style)

sheet.write(0, 2, '简介',style)

sheet.write(0, 3, '课程链接',style)
写课程内容到Excel
for i in range(len(tutorial_list)):#把课程名称、课程简介、课程链接写到excel,python里面excel从0开始计算

    print (tutorial_list[i])

    sheet.write(i+1, 0, i+1)

    sheet.write(i+1, 1, tutorial_list[i][1])

    sheet.write(i+1, 2, tutorial_list[i][2])

    sheet.write(i+1, 3, xlwt.Formula("HYPERLINK(" +'"'+"https:" + tutorial_list[i][0]+'"'+')'))#把链接写进去,并用xlwt.Formula设置超链接

book.save(excel_path)#保存到excel
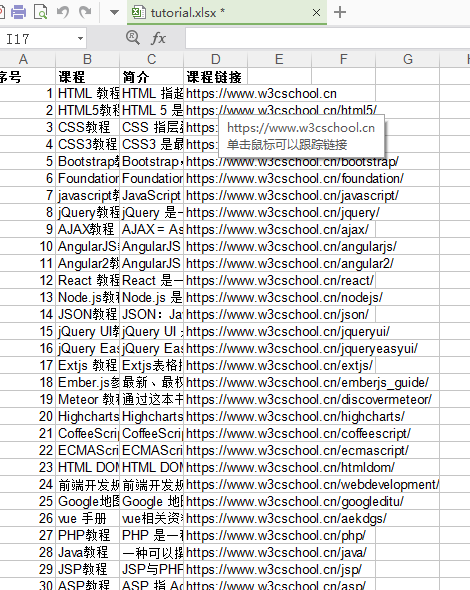
Excel内容:
全部代码如下:
# coding:utf-8

import urllib.request

import re

import xlwt

excel_path=r'tutorial.xlsx'#excel的路径

my_url='https://www.w3cschool.cn/tutorial'#要获取课程的网址

book = xlwt.Workbook(encoding='utf-8', style_compression=0)# 创建一个Workbook对象,这就相当于创建了一个Excel文件

sheet = book.add_sheet('课程',cell_overwrite_ok=True)# 添加表

style = xlwt.XFStyle()#初始化样式

font = xlwt.Font()#创建字体

font.name = '宋体'#指定字体名字

font.bold = True#字体加粗

style.font = font#将该font设定为style的字体

sheet.write(0, 0, '序号',style)#用之前的style格式写第一行,行、列从0开始计算

sheet.write(0, 1, '课程',style)

sheet.write(0, 2, '简介',style)

sheet.write(0, 3, '课程链接',style)

def get_html(url):#访问url

    page = urllib.request.urlopen(url)

    html = page.read().decode('utf-8')

    return html

reg = r'<a href="([\s\S]*?)" title=[\s\S]*?<h4>(.+)</h4>\n<p>([\s\S]*?)</p>'#运用正则表达式,分组提取数据

reg_tutorial = re.compile(reg)#编译一下正则表达式,运行更快

tutorial_list = reg_tutorial.findall(get_html(my_url))#进行匹配

print("一共有课程数:" + str(len(tutorial_list)))#打印出有多少课程

for i in range(len(tutorial_list)):#把课程名称、课程简介、课程链接写到excel,python里面excel从0开始计算

    print (tutorial_list[i])

    sheet.write(i+1, 0, i+1)

    sheet.write(i+1, 1, tutorial_list[i][1])

    sheet.write(i+1, 2, tutorial_list[i][2])

    sheet.write(i+1, 3, xlwt.Formula("HYPERLINK(" +'"'+"https:" + tutorial_list[i][0]+'"'+')'))#把链接写进去,并用xlwt.Formula设置超链接

book.save(excel_path)#保存到excel
爬取w3c课程—Urllib库使用的更多相关文章
- python爬取course课程的信息
目录 1.大模块页面 2.每个大模块中小模块的简单信息 3.每个小课程的详细信息 4.爬取所有评论 @ 这几天爬取了course动态网页的课程信息,有关数据分析,机器学习,还有概率论和数理统计课程 ...
- python爬取网站数据保存使用的方法
这篇文章主要介绍了使用Python从网上爬取特定属性数据保存的方法,其中解决了编码问题和如何使用正则匹配数据的方法,详情看下文 编码问题因为涉及到中文,所以必然地涉及到了编码的问题,这一次借这 ...
- python爬虫从入门到放弃(三)之 Urllib库的基本使用
官方文档地址:https://docs.python.org/3/library/urllib.html 什么是Urllib Urllib是python内置的HTTP请求库包括以下模块urllib.r ...
- scrapy框架 + selenium 爬取豆瓣电影top250......
废话不说,直接上代码..... 目录结构 items.py import scrapy class DoubanCrawlerItem(scrapy.Item): # 电影名称 movieName = ...
- 爬虫常用的 urllib 库知识点
urllib 库 urllib 库是 Python 中一个最基本的网络请求库.它可以模仿浏览器的行为向指定的服务器发送请求,同时可以保存服务器返回的数据. urlopen() 在 Python3 的 ...
- python之爬虫(三) Urllib库的基本使用
官方文档地址:https://docs.python.org/3/library/urllib.html 什么是Urllib Urllib是python内置的HTTP请求库包括以下模块urllib.r ...
- Python爬虫--Urllib库
Urllib库 Urllib是python内置的HTTP请求库,包括以下模块:urllib.request (请求模块).urllib.error( 异常处理模块).urllib.parse (url ...
- urllib库的基本使用
urllib库的使用 官方文档地址:https://docs.python.org/3/library/urllib.html 什么是urllib Urllib是python内置的HTTP请求库包括以 ...
- 爬虫之Urllib库的基本使用
官方文档地址:https://docs.python.org/3/library/urllib.html 什么是Urllib Urllib是python内置的HTTP请求库包括以下模块urllib.r ...
随机推荐
- java程序运存扩容
线上程序随着业务增多,运行的越来越慢,初步判定是因为内存分配的太小导致频繁的进行GC和OOM,于是着手增加内存上限. 增加内存上限都知道是修改java启动的opt,因为服务容器是tomcat 首先是在 ...
- mongodb系列~mongodb数据迁移
一 简介:今天来聊聊mongo的数据迁移二 迁移 1 具体迁移命令 nohup mongodump --port --db dbname --collection tablename --qu ...
- Java编程:悲观锁、乐观锁的区别及使用场景
定义: 悲观锁(Pessimistic Lock): 每次获取数据的时候,都会担心数据被修改,所以每次获取数据的时候都会进行加锁,确保在自己使用的过程中数据不会被别人修改,使用完成后进行数据解锁.由于 ...
- 复制vmware主机修改网卡
https://blog.csdn.net/gui951753/article/details/79491092
- K-means聚类算法原理和C++实现
给定训练集$\{x^{(1)},...,x^{(m)}\}$,想把这些样本分成不同的子集,即聚类,$x^{(i)}\in\mathbb{R^{n}}$,但是这是个无标签数据集,也就是说我们再聚类的时候 ...
- mysql系列六、mysql创建用户、授权、备份及恢复命令
一.创建用户和授权 下面的操作中,其中someusername为用户名,somepassword为密码,somedbname为数据库名 1.创建用户 create user 'someusername ...
- bzoj 1803: Spoj1487 Query on a tree III(主席树)
题意 你被给定一棵带点权的n个点的有根数,点从1到n编号. 定义查询 query(x,k): 寻找以x为根的k大点的编号(从小到大排序第k个点) 假设没有两个相同的点权. 输入格式: 第一行为整数n, ...
- VMware环境和Window环境进行网络连接的问题
一. 首先贴出本人在网络上找到与VMware网络连接相关的知识点 安装完虚拟机后,默认安装了两个虚拟网卡,VMnet1和VMnet8,其他的未安装(当然也可以手动安装其他的).其中VMnet1是hos ...
- WallPaper
LiveWallPaper 动态壁纸是从Android2.1就开始带有的一个新的特性.它让我们能够将本来毫无生气的静态的手机屏幕背景替换成 从 随着音乐的活力和脉动而跳跃的声线 到 手指抚过能激起阵阵 ...
- Go语言学习之路(持续更新中)
菜鸟 Go语言教程 教程(RUNOOB.COM):http://www.runoob.com/go/go-tutorial.html Go全球官网:https://golang.org/ (2018- ...