
大数据和hadoop有什么关系?
本文资料来自百度文库相关文档
Hadoop,Spark和Storm是目前最重要的三大分布式计算系统,Hadoop常用于离线的复杂的大数据处理,Spark常用于离线的快速的大数据处理,而Storm常用于在线的实时的大数据处理。
简单说,Hadoop或者说Hadoop生态圈,是为了解决大数据应用场景而出现的,它包含了文件系统、计算框架、调度系统等,Spark是Hadoop生态圈里的一种分布式计算引擎。
大数据就是Hadoop吗?当然不是,但是很多人一提到大数据就会立刻想到Hadoop。现在数据科学家利用海量数据创建数据模型为企业带来的利益是以前所不可想象的,但是数据的潜力已经被完全挖掘出来了吗,它满足了人们的期待了吗?今天小编就从Hadoop项目开始为你抽丝剥茧了解hadoop。
Hadoop是什么?
Hadoop是一个对海量数据进行处理的分布式系统架构,可以理解为Hadoop就是一个对大量的数据进行分析的工具,和其他组件搭配使用,来完成对大量数据的收集、存储和计算。
下面就以千锋教育的hadoop教学实战项目为例,为hadoop做一个详细的解析:
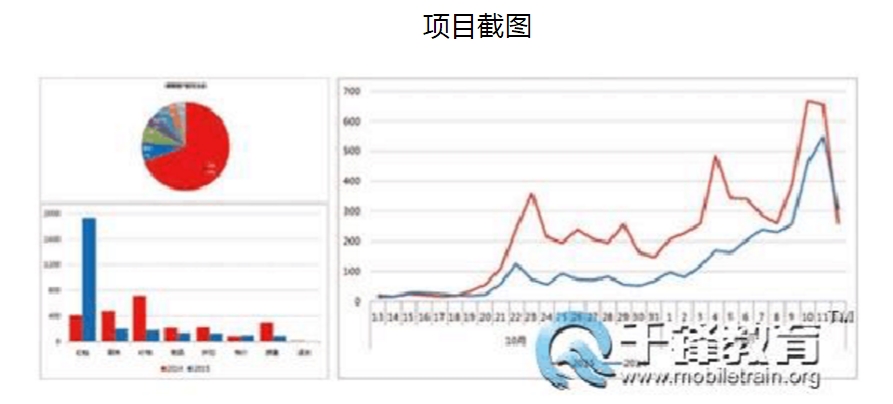
项目说明:hadoop_storm_spark结合实验的例子,模拟双11,根据订单详细信息,汇总出总销售量,各个地区销售排行,以及后期的SQL分析,数据分析,数据挖掘等。
- 第一阶段(storm实时报表)
- (1)用户订单入kafka队列,
- (2)经过storm,实时计算出总销售量,和各个省份的的销售量,
- (3)将计算结果保存到hbase数据库中。
- 第二阶段(离线报表)
- (1)用户订单入oracle数据库,
- (2)通过sqoop把数据导入hadoop上。
- (3)使用mr和rdd对hadoop上的原始订单做etl清洗
- (4)建立hive表和sparkSQL内存表。为后期分析做基础
- (5)使用HQL实现业务指标分析,和用户画像分析,将结果存在mysql中。供web前台使用
- 第三阶段(大规模订单即席查询,和多维度查询)
- (1)用户订单入oracle数据库,
- (2)通过sqoop把数据导入hadoop上。
- (3)写mr把hadoop的数据加载到hbase上
- (4)使用hbase java api实现订单的即席查询
- (5)solr绑定hbase,做多维度的条件查询
- 第四阶段(数据挖掘和图计算)
- (1)用户订单入oracle数据库,
- (2)通过sqoop把数据导入hadoop上。
- (3)使用mr和rdd对hadoop上的原始订单做etl清洗
总的来说Hadoop适合应用于大数据存储和大数据分析的应用,适合于服务器几千台到几万台的集群运行,支持PB级的存储容量。
Hadoop典型应用有:搜索、日志处理、推荐系统、数据分析、视频图像分析、数据保存等。
大数据和hadoop有什么关系?的更多相关文章
- 大数据和Hadoop生态圈
大数据和Hadoop生态圈 一.前言: 非常感谢Hadoop专业解决方案群:313702010,兄弟们的大力支持,在此说一声辛苦了,经过两周的努力,已经有啦初步的成果,目前第1章 大数据和Hadoop ...
- Hadoop专业解决方案-第1章 大数据和Hadoop生态圈
一.前言: 非常感谢Hadoop专业解决方案群:313702010,兄弟们的大力支持,在此说一声辛苦了,经过两周的努力,已经有啦初步的成果,目前第1章 大数据和Hadoop生态圈小组已经翻译完成,在此 ...
- 大数据和Hadoop时代的维度建模和Kimball数据集市
小结: 1. Hadoop 文件系统中的存储是不可变的,换句话说,只能插入和追加记录,不能修改数据.如果你熟悉的是关系型数据仓库,这看起来可能有点奇怪.但是从内部机制看,数据库是以类似的机制工作,在一 ...
- 大数据和Hadoop平台介绍
大数据和Hadoop平台介绍 定义 大数据是指其大小和复杂性无法通过现有常用的工具软件,以合理的成本,在可接受的时限内对其进行捕获.管理和处理的数据集.这些困难包括数据的收入.存储.搜索.共享.分析和 ...
- 大数据技术Hadoop入门理论系列之一----hadoop生态圈介绍
Technorati 标记: hadoop,生态圈,ecosystem,yarn,spark,入门 1. hadoop 生态概况 Hadoop是一个由Apache基金会所开发的分布式系统基础架构. 用 ...
- [Hadoop 周边] 浅谈大数据(hadoop)和移动开发(Android、IOS)开发前景【转】
原文链接:http://www.d1net.com/bigdata/news/345893.html 先简单的做个自我介绍,我是云6期的,黑马相比其它培训机构的好偶就不在这里说,想比大家都比我清楚: ...
- 大数据测试之hadoop集群配置和测试
大数据测试之hadoop集群配置和测试 一.准备(所有节点都需要做):系统:Ubuntu12.04java版本:JDK1.7SSH(ubuntu自带)三台在同一ip段的机器,设置为静态IP机器分配 ...
- 老李分享:大数据框架Hadoop和Spark的异同 1
老李分享:大数据框架Hadoop和Spark的异同 poptest是国内唯一一家培养测试开发工程师的培训机构,以学员能胜任自动化测试,性能测试,测试工具开发等工作为目标.如果对课程感兴趣,请大家咨 ...
- 大数据:Hadoop入门
大数据:Hadoop入门 一:什么是大数据 什么是大数据: (1.)大数据是指在一定时间内无法用常规软件对其内容进行抓取,管理和处理的数据集合,简而言之就是数据量非常大,大到无法用常规工具进行处理,如 ...
随机推荐
- iframe 和 父窗口传递
iframe 向父窗口 window.parent.postMessage('向父窗口传递值',*); 父窗口向 iframe 内部子窗口传值 documnet.querySelector('ifra ...
- (4.2)mysql备份还原——备份概述
1.什么情况下会用到备份呢? [1.1]灾难恢复 [1.2]单位审计:数据库在过去某一个点是什么样的 [1.3]跨机房灾备:异地备份 [1.4]认为的DDL或者DML语句,导致主从库的数据消失 [1. ...
- 递归与非递归打印乘法口诀表--Scala(指令式、函数式思维练习)
object Test extends App { def printMultiTable() { var i = 1 while (i < 10) { var j = 1 while (j & ...
- Java通过jxl读取Excel
package com.hd.all.test.testjava; import java.io.File; import java.io.IOException; import java.util. ...
- extjs store快速创建的几种方式
viewModel中定义stores: { tickets: { model: 'Ticket', autoLoad: true, remoteFilter: true, filters: [{ pr ...
- go build -ldflags
http://studygolang.com/articles/2052 ldflags 用法:[路径,非必需,除非你有目录层次]包名.变量 [path]packege.value go build ...
- [xdoj]1303jlz的刷题黑科技
先分析复杂度,给的数据是1e5的,那么我们至少需要一个nlogn的算法才可以.由于答案是一个数字,首先想到是二分法(一般答案是一个数字都可以通过二分法来完成) 下面是思路: 1.可以完成题目的条件是, ...
- jmeter二次开发----Loadrunner或Jmeter发送邮件报告
Loadrunner支持Java Vuser,而Jmeter本身就是基于Java开发的,所以两者都可以通过JMail组件实现邮件发送.本人使用的是mail-1.4.7.jar,可以通过下载获得:htt ...
- Selenium基础知识(四)表单切换
在测试过程中,经常会碰到frame和iframe,嵌套等情况 这种情况下直接通过id,name等等是无法定位到的 好在selenium替我们想到了这个问题switch_to方法解决问题 switch_ ...
- 用int还是用Integer?
昨天例行code review时大家有讨论到int和Integer的比较和使用. 这里做个整理,发表一下个人的看法. [int和Integer的区别] int是java提供的8种原始类型之一,ja ...