
跟我学算法-SVM(支持向量机)
支持向量机是一个点离决策边界越近,离决策面越远的问题
求解的过程主要是通过拉格朗日乘子法,来求解带约束的优化问题,在问题中涉及两个方面,一个是线性的,一个是非线性的,非线性的有
我们平时比较常见的高斯核函数(径向基函数),他的主要做法就是把低维的数据变成高维数据,通过^2的方法
在支持向量基中的参数有 svc__C(松弛因子)和svc__gamma 两个参数,两个参数越大,模型的复杂度也越大
接下来我们使用一组人脸数据来进行模型,我们会进行参数调节
第一步数据载入
from sklearn.datasets import fetch_lfw_people  #从datasets数据包中获取数据

import pandas as pd

import matplotlib.pyplot as plt

faces = fetch_lfw_people(min_faces_per_person=60) #不小于60张图片

print(faces.target_names) #输出照片里的人物名字

print(faces.images.shape) #输出照片的大小, 639张, 62*47表示的是像素点,每个像素点代表的是一个数据
第二步 取前15张图片,画成3行5列的图片
fig, ax = plt.subplots(3, 5)

for i, axi in enumerate(ax.flat):

    axi.imshow(faces.images[i], cmap='bone') # cmap 表示配色方案,bone表示苍白的

    axi.set(xticks=[], yticks=[], xlabel=faces.target_names[faces.target[i]])  #faces.target[i]对应着0和1标签,

    # target_names 的 key 是 0和1...,value是名字

plt.show()
第三步:通过make_pipeline 连接pca,svm函数
from sklearn.svm import  SVC

from sklearn.decomposition import PCA

from sklearn.pipeline import make_pipeline

pca = PCA(n_components=150, whiten=True, random_state=42)  #whiten确保无相关的输出

svc = SVC(kernel='rbf', class_weight='balanced')  #核函数为径向基函数

model = make_pipeline(pca, svc)  #连接两个函数, 函数按照先后顺序执行
第四步: 通过GridSearchCV调节svc__C 和 svc__gamma 参数,.best_estimator获得训练好的模型
#把函数分为训练集和测试集

from sklearn.model_selection import train_test_split

Xtrain, Xtest, Ytrain, Ytest = train_test_split(faces.data, faces.target, random_state=40)

#参数调整svc__C和svc__gamma

from sklearn.model_selection import GridSearchCV

#备选参数

param_grid = {'svc__C':[1, 5, 10],

              'svc__gamma':[0.0001, 0.0005, 0.001]}

grid = GridSearchCV(model, param_grid) #第一个参数是model(模型), 第二个参数是param_grid 需要调整的参数

print(Xtrain.shape, Ytrain.shape)

grid.fit(Xtrain, Ytrain) #建立模型

print(grid.best_params_) #输出模型的参数组合

model = grid.best_estimator_  #输出最好的模型

yfit = model.predict(Xtest)  #用当前最好的模型做预测
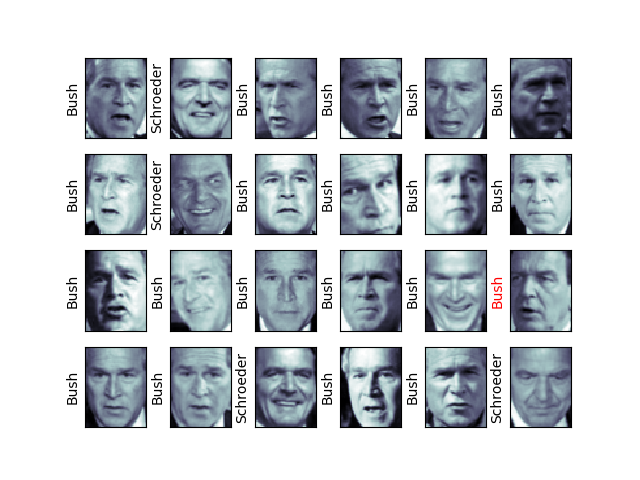
第五步:对预测结果画图,这里画了4*6的图
fig , ax = plt.subplots(4, 6)  #画出24副图,呈现4行6列的摆放形式

for i, axi in enumerate(ax.flat):

    axi.imshow(Xtest[i].reshape(62, 47), cmap='bone')

    axi.set(xticks=[], yticks=[])

    axi.set_ylabel(faces.target_names[yfit[i]].split()[-1],   #取名字的后一个字符,如果预测结果与真实结果相同,贤黑色,否则显红色

              color='black'if yfit[i]==Ytest[i] else 'red')

plt.show()

fig.suptitle('Predicted Names; Incorrect Labels in Red', size=14)  #加上标题

from sklearn.metrics import classification_report   #输出精确度,召回值

print(classification_report(Ytest, yfit, target_names=faces.target_names))
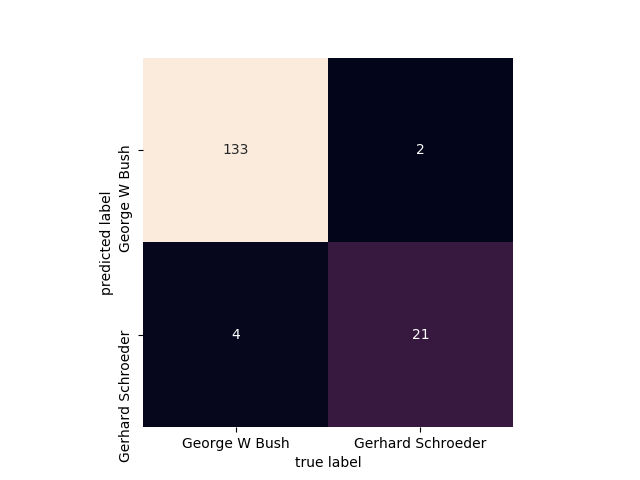
第六步:画出一个混淆矩阵的图
from sklearn.metrics import  confusion_matrix  #做混淆矩阵

import seaborn as sns

mat = confusion_matrix(Ytest, yfit)   #Ytest表示待测标签, yfit表示预测结果

sns.heatmap(mat.T, square=True, annot=True, fmt='d', cbar=False,
            xticklabels=faces.target_names,

            yticklabels=faces.target_names)

plt.xlabel('true label')

plt.ylabel('predicted label')

plt.show()
跟我学算法-SVM(支持向量机)的更多相关文章
- 跟我学算法-svm支持向量机算法推导
Svm算法又称为支持向量机,是一种有监督的学习分类算法,目的是为了找到两个支持点,用来使得平面到达这两个支持点的距离最近. 通俗的说:找到一条直线,使得离该线最近的点与该线的距离最远. 我使用手写进行 ...
- 机器学习 - 算法 - SVM 支持向量机
SVM 原理引入 支持向量机( SVM,Support Vector Machine ) 背景 2012年前较为火热, 但是在12年后被神经网络逼宫, 由于应用场景以及应用算法的不同, SVM还是需要 ...
- 机器学习 - 算法 - SVM 支持向量机 Py 实现 / 人脸识别案例
SVM 代码实现展示 相关模块引入 %matplotlib inline import numpy as np import matplotlib.pyplot as plt from scipy i ...
- 转:机器学习中的算法(2)-支持向量机(SVM)基础
机器学习中的算法(2)-支持向量机(SVM)基础 转:http://www.cnblogs.com/LeftNotEasy/archive/2011/05/02/basic-of-svm.html 版 ...
- SVM 支持向量机算法-原理篇
公号:码农充电站pro 主页:https://codeshellme.github.io 本篇来介绍SVM 算法,它的英文全称是 Support Vector Machine,中文翻译为支持向量机. ...
- SVM 支持向量机算法-实战篇
公号:码农充电站pro 主页:https://codeshellme.github.io 上一篇介绍了 SVM 的原理和一些基本概念,本篇来介绍如何用 SVM 处理实际问题. 1,SVM 的实现 SV ...
- 深入浅出理解SVM支持向量机算法
支持向量机是Vapnik等人于1995年首先提出的,它是基于VC维理论和结构风险最小化原则的学习机器.它在解决小样本.非线性和高维模式识别问题中表现出许多特有的优势,并在一定程度上克服了" ...
- 机器学习实战 - 读书笔记(06) – SVM支持向量机
前言 最近在看Peter Harrington写的"机器学习实战",这是我的学习笔记,这次是第6章:SVM 支持向量机. 支持向量机不是很好被理解,主要是因为里面涉及到了许多数学知 ...
- SparkMLlib分类算法之支持向量机
SparkMLlib分类算法之支持向量机 (一),概念 支持向量机(support vector machine)是一种分类算法,通过寻求结构化风险最小来提高学习机泛化能力,实现经验风险和置信范围的最 ...
随机推荐
- C:源文件编译过程
可以大致概括为3个阶段: 源文件 → 汇编代码(文本) 汇编代码 → 机器语言(二进制) 各个目标文件的处理 详细过程: 预编译处理 Pre-processing(*.c/ *.cpp → *.i) ...
- 每天一个linux命令(性能、优化):【转载】free命令
free命令可以显示Linux系统中空闲的.已用的物理内存及swap内存,及被内核使用的buffer.在Linux系统监控的工具中,free命令是最经常使用的命令之一. 1.命令格式: free [参 ...
- Java并发--阻塞队列
在前面几篇文章中,我们讨论了同步容器(Hashtable.Vector),也讨论了并发容器(ConcurrentHashMap.CopyOnWriteArrayList),这些工具都为我们编写多线程程 ...
- BZOJ2820 YY的GCD 【莫比乌斯反演】
BZOJ2820 YY的GCD Description 神犇YY虐完数论后给傻×kAc出了一题给定N, M,求1<=x<=N, 1<=y<=M且gcd(x, y)为质数的(x, ...
- MySQL性能管理及架构设计 --- 理论篇
MySQL性能管理及架构设计 一丶IO,内存,吞吐量理解 IO 是指设备与设备之间操作次数,比如mysql与php互插内存 是程序运行都在里面执行吞吐量 是单 ...
- wpf 动态得到label的宽度(无刷新情况)
var l =newLabel(){Content="Hello"}; l.Measure(newSize(double.PositiveInfinity,double.Posit ...
- Eclipse的Java开发中jar导入后无法使用包内class的解决方案
请注意, 本方法只对于自己的包有效, 如果你的类内部互相调用, 此方法会失效, 需要每个类文件都进行一次CTRL+SHIFT+O进行包的导入. 如上图的一个结构, algs4.jar和stdlib.j ...
- win7下安装ubuntu14.04lts 双系统
首先,在win7下的硬盘管理 压缩出一块空闲的分区,即压缩卷之后,不做任何操作. 并且确保该空闲卷是“基本”类型 不是的话,参考http://www.jianshu.com/p/2f07312 ...
- bzo1007 [HNOI2008]水平可见直线
题目:https://www.lydsy.com/JudgeOnline/problem.php?id=1007 所有可见直线形成下凸壳的样子.而且交点横坐标递增. (特殊判断平行线.但是按b从小到大 ...
- lamp环境应用实践
LAMP之apache2.4.33 apache工作模式 apache 常用工作模式有2种,区别在于 worker模式 1. 线程模式 2. 占用资源少 3. 稳定性略差 4. 并发大 prefork ...