
利用Nodejs & Cheerio & Request抓取Lofter美女图片
还是参考了这篇文章:
http://cnodejs.org/topic/54bdaac4514ea9146862abee
另外有上面文章 nodejs抓取网易公开课的一些经验。
代码如下,注意其中用到了 http获取网页结果,request进行http请求,cheerio进行解析,mkdirp创建目录,fs创建文件,iconv-lite进行格式转换(此例非必须)。
curl.js:
/**

 * Created by baidu on 16/10/17.

 */

var http = require("http");

function download(url, callback) {

    var chunks = [];

    http.get(url, function(res) {

        res.on('data', function(chunk) {

            chunks.push(chunk);

        });

        res.on('end', function () {

            callback(chunks);

        });

    }).on('error', function () {

        callback(chunks);

    })

}

exports.download = download;
saveimage.js
/**

 * Created by baidu on 16/10/17.

 */

var fs = require('fs');

var request = require('request');

var saveImage = function(url, filename) {

    console.log('Image=>' + url);

    request(url).pipe(fs.createWriteStream(filename));

    console.log('Save=>' + filename);

}

exports.saveImage = saveImage;
HelloWorld.js
/**

 * Created by baidu on 16/10/17.

 */

console.log("Hello World");

var cheerio = require('cheerio');

var curl = require('./curl');

var iconv = require('iconv-lite');

var mkdirp = require('mkdirp');

var saveimage = require('./saveimage');

//var url = 'http://open.163.com/special/opencourse/englishs1.html';

var url = 'http://loftermeirenzhi.lofter.com/tag/%E4%BA%BA%E5%83%8F?page=';

var dir = './images';

mkdirp(dir, function(err) {

    if (err) {

        console.log(err);

    }

});

curl.download(url, function (chunks) {

    if (chunks) {

        var data = iconv.decode(Buffer.concat(chunks), 'gbk');

        var $ = cheerio.load(data);

        $('a.img').each(function (i, e) {

            var item = $(e).children('img').last().attr('src');

            saveimage.saveImage(item, dir + '/' + item.substr(item.indexOf('.jpg')-10, 14));

        });

        console.log('done');

    }

    else {

        console.log('error');

    }

});
运行之后,发现基本上下载的图片文件都是空。
看了例子,将saveimage.js中的request部分做了一些修改,如下:
/**

 * Created by baidu on 16/10/17.

 */

var fs = require('fs');

var request = require('request');

var saveImage = function(url, filename) {

    console.log('Image=>' + url);

    request.head(url, function(err, res, body) {

        request(url).pipe(fs.createWriteStream(filename));

    });

    console.log('Save=>' + filename);

}

exports.saveImage = saveImage;
然后运行,成功,打印:
/usr/local/bin/node /Users/baidu/Documents/Data/Work/Code/Self/nodejs/helloworld/HelloWorld.js

Hello World

Image=>http://imgsize.ph.126.net/?imgurl=http://img2.ph.126.net/CiL5IULFm0TtZBjxnhcfQQ==/52072870709354180.jpg_110x110x0x90.jpg

Save=>./images/0709354180.jpg

Image=>http://imglf1.nosdn.127.net/img/SzZqcDg4Rk01VGo5cW81TEorTU5zL2dCbjBLbktBODlCSkFGSXlIdEw5dEFvSDlGaTNjZmJ3PT0.jpg?imageView&thumbnail=500x0&quality=96&stripmeta=0&type=jpg

Save=>./images/TNjZmJ3PT0.jpg

......

done
然后项目目录中,生成了images目录,其中有美女图片:
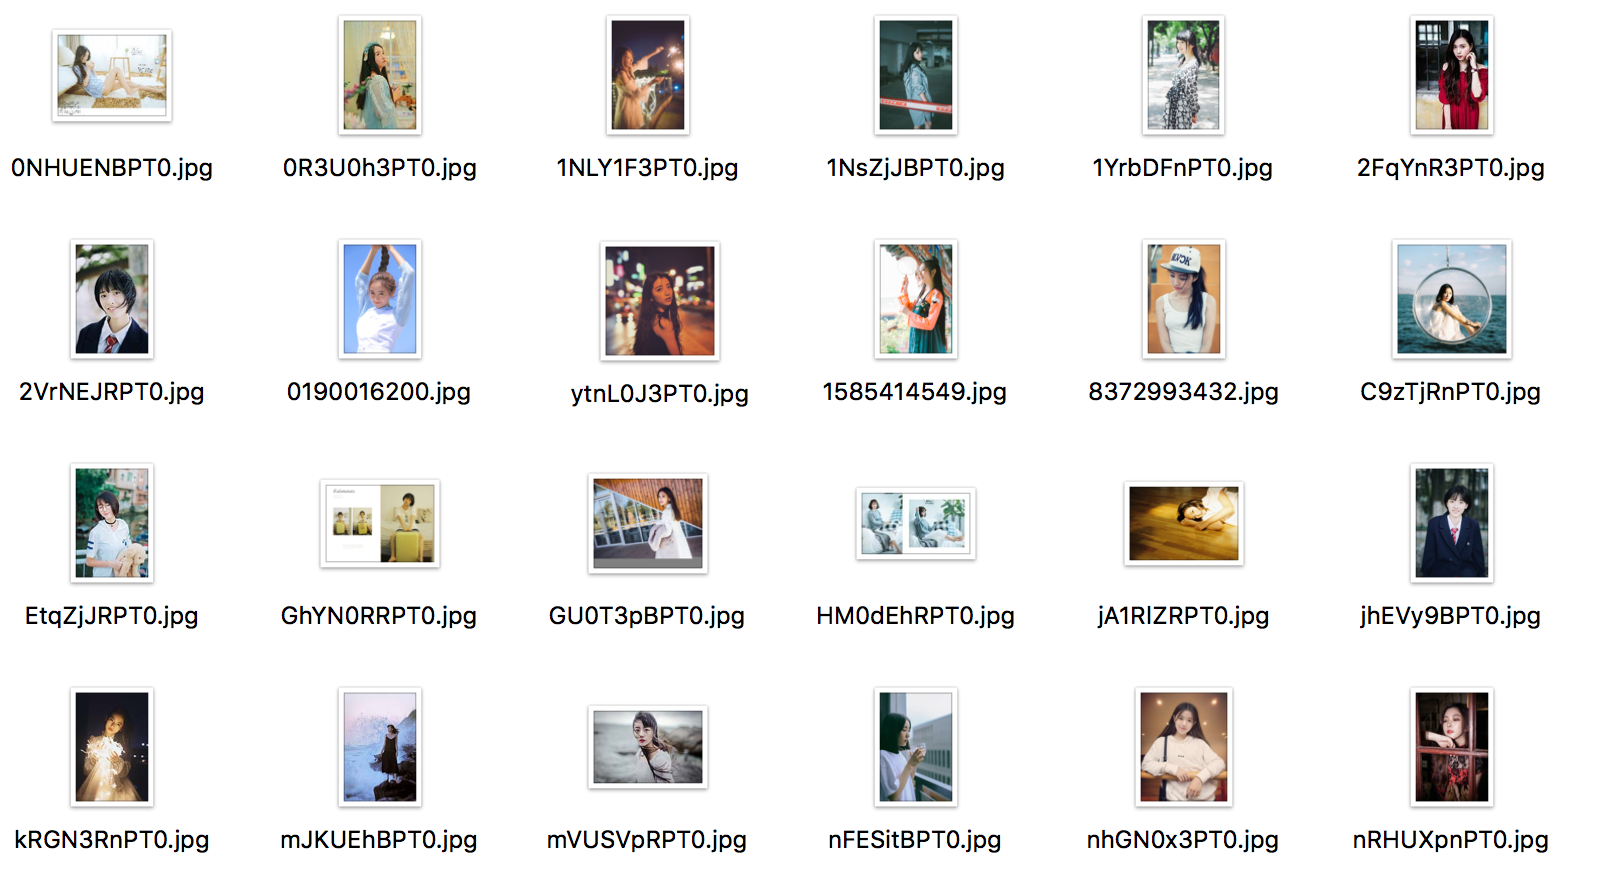
对上面这个改动能起到效果,还不是特别明白。(head一般用来判断url是否有效。)
加了head成功,也有可能是因为第一次图片虽然没下载成功,但是已经启动下载,做了缓存。实验了一下,在成功一次之后,把head命令去掉:
//request.head(url, function(err, res, body) {

        request(url).pipe(fs.createWriteStream(filename));

//});
发现还是能够成功。所以有很大可能是图片加载延迟造成。
有时间的时候,要看一下,怎样避免图片下载超时导致下载失败的问题,有没有设置超时的地方。
好像在request初始化的时候,可以设置:
request({

    url: jurl,

    gzip: true,

    timeout: xxx

  })
后面再学习 Javascript Request 以及 渲染的一些内容。尤其是 phantomjs 渲染动态网页的方式。
利用Nodejs & Cheerio & Request抓取Lofter美女图片的更多相关文章
- 【Python爬虫程序】抓取MM131美女图片,并将这些图片下载到本地指定文件夹。
一.项目名称 抓取MM131美女写真图片,并将这些图片下载到本地指定文件夹. 共有6种类型的美女图片: 性感美女 清纯美眉 美女校花 性感车模 旗袍美女 明星写真 抓取后的效果图如下,每个图集是一个独 ...
- 使用nodejs+http(s)+events+cheerio+iconv-lite爬取2717网站图片数据到本地文件夹
源代码如下: //(node:9240) Warning: Setting the NODE_TLS_REJECT_UNAUTHORIZED environment variable to '0' ...
- Phantomjs+Nodejs+Mysql数据抓取(2.抓取图片)
概要 这篇博客是在上一篇博客Phantomjs+Nodejs+Mysql数据抓取(1.抓取数据) http://blog.csdn.net/jokerkon/article/details/50868 ...
- python抓取性感尤物美女图
由于是只用标准库,装了python3运行本代码就能下载到多多的美女图... 写出代码前面部分的时候,我意识到自己的函数设计错了,强忍继续把代码写完. 测试发现速度一般,200K左右的下载速度,也没有很 ...
- 利用python scrapy 框架抓取豆瓣小组数据
因为最近在找房子在豆瓣小组-上海租房上找,发现搜索困难,于是想利用爬虫将数据抓取. 顺便熟悉一下Python. 这边有scrapy 入门教程出处:http://www.cnblogs.com/txw1 ...
- 如何利用Python网络爬虫抓取微信朋友圈的动态(上)
今天小编给大家分享一下如何利用Python网络爬虫抓取微信朋友圈的动态信息,实际上如果单独的去爬取朋友圈的话,难度会非常大,因为微信没有提供向网易云音乐这样的API接口,所以很容易找不到门.不过不要慌 ...
- (转)利用Beautiful Soup去抓取p标签下class=jstest的内容
1.利用Beautiful Soup去抓取p标签下class=jstest的内容 import io import sys import bs4 as bs import urllib.request ...
- Android利用tcpdump和wireshark抓取网络数据包
Android利用tcpdump和wireshark抓取网络数据包 主要介绍如何利用tcpdump抓取andorid手机上网络数据请求,利用Wireshark可以清晰的查看到网络请求的各个过程包括三次 ...
- Python爬虫【三】利用requests和正则抓取猫眼电影网上排名前100的电影
#利用requests和正则抓取猫眼电影网上排名前100的电影 import requests from requests.exceptions import RequestException imp ...
随机推荐
- 详解java中的TreeSet集合
TreeSet是实现Set接口的实现类.所以它存储的值是唯一的,同时也可以对存储的值进行排序,排序用的是二叉树原理.所以要理解这个类,必须先简单理解一下什么是二叉树. 二叉树原理简述 假如有这么一个集 ...
- Activiti如何替换已部署流程图
首先交代下背景:我们有一个已经上线的activiti工作流系统,对于流程图的操作已经封装好部署,查看,删除的接口.此时客户提出要修改个别流程图里的节点名称. 我的第一个想法就是本地修改流程图bpmn文 ...
- 【msgpack-python】安装
1.安装pip:http://blog.iyestin.com/2014/03/15/python-pip-install/ http://www.linuxde.net/2014/05/15576. ...
- Nginx事件管理机制-epoll
epoll的最大好处在于他不会随着被监控描述符的数目的增长而导致效率极致下降. select是遍历扫描来判断每个描述符是否有事件发生,当监控的描述付越多时,时间消耗就越多,并且由于系统的限制selec ...
- python Mixin 是个啥?
内容待添加... 参考文章: [1][python] Mixin 扫盲班
- OpenAcc笔记——update
program main use omp_lib use openacc implicit none real,allocatable:: v1(:) integer length, idx call ...
- LR运行场景时出现的error
LR运行场景时出现的error 1.Action.c(24): Error -27740: Overlapped transmission of request to "home.asiai ...
- windows查看指定端口
- Kvm虚拟化安装与虚拟机创建
1. 验证CPU是否支持KVM:如果结果中有vmx(Intel)或svm(AMD)字样,就说明CPU的支持的. egrep '(vmx|svm)' /proc/cpuinfo 2. 关闭SELinux ...
- [jquery] 遍历select的option,然后设置一项为选中
<script> var v={$menu.pid}; $("#pid option").each(function(){ if($(this).val()==v){ ...