
利用python scrapy 框架抓取豆瓣小组数据
因为最近在找房子在豆瓣小组-上海租房上找,发现搜索困难,于是想利用爬虫将数据抓取. 顺便熟悉一下Python.
这边有scrapy 入门教程出处:http://www.cnblogs.com/txw1958/archive/2012/07/16/scrapy-tutorial.html
差不多跟教程说的一样,问题技术难点是 转码,上述教程并未详细指出. 我还是把代码贴出来,请供参考.
E:\tutorial>tree /f

Folder PATH listing for volume 文档

Volume serial number is -BBB3

E:.

│  scrapy.cfg

│

└─tutorial

    │  items.py

    │  items.pyc

    │  pipelines.py

    │  pipelines.pyc

    │  settings.py

    │  settings.pyc

    │  __init__.py

    │  __init__.pyc

    │

    └─spiders

            douban_spider.py

            douban_spider.pyc

            __init__.py

            __init__.pyc
item.py: 这有一篇很好介绍ITEM的文章(http://blog.csdn.net/iloveyin/article/details/41309609)
from scrapy.item import Item, Field

class DoubanItem(Item):

    title = Field()

    link = Field()

    #resp = Field()

    #dateT = Field()
pipelines.py #定义你自己的PipeLine方式,详细中文转码可在此处解决
# -*- coding: utf-8 -*-

# Don't forget to add your pipeline to the ITEM_PIPELINES setting

# See: http://doc.scrapy.org/en/latest/topics/item-pipeline.html

import json

import codecs

class TutorialPipeline(object):

    def __init__(self):

        self.file = codecs.open('items.json', 'wb', encoding='gbk')

    def process_item(self, item, spider):

        line = json.dumps(dict(item)) + '\n'

        print line

        self.file.write(line.decode("unicode_escape"))

        return item
在setting.py 加入相应的 ITEM_PIPELINES 属性(红色字体为新加部分)
# -*- coding: utf-8 -*-

# Scrapy settings for tutorial project

#

# For simplicity, this file contains only the most important settings by

# default. All the other settings are documented here:

#

#     http://doc.scrapy.org/en/latest/topics/settings.html

#

BOT_NAME = 'tutorial'

SPIDER_MODULES = ['tutorial.spiders']

NEWSPIDER_MODULE = 'tutorial.spiders'

ITEM_PIPELINES = {

    'tutorial.pipelines.TutorialPipeline':300

}

# Crawl responsibly by identifying yourself (and your website) on the user-agent

#USER_AGENT = 'tutorial (+http://www.yourdomain.com)'
接下来是spider.py
from scrapy.spider import BaseSpider

from scrapy.selector import HtmlXPathSelector

from scrapy.http import Request

from tutorial.items import DoubanItem

class DoubanSpider(BaseSpider):

    name = "douban"

    allowed_domains = ["douban.com"]

    start_urls = [

        "http://www.douban.com/group/shanghaizufang/discussion?start=0",

        "http://www.douban.com/group/shanghaizufang/discussion?start=25",

        "http://www.douban.com/group/shanghaizufang/discussion?start=50",

        "http://www.douban.com/group/shanghaizufang/discussion?start=75",

        "http://www.douban.com/group/shanghaizufang/discussion?start=100",

        "http://www.douban.com/group/shanghaizufang/discussion?start=125",

        "http://www.douban.com/group/shanghaizufang/discussion?start=150",

        "http://www.douban.com/group/shanghaizufang/discussion?start=175",

        "http://www.douban.com/group/shanghaizufang/discussion?start=200"

]

    def parse(self, response):

        hxs = HtmlXPathSelector(response)

        sites = hxs.xpath('//tr/td')

        items=[]

        for site in sites:

            item = DoubanItem()

            item['title'] =site.xpath('a/@title').extract()

            item['link'] = site.xpath('a/@href').extract()

           # item['resp'] = site.xpath('text()').extract()

           # item['dateT'] = site.xpath('text()').extract()

            items.append(item)

        return items
用JSON数据方式导出:
scrapy crawl douban -o items.json -t json
这有个JSON 转成CSV工具的网站,可以帮助转换:
https://json-csv.com/
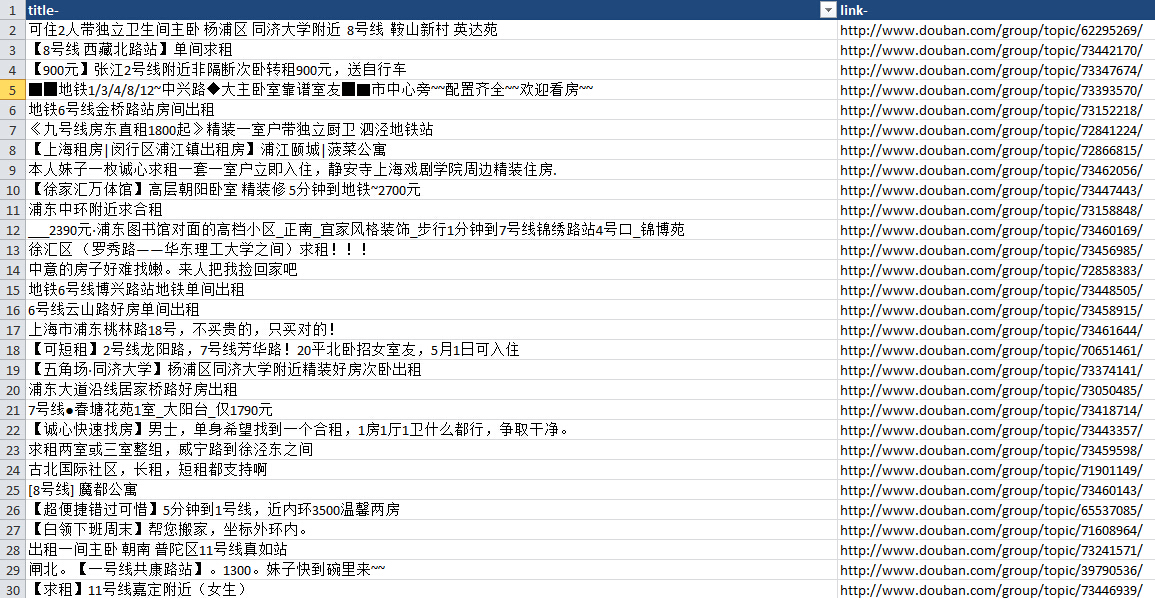
结果效果展示,这样方便检索和过滤
利用python scrapy 框架抓取豆瓣小组数据的更多相关文章
- Python爬虫之抓取豆瓣影评数据
脚本功能: 1.访问豆瓣最受欢迎影评页面(http://movie.douban.com/review/best/?start=0),抓取所有影评数据中的标题.作者.影片以及影评信息 2.将抓取的信息 ...
- python scrapy框架爬取豆瓣
刚刚学了一下,还不是很明白.随手记录. 在piplines.py文件中 将爬到的数据 放到json中 class DoubanmoviePipelin2json(object):#打开文件 open_ ...
- 如何利用Python网络爬虫抓取微信朋友圈的动态(上)
今天小编给大家分享一下如何利用Python网络爬虫抓取微信朋友圈的动态信息,实际上如果单独的去爬取朋友圈的话,难度会非常大,因为微信没有提供向网易云音乐这样的API接口,所以很容易找不到门.不过不要慌 ...
- 利用Python网络爬虫抓取微信好友的签名及其可视化展示
前几天给大家分享了如何利用Python词云和wordart可视化工具对朋友圈数据进行可视化,利用Python网络爬虫抓取微信好友数量以及微信好友的男女比例,以及利用Python网络爬虫抓取微信好友的所 ...
- 利用Python网络爬虫抓取微信好友的所在省位和城市分布及其可视化
前几天给大家分享了如何利用Python网络爬虫抓取微信好友数量以及微信好友的男女比例,感兴趣的小伙伴可以点击链接进行查看.今天小编给大家介绍如何利用Python网络爬虫抓取微信好友的省位和城市,并且将 ...
- 如何利用Python网络爬虫抓取微信好友数量以及微信好友的男女比例
前几天给大家分享了利用Python网络爬虫抓取微信朋友圈的动态(上)和利用Python网络爬虫爬取微信朋友圈动态——附代码(下),并且对抓取到的数据进行了Python词云和wordart可视化,感兴趣 ...
- Python小爬虫——抓取豆瓣电影Top250数据
python抓取豆瓣电影Top250数据 1.豆瓣地址:https://movie.douban.com/top250?start=25&filter= 2.主要流程是抓取该网址下的Top25 ...
- 【python数据挖掘】爬取豆瓣影评数据
概述: 爬取豆瓣影评数据步骤: 1.获取网页请求 2.解析获取的网页 3.提速数据 4.保存文件 源代码: # 1.导入需要的库 import urllib.request from bs4 impo ...
- 基于python的scrapy框架爬取豆瓣电影及其可视化
1.Scrapy框架介绍 主要介绍,spiders,engine,scheduler,downloader,Item pipeline scrapy常见命令如下: 对应在scrapy文件中有,自己增加 ...
随机推荐
- linux设置ulimit值永久生效
小知识的积累,转自 http://hi.baidu.com/moonelf9989/blog/item/1deadf12780fa0c5c2fd789d.html linux 默认打开文件数linux ...
- zedboard如何从PL端控制DDR读写(一)
看了一段时间的DDR手册,感觉大体有一点了解了,想要实际上板调试,然而实验室可用的开发板不多,拿了一块zynq板看了看,DDR确实有,但是已经集成了控制器,而且控制器还放到了PS端,PL只能通过AXI ...
- PHP超时处理全面总结(转)
[ 概述 ] 在PHP开发中工作里非常多使用到超时处理到超时的场合,我说几个场景: 1. 异步获取数据如果某个后端数据源获取不成功则跳过,不影响整个页面展现 2. 为了保证Web服务器不会因为当个页面 ...
- jQuery层级元素选择器
第一个: 1:空格表示所有 2:> 第一层 3:+/- 同级 +:之后的第一个元素 -:之后所有同级 d 代码示例: <!DOCTYPE html PUBLIC "-//W3C/ ...
- 获取本地ip地址
#import <ifaddrs.h> #import <arpa/inet.h> // Get IP Address - (NSString *)getIPAddress { ...
- 使用Visual Studio Code开发Asp.Net Core WebApi学习笔记(九)-- 单元测试
本篇将结合这个系列的例子的基础上演示在Asp.Net Core里如何使用XUnit结合Moq进行单元测试,同时对整个项目进行集成测试. 第一部分.XUnit 修改 Project.json 文件内容, ...
- NSDateFormatter中时间格式串的含义
a: AM/PM (上午/下午) A: 0~86399999 (一天的第A微秒) c/cc: 1~7 (一周的第一天, 周天为1) ccc: Sun/Mon/Tue/Wed/Thu/Fri/Sat ( ...
- [leetcode]_Climbing Stairs
我敢保证这道题是在今早蹲厕所的时候突然冒出的解法.第一次接触DP题,我好伟大啊啊啊~ 题目:一个N阶的梯子,一次能够走1步或者2步,问有多少种走法. 解法:原始DP问题. 思路: 1.if N == ...
- mr的logs的查看
在map或者reduce函数中使用System.out.println打印的信息沾满查看呢? 步骤1:启动history server /usr/local/hadoop-2.6.0/sbin/mr- ...
- NodeManager起不来
NodeManager无法启动,解除授权,重新授权! CDH需要注意的表: SELECT * FROM `ROLES` SELECT * FROM CONFIGS WHERE attr LIKE '% ...