
Learn ZYNQ(10) – zybo cluster word count
1.配置环境说明
spark:5台zybo板,192.168.1.1master,其它4台为slave
hadoop:192.168.1.1(外接SanDisk )
2.单节点hadoop测试:
如果出现内存不足情况如下:
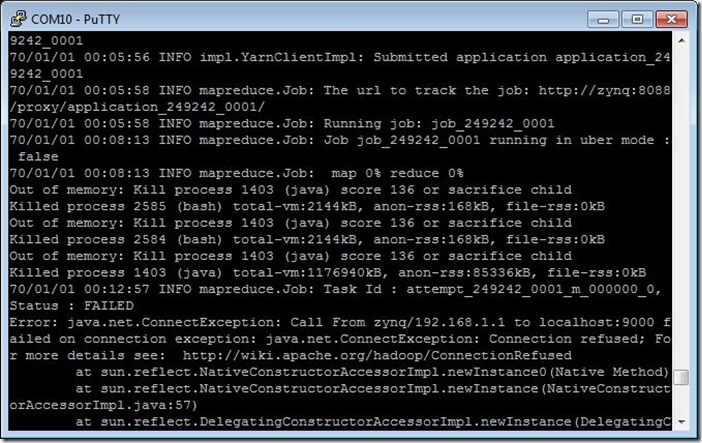
查看当前虚拟内存容量:
free -m
cd /mnt
mkdir swap
cd swap/
创建一个swap文件
dd if=/dev/zero of=swapfile bs=1024 count=1000000
把生成的文件转换成swap文件
mkswap swapfile
激活swap文件
swapon swapfile
free -m
通过测试:


3.spark + hadoop 测试
SPARK_MASTER_IP=192.168.1.1 ./sbin/start-all.sh

MASTER=spark://192.168.1.1:7077 ./bin/pyspark
file = sc.textFile("hdfs://192.168.1.1:9000/in/file")
counts = file.flatMap(lambda line: line.split(" ")) \
.map(lambda word: (word, 1)) \
.reduceByKey(lambda a, b: a + b)
counts.saveAsTextFile("hdfs://192.168.1.1:9000/out/mycount")
counts.saveAsTextFile("/mnt/mycount")
counts.collect()

counts.collect()

错误1:
java.net.ConnectException: Call From zynq/192.168.1.1 to spark1:8020 failed on connection exception: java.net.ConnectException: Connection refused; For more details see: http://wiki.apache.org/hadoop/ConnectionRefused
这是由于我们用root启动hadoop,而spark要远程操作hadoop系统,没有权限引起的
解决:如果是测试环境,可以取消hadoop hdfs的用户权限检查。打开etc/hadoop/hdfs-site.xml,找到dfs.permissions属性修改为false(默认为true)OK了。
<property>
<name>dfs.permissions</name>
<value>false</value>
</property>
4.附:我的配置文件
go.sh:
#! /bin/sh -

mount /dev/sda1 /mnt/

cd /mnt/swap/

swapon swapfile

free -m

cd /root/hadoop-2.4.0/

sbin/hadoop-daemon.sh start namenode

sbin/hadoop-daemon.sh start datanode

sbin/hadoop-daemon.sh start secondarynamenode

sbin/yarn-daemon.sh start resourcemanager

sbin/yarn-daemon.sh start nodemanager

sbin/mr-jobhistory-daemon.sh start historyserver

jps

while [ `netstat -ntlp | grep 9000` -eq `echo` ]

do

sleep 1

done

netstat -ntlp

echo hadoop start successfully

cd /root/spark-0.9.1-bin-hadoop2

SPARK_MASTER_IP=192.168.1.1 ./sbin/start-all.sh

jps

while [ `netstat -ntlp | grep 7077` -eq `echo` ]

do

sleep 1

done

netstat -ntlp

echo spark start successfully
/etc/hosts
#127.0.0.1      localhost       zynq

192.168.1.1     spark1          localhost       zynq

#192.168.1.1    spark1

192.168.1.2     spark2

192.168.1.3     spark3

192.168.1.4     spark4

192.168.1.5     spark5

192.168.1.100   sparkMaster

#::1            localhost ip6-localhost ip6-loopback
/etc/profile
export PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin:$PATH

export JAVA_HOME=/usr/lib/jdk1.7.0_55

export JRE_HOME=${JAVA_HOME}/jre

export CLASSPATH=.:$JAVA_HOME/lib/tools.jar

export PATH=$JAVA_HOME/bin:$PATH

export HADOOP_HOME=/root/hadoop-2.4.0

export PATH=$PATH:$HADOOP_HOME/bin

export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native

export HADOOP_OPTS="-Djava.library.path=$HADOOP_HOME/lib/native"

export HADOOP_MAPRED_HOME=$HADOOP_HOME

export HADOOP_COMMON_HOME=$HADOOP_HOME

export HADOOP_HDFS_HOME=$HADOOP_HOME

export YARN_HOME=$HADOOP_HOME

export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop

ifconfig eth2 hw ether 00:0a:35:00:01:01

ifconfig eth2 192.168.1.1/24 up
HADOOP_HOME/etc/hadoop/yarn-site.xml
<configuration>

<property>

<name>yarn.nodemanager.aux-services</name>

<value>mapreduce_shuffle</value>

</property>

<property>

<name>yarn.nodemanager.aux-services.mapreduce_shuffle.class</name>

<value>org.apache.hadoop.mapred.ShuffleHandler</value>

</property>

</configuration>
HADOOP_HOME/etc/hadoop/core-site.xml
<configuration>

    <property>

        <name>fs.default.name</name>

        <value>hdfs://localhost:9000</value>

    </property>

    <property>

        <name>hadoop.tmp.dir</name>

        <value>/mnt/hadoop/tmp</value>

    </property>

</configuration>
HADOOP_HOME/etc/hadoop/hdfs-site.xml
<configuration>

    <property>

        <name>dfs.replication</name>

        <value>1</value>

    </property>

    <property>

        <name>dfs.permissions</name>

        <value>false</value>

    </property>

    <property>

        <name>dfs.namenode.rpc-address</name>

        <value>192.168.1.1:9000</value>

    </property>

    <property>

        <name>dfs.datanode.data.dir</name>

        <value>/mnt/datanode</value>

    </property>

    <property>

        <name>dfs.namenode.name.dir</name>

        <value>/mnt/namenode</value>

    </property>

</configuration>
done
Learn ZYNQ(10) – zybo cluster word count的更多相关文章
- hadoop+tachyon+spark的zybo cluster集群综合配置
1.zybo cluster 架构简述: 1.1 zybo cluster 包含5块zybo 开发板组成一个集群,zybo的boot文件为digilent zybo reference design提 ...
- Learn ZYNQ (9)
创建zybo cluster的spark集群(计算层面): 1.每个节点都是同样的filesystem,mac地址冲突,故: vi ./etc/profile export PATH=/usr/loc ...
- MapReduce工作机制——Word Count实例(一)
MapReduce工作机制--Word Count实例(一) MapReduce的思想是分布式计算,也就是分而治之,并行计算提高速度. 编程思想 首先,要将数据抽象为键值对的形式,map函数输入键值对 ...
- Word Count作业
Word Count作业 一.个人Gitee地址:https://gitee.com/Changyu-Guo 二.项目简介 该项目主要是模拟Linux上面的wc命令,基本要求如下: 命令格式: wc. ...
- Word Count
Word Count 一.个人Gitee地址:https://gitee.com/godcoder979/(该项目完整代码在这里) 二.项目简介: 该项目是一个统计文件字符.单词.行数等数目的应用程序 ...
- Want to write a book? Use word count to stay on track
http://paloalto.patch.com/groups/maria-murnanes-blog/p/bp--want-to-write-a-book-use-word-count-to-st ...
- Hadoop AWS Word Count 样例
在AWS里用Elastic Map Reduce 开一个Cluster 然后登陆master node并编译下面程序: import java.io.IOException; import java. ...
- Hadoop Word Count程序
Hadoop Word Count程序 pom.xml文件: <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns ...
- 课堂练习 Word count
1. 团队介绍 团队成员:席梦寒,胡琦 2. 项目计划 我们选第一.二个功能点进行编程. 具体计划: (1).首先爬取网站内容及网页长度: (2).对爬取的文件内容进行word count操作: 3. ...
随机推荐
- [MapReduce] Google三驾马车:GFS、MapReduce和Bigtable
声明:此文转载自博客开发团队的博客,尊重原创工作.该文适合学分布式系统之前,作为背景介绍来读. 谈到分布式系统,就不得不提Google的三驾马车:Google FS[1],MapReduce[2],B ...
- 【荐】PHP Session和Cookie,Session阻塞,Session垃圾回收,Redis共享Session,不推荐Memcached保存Session
什么是 Session 在 web 应用开发中,Session 被称为会话.主要被用于保存某个访问者的数据. 由于 HTTP 无状态的特点,服务端是不会记住客户端的,对服务端来说,每一个请求都是全新的 ...
- PYTHON 写函数,检查用户传入的对象(字符串、列表、元组)的每一个元素是否含有空内容。
def shifou_space(args): ret = True for a in args: if a.isspace(): ret = False break return ret resul ...
- python之路十
协程协程,又称微线程,纤程.英文名Coroutine.一句话说明什么是线程:协程是一种用户态的轻量级线程.协程拥有自己的寄存器上下文和栈.协程调度切换时,将寄存器上下文和栈保存到其他地方,在切回来的时 ...
- 为什么operator>>(istream&, string&)能够安全地读入长度未知的字符串?
一般而言,实现"读入用户输入的字符串",程序中自然不能对用户输入的长度有所限定.这在C++中很容易实现,而在C中确没那么容易. 这一疑问,我在刚学C++的时候也在脑中闪现过:不过很 ...
- 6.openstack之mitaka搭建网络节点
部署网络服务 一:控制节点配置 1.建库建用户 mysql -u root -p CREATE DATABASE neutron; GRANT ALL PRIVILEGES ON neutron.* ...
- maven install 构建报错
错误:Failed to execute goal org.apache.maven.plugins:maven-compiler-plugin: 2.3 . 2 :compile ( default ...
- qt creator 源代码中含有中文编译报错
Tools-Options-Text Editor-Behavior-File Encoding-Default encoding:UTF-8 Tools-Options-Text Editor-Be ...
- .Net自带缓存Cache的使用
对于数据比较大,经常要从数据库拿出来用的,可以考虑使用.Net自带的缓存Cache,简单好用: //向内存中插入一个缓存 System.Web.HttpRuntime.Cache.Insert(&qu ...
- MyBatis学习(四)MyBatis和Spring整合
MyBatis和Spring整合 思路 1.让spring管理SqlSessionFactory 2.让spring管理mapper对象和dao. 使用spring和mybatis整合开发mapper ...