
chapter02 K近邻分类器对Iris数据进行分类预测
寻找与待分类的样本在特征空间中距离最近的K个已知样本作为参考,来帮助进行分类决策。
与其他模型最大的不同在于:该模型没有参数训练过程。无参模型,高计算复杂度和内存消耗。
#coding=utf8
# 从sklearn.datasets 导入 iris数据加载器。
from sklearn.datasets import load_iris
# 从sklearn.model_selection中导入train_test_split用于数据分割。
from sklearn.model_selection import train_test_split
# 从sklearn.preprocessing里选择导入数据标准化模块。
from sklearn.preprocessing import StandardScaler
# 从sklearn.neighbors里选择导入KNeighborsClassifier,即K近邻分类器。
from sklearn.neighbors import KNeighborsClassifier
# 依然使用sklearn.metrics里面的classification_report模块对预测结果做更加详细的分析。
from sklearn.metrics import classification_report

iris = load_iris()
# 从使用train_test_split,利用随机种子random_state采样25%的数据作为测试集。
X_train, X_test, y_train, y_test = train_test_split(iris.data, iris.target, test_size=0.25, random_state=33)

# 对训练和测试的特征数据进行标准化。
ss = StandardScaler()
X_train = ss.fit_transform(X_train)
X_test = ss.transform(X_test)

# 使用K近邻分类器对测试数据进行类别预测,预测结果储存在变量y_predict中。
knc = KNeighborsClassifier()
knc.fit(X_train, y_train)
y_predict = knc.predict(X_test)
# 使用模型自带的评估函数进行准确性测评。
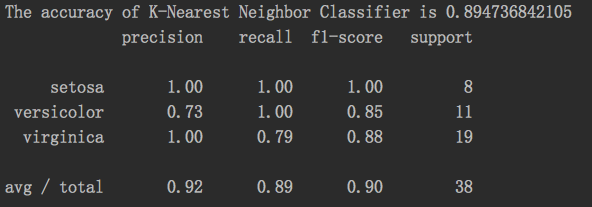
print 'The accuracy of K-Nearest Neighbor Classifier is', knc.score(X_test, y_test)
print classification_report(y_test, y_predict, target_names=iris.target_names)
结果:
chapter02 K近邻分类器对Iris数据进行分类预测的更多相关文章
- 机器学习之路: python k近邻分类器 KNeighborsClassifier 鸢尾花分类预测
使用python语言 学习k近邻分类器的api 欢迎来到我的git查看源代码: https://github.com/linyi0604/MachineLearning from sklearn.da ...
- 机器学习 —— 基础整理(三)生成式模型的非参数方法: Parzen窗估计、k近邻估计;k近邻分类器
本文简述了以下内容: (一)生成式模型的非参数方法 (二)Parzen窗估计 (三)k近邻估计 (四)k近邻分类器(k-nearest neighbor,kNN) (一)非参数方法(Non-param ...
- 最近邻分类器,K近邻分类器,线性分类器
转自:https://blog.csdn.net/oldmao_2001/article/details/90665515 最近邻分类器: 通俗来讲,计算测试样本与所有样本的距离,将测试样本归为距离最 ...
- sklearn.neighbors.KNeighborsClassifier(k近邻分类器)
KNeighborsClassifier参数说明KNeighborsClassifier(n_neighbors=5, weights='uniform', algorithm='auto', lea ...
- Python机器学习(基础篇---监督学习(k近邻))
K近邻 假设我们有一些携带分类标记的训练样本,分布于特征空间中,对于一个待分类的测试样本点,未知其类别,按照‘近朱者赤近墨者黑’,我们需要寻找与这个待分类的样本在特征空间中距离最近的k个已标记样本作为 ...
- 02-16 k近邻算法
目录 k近邻算法 一.k近邻算法学习目标 二.k近邻算法引入 三.k近邻算法详解 3.1 k近邻算法三要素 3.1.1 k值的选择 3.1.2 最近邻算法 3.1.3 距离度量的方式 3.1.4 分类 ...
- 机器学习实战python3 K近邻(KNN)算法实现
台大机器技法跟基石都看完了,但是没有编程一直,现在打算结合周志华的<机器学习>,撸一遍机器学习实战, 原书是python2 的,但是本人感觉python3更好用一些,所以打算用python ...
- sklearn机器学习算法--K近邻
K近邻 构建模型只需要保存训练数据集即可.想要对新数据点做出预测,算法会在训练数据集中找到最近的数据点,也就是它的“最近邻”. 1.K近邻分类 #第三步导入K近邻模型并实例化KN对象 from skl ...
- 1. cs231n k近邻和线性分类器 Image Classification
第一节课大部分都是废话.第二节课的前面也都是废话. First classifier: Nearest Neighbor Classifier 在一定时间,我记住了输入的所有的图片.在再次输入一个图片 ...
随机推荐
- 新开发项目Jacoco代码覆盖率
一般只有新的项目才会去用JaCoCo工具看一下代码覆盖率, 一来看看测试有没有漏的测试用例 二来看看开发有没有留下冗余的代码 新开发项目Jacoco代码覆盖率后端接口打成jar包,进行启动 #exec ...
- MongoDB(课时6 关系查询)
支持关系查询操作:大于($gt),小于($lt),大于等于($gte),小于等于($lte),不等于($ne ),等于(key:value 或 $eq).想让这些操作正常使用,需要准备一个数据集合. ...
- bcompare Linux版 无限试用
需要root权限. # mv /usr/bin/bcompare /usr/bin/bcompare.real # cat /usr/bin/bcompare #!/bin/sh rm " ...
- scss 覆盖 原有变量
在scss的variables.scss 中会有很多的变量 $color: red !default; $body-color: $color !default; 这些!default 和我们理解的! ...
- mRNA基本概念
mRNA是由DNA的一条链转录而来的(可以是正链,也可以是反链),DNA是由非编码区和编码区组成,编码区也有其特殊的结构,主要有外显子和内含子组成. mRNA的一个重要性质就是可变剪切,也就是同一个编 ...
- JS-Object(3) 继承(prototype方式, 类方式); javascript6的知识(部分)
原型方式的继承 创建child object classes(constructors) , 子类如何从父类中继承特性. 原型链继承prototypal inheritance (ruby中的继承也是 ...
- PHP函数总结 (四)
<?php/** * 引用参数: * 1.PHP默认按值传递参数,父程序(调用函数)与子程序(函数)的数值分别存储与不同的内存区块: * 2.引用传递参数,加符号 & :它是把父程序的数 ...
- Up and Down the Tree CodeForces - 1065F (树形dp)
链接 题目大意:给定$n$结点树, 假设当前在结点$v$, 有两种操作 $(1)$移动到$v$的子树内任意一个叶子上 $(2)$若$v$为叶子, 可以移动到距离$v$不超过$k$的祖先上 初始在结点$ ...
- Python的第二次作业
羊车门问题 1.我认为 会 增加选中汽车的机会,原因如下: 不换的情况:对于参赛者而言无论选哪一扇门都有1/3的几率能获得车子. 换的情况 :对于参赛者而言,有两种情况「1.参赛者第一次就选择到了正 ...
- thinkphp3.2 输入框默认值
1,我们在做项目的时候输入框有的时候要提示用户输入什么,当用户输入值的时候也不用客户删除,用户只管输入.这里我们就用一个很简单的就OK了. <input type="text" ...