
sklearn机器学习算法--K近邻
K近邻
构建模型只需要保存训练数据集即可。想要对新数据点做出预测,算法会在训练数据集中找到最近的数据点,也就是它的“最近邻”。
1、K近邻分类
#第三步导入K近邻模型并实例化KN对象

from sklearn.neighbors import KNeighborsClassifier

#其中n_neighbors为近邻数量

clf = KNeighborsClassifier(n_neighbors=3)
#第四步对训练集进行训练

clf.fit(X_train,y_train)
#查看训练集和测试集的精确度

clf.score(X_train,y_train)
#建立一个有一行三列组成的图组,每个图的大小是10×3

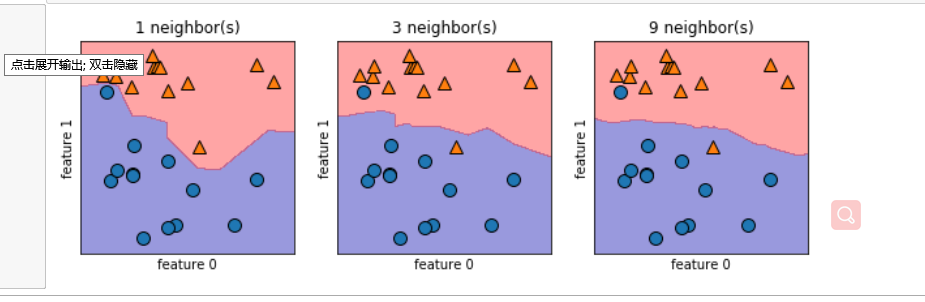
fig, axes = plt.subplots(1,3,figsize=(10,3))

for n_neighbors,ax in zip([1,3,9],axes):

    #实例化模型对象并对数据进行训练

    clf = KNeighborsClassifier(n_neighbors=n_neighbors).fit(X,y)

    mglearn.plots.plot_2d_separator(clf, X, fill=True, eps=0.5, ax=ax, alpha=.4)

    mglearn.discrete_scatter(X[:,0],X[:,1],y,ax=ax)

    ax.set_title("{} neighbor(s)".format(n_neighbors))

    ax.set_xlabel("feature 0")

    ax.set_ylabel("feature 1")
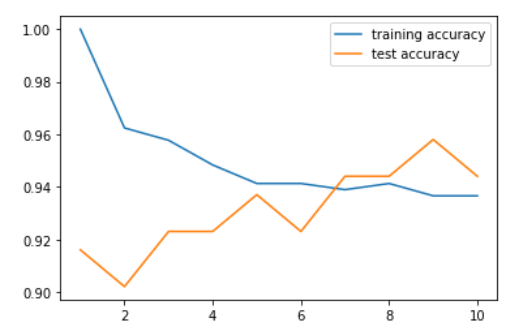
针对乳腺癌数据进行不同近邻的精确度分析
#加载乳腺癌数据

from sklearn.datasets import load_breast_cancer

#提取数据

cancer = load_breast_cancer()

#第一步将数据分为训练集和测试集

X_train,X_test,y_train,y_test = train_test_split(cancer.data,cancer.target,random_state = 0)

#实例化不同近邻的KN对象

neighbors_settings = range(1,11)

training_accuracy = []

test_accuracy = []

for n_neighbors in neighbors_settings:

    clf = KNeighborsClassifier(n_neighbors=n_neighbors).fit(X_train,y_train)

    training_accuracy.append(clf.score(X_train,y_train))

    test_accuracy.append(clf.score(X_test,y_test))

plt.plot(neighbors_settings,training_accuracy,label='training accuracy')

plt.plot(neighbors_settings,test_accuracy,label='test accuracy')

plt.legend()
2、K近邻回归
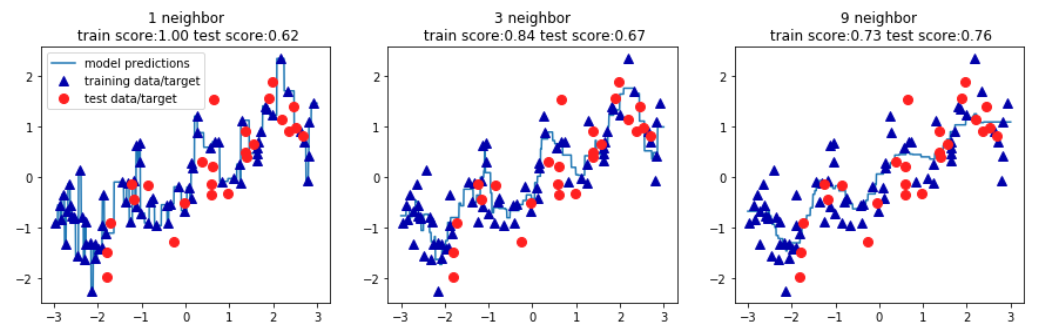
针对wave数据进行K近邻回归演示
#导入wave数据

X,y = mglearn.datasets.make_wave()

#将数据分为训练集和测试集

X_train,X_test,y_train,y_test = train_test_split(X,y, random_state = 0)

#导入KN模型
from sklearn.neighbors import KNeighborsRegressor
#实例化KN模型
reg = KNeighborsRegressor(n_neighbors=3)
#对训练集进行训练
reg.fit(X_train,y_train)
#查看模型的精度
reg.score(X_test,y_test)

#创建一个有一行三列组成的图组,每个图的大小为15×4

fig, axes = plt.subplots(1,3,figsize=(15,4))

#创建1000个数据点,分布在-3和3之间

lines=np.linspace(-3,3,1000).reshape(-1,1)

for n_neighbors, ax in zip([1,3,9],axes):

    reg = KNeighborsRegressor(n_neighbors=n_neighbors).fit(X_train,y_train)

    ax.plot(lines,reg.predict(lines))

    ax.plot(X_train,y_train,'^',c=mglearn.cm2(0),markersize=8)

    ax.plot(X_test,y_test,'o',c=mglearn.cm2(1),markersize=8)

    ax.set_title('{} neighbor\n train score:{:.2f} test score:{:.2f}'.format(n_neighbors,reg.score(X_train,y_train),

                                                                            reg.score(X_test,y_test)))

axes[0].legend(['model predictions','training data/target','test data/target'])
sklearn机器学习算法--K近邻的更多相关文章
- 每日一个机器学习算法——k近邻分类
K近邻很简单. 简而言之,对于未知类的样本,按照某种计算距离找出它在训练集中的k个最近邻,如果k个近邻中多数样本属于哪个类别,就将它判决为那一个类别. 由于采用k投票机制,所以能够减小噪声的影响. 由 ...
- 机器学习之K近邻算法(KNN)
机器学习之K近邻算法(KNN) 标签: python 算法 KNN 机械学习 苛求真理的欲望让我想要了解算法的本质,于是我开始了机械学习的算法之旅 from numpy import * import ...
- 第4章 最基础的分类算法-k近邻算法
思想极度简单 应用数学知识少 效果好(缺点?) 可以解释机器学习算法使用过程中的很多细节问题 更完整的刻画机器学习应用的流程 distances = [] for x_train in X_train ...
- 【机器学习】k近邻算法(kNN)
一.写在前面 本系列是对之前机器学习笔记的一个总结,这里只针对最基础的经典机器学习算法,对其本身的要点进行笔记总结,具体到算法的详细过程可以参见其他参考资料和书籍,这里顺便推荐一下Machine Le ...
- 机器学习(四) 分类算法--K近邻算法 KNN (上)
一.K近邻算法基础 KNN------- K近邻算法--------K-Nearest Neighbors 思想极度简单 应用数学知识少 (近乎为零) 效果好(缺点?) 可以解释机器学习算法使用过程中 ...
- 机器学习之K近邻算法
K 近邻 (K-nearest neighbor, KNN) 算法直接作用于带标记的样本,属于有监督的算法.它的核心思想基本上就是 近朱者赤,近墨者黑. 它与其他分类算法最大的不同是,它是一种&quo ...
- 第四十六篇 入门机器学习——kNN - k近邻算法(k-Nearest Neighbors)
No.1. k-近邻算法的特点 No.2. 准备工作,导入类库,准备测试数据 No.3. 构建训练集 No.4. 简单查看一下训练数据集大概是什么样子,借助散点图 No.5. kNN算法的目的是,假如 ...
- python 机器学习(二)分类算法-k近邻算法
一.什么是K近邻算法? 定义: 如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别. 来源: KNN算法最早是由Cover和Hart提 ...
- 机器学习(四) 机器学习(四) 分类算法--K近邻算法 KNN (下)
六.网格搜索与 K 邻近算法中更多的超参数 七.数据归一化 Feature Scaling 解决方案:将所有的数据映射到同一尺度 八.scikit-learn 中的 Scaler preprocess ...
随机推荐
- RabbitMQ学习笔记一
前 言 -解决问题 一.RabbitMQ安装 1.安装erlang 环境 a.下载erlang 版本,注意这里需要和安装的rabbitMq版本相配对,rabbitMQ官方网站上可以查到:https ...
- 图解MySQL索引(二)—为什么使用B+Tree
失踪人口回归,近期换工作一波三折,耽误了不少时间,从今开始每周更新~ 索引是一种支持快速查询的数据结构,同时索引优化也是后端工程师的必会知识点.各个公司都有所谓的MySQL"军规" ...
- jchdl-GSL-实例 - 使用Intellij IDEA创建Mux
https://mp.weixin.qq.com/s/yP9xKeg0iHJChuMPzxdJtA https://github.com/wjcdx/jchdl/blob/master/src/org ...
- 对象调用 push 方法
/* Array.prototype.push = function A(val) { this[this.length] = val; // =>this.length 在原来的基础上加1 r ...
- JavaSE(二) 关键字、标识符、注释
个人博客网:https://wushaopei.github.io/ (你想要这里多有) 1关键字与标识符 1.1 java关键字的使用 定义:被Java语言赋予了特殊含义,用做专门用途的字符串 ...
- Java实现 LeetCode 454 四数相加 II
454. 四数相加 II 给定四个包含整数的数组列表 A , B , C , D ,计算有多少个元组 (i, j, k, l) ,使得 A[i] + B[j] + C[k] + D[l] = 0. 为 ...
- Android如何使用SharedPreferences轻量级储存
SharedPreferences只能用来存一些基本数据类型,并且存下的量比较小 直接附代码 和XMl布局 package com.example.okhttpdemo; import android ...
- java实现第六届蓝桥杯五星填数
五星填数 如[图1.png]的五星图案节点填上数字:1~12,除去7和11. 要求每条直线上数字和相等. 如图就是恰当的填法. 请你利用计算机搜索所有可能的填法有多少种. 注意:旋转或镜像后相同的算同 ...
- bootargs说明 和 下位机静态ip的设置
setenv bootargs root=/dev/nfs nfsroot=192.168.1.8:/opt/rootfs ip=192.168.1.110:192.168.1. ...
- 环境篇:呕心沥血@CDH线上调优
环境篇:呕心沥血@线上调优 为什么出这篇文章? 近期有很多公司开始引入大数据,由于各方资源有限,并不能合理分配服务器资源,和服务器选型,小叶这里将工作中的总结出来,给新入行的小伙伴带个方向,不敢说一定 ...