
01-scrapy框架
1.Scrapy图例:
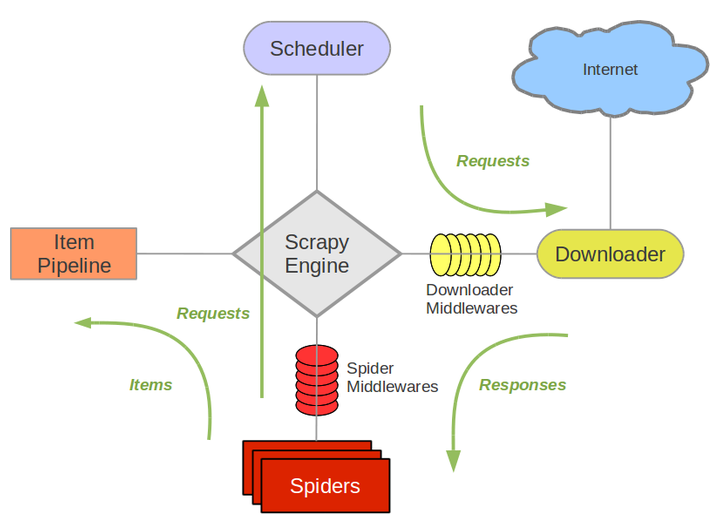
Scrapy Engine(引擎): 负责Spider、ItemPipeline、Downloader、Scheduler中间的通讯,信号、数据传递等。
Scheduler(调度器): 它负责接受引擎发送过来的Request请求,并按照一定的方式进行整理排列,入队,当引擎需要时,交还给引擎。
Downloader(下载器):负责下载Scrapy Engine(引擎)发送的所有Requests请求,并将其获取到的Responses交还给Scrapy Engine(引擎),由引擎交给Spider来处理,
Spider(爬虫):它负责处理所有Responses,从中分析提取数据,获取Item字段需要的数据,并将需要跟进的URL提交给引擎,再次进入Scheduler(调度器),
Item Pipeline(管道):它负责处理Spider中获取到的Item,并进行进行后期处理(详细分析、过滤、存储等)的地方.
Downloader Middlewares(下载中间件):一个可以自定义扩展下载功能的组件。
Spider Middlewares(Spider中间件):是一个可以自定扩展和操作引擎和Spider中间通信的功能组件(比如进入Spider的Responses;和从Spider出去的Requests)
************************上述内容是对scrapy框架的一个简单介绍,内容摘自网络****************************
*****************************************************************************************
*********************下述内容为scrapy命令信息,以及爬虫起送后的信息做一简单的整理和描述********************
1、我们通过pip install scrapy安装好scrapy以后在终端键入scrapy,就会显示如下信息:
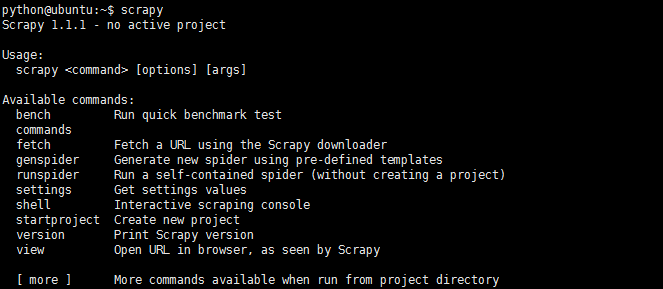
1).bench:快速测试当前硬件环境的性能,对于爬虫来说我们可以主要关注两个方面,一个是IO性能,一方面cpu的性能,IO主要取决于请求发送和相应的接收,cpu性能越强我们解析数据的速度就会越快
2).fetch:快速测试一个url地址是否能够使用,scrapy fetch 'http://www.baidu.com'
3).genspider:创建爬虫文件
4).runspider:运行爬虫
5).获取settings.py中某个字段的信息
6).shell终端界面,可用shell对我们设定的页面提取规则进行调试
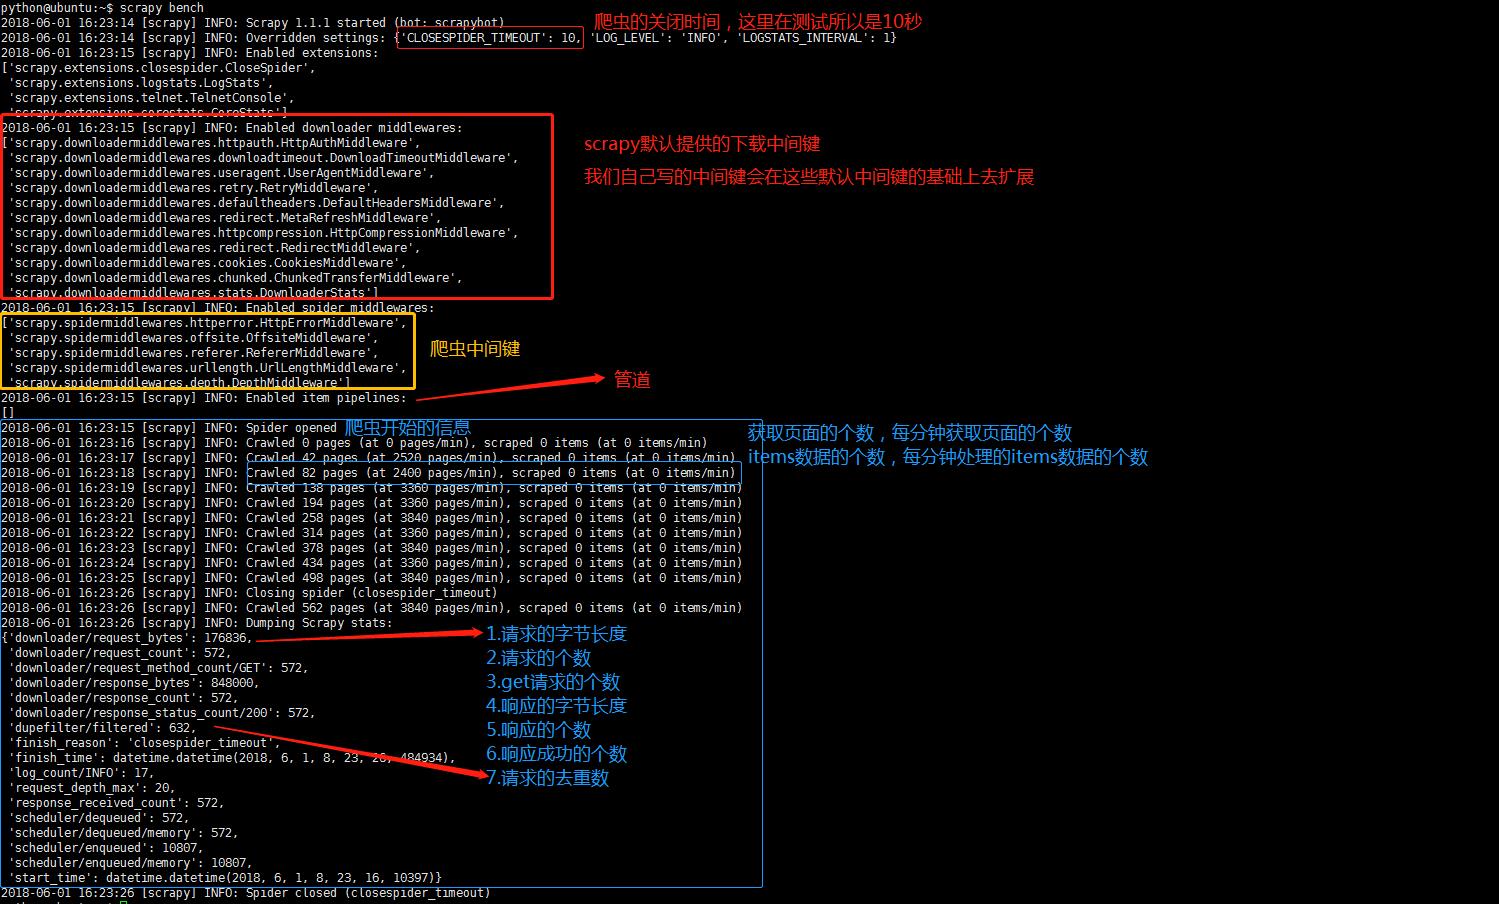
以scrapy bench为例,展示一下爬虫启动后的预加载信息以及具体的爬虫信息
01-scrapy框架的更多相关文章
- 基于Scrapy框架的Python新闻爬虫
概述 该项目是基于Scrapy框架的Python新闻爬虫,能够爬取网易,搜狐,凤凰和澎湃网站上的新闻,将标题,内容,评论,时间等内容整理并保存到本地 详细 代码下载:http://www.demoda ...
- Scrapy框架学习参考资料
00.Python网络爬虫第三弹<爬取get请求的页面数据> 01.jupyter环境安装 02.Python网络爬虫第二弹<http和https协议> 03.Python网络 ...
- Python 爬取 北京市政府首都之窗信件列表-[Scrapy框架](2020年寒假小目标04)
日期:2020.01.22 博客期:130 星期三 [代码说明,如果要使用此页代码,必须在本博客页面评论区给予说明] //博客总体说明 1.准备工作(本期博客) 2.爬取工作 3.数据处理 4.信息展 ...
- Java多线程系列--“JUC锁”01之 框架
本章,我们介绍锁的架构:后面的章节将会对它们逐个进行分析介绍.目录如下:01. Java多线程系列--“JUC锁”01之 框架02. Java多线程系列--“JUC锁”02之 互斥锁Reentrant ...
- java多线程系类:JUC锁:01之框架
本章,我们介绍锁的架构:后面的章节将会对它们逐个进行分析介绍.目录如下:01. Java多线程系列--"JUC锁"01之 框架02. Java多线程系列--"JUC锁&q ...
- Python爬虫Scrapy框架入门(2)
本文是跟着大神博客,尝试从网站上爬一堆东西,一堆你懂得的东西 附上原创链接: http://www.cnblogs.com/qiyeboy/p/5428240.html 基本思路是,查看网页元素,填写 ...
- Python爬虫Scrapy框架入门(1)
也许是很少接触python的原因,我觉得是Scrapy框架和以往Java框架很不一样:它真的是个框架. 从表层来看,与Java框架引入jar包.配置xml或.property文件不同,Scrapy的模 ...
- Java 集合系列 01 总体框架
java 集合系列目录: Java 集合系列 01 总体框架 Java 集合系列 02 Collection架构 Java 集合系列 03 ArrayList详细介绍(源码解析)和使用示例 Java ...
- Scrapy框架使用—quotesbot 项目(学习记录一)
一.Scrapy框架的安装及相关理论知识的学习可以参考:http://www.yiibai.com/scrapy/scrapy_environment.html 二.重点记录我学习使用scrapy框架 ...
- Python爬虫从入门到放弃(十一)之 Scrapy框架整体的一个了解
这里是通过爬取伯乐在线的全部文章为例子,让自己先对scrapy进行一个整理的理解 该例子中的详细代码会放到我的github地址:https://github.com/pythonsite/spider ...
随机推荐
- Sqlserver限制用户访问指定数据库
USE master CREATE LOGIN test --要创建的用户名 WITH PASSWORD = '123456', --密码 DEFAULT_DATABASE = DBTest, --指 ...
- python-day8(正式学习)
目录 列表类型内置方法 常用操作+内置方法 优先掌握(***) 需要掌握(**) 存一个值or多个值 有序or无序 可变or不可变 元组类型内置方法 定义 常用操作+内置方法 优先掌握 一个值or多个 ...
- TCP协议的粘包现象和解决方法
# 粘包现象 # serverimport socket sk = socket.socket()sk.bind(('127.0.0.1', 8005))sk.listen() conn, addr ...
- Ubuntu下火狐浏览器播放视频出现解码问题
问题描述 点击视频播放按钮,视频不会出现缓冲条,也没任何提示,视频界面就一直是黑屏的状态.右键该视频界面,选择检查元素,点击控制台,发现如下问题: The video on this page can ...
- php Excel 导入
php Excel 导入 public function storeSql() { $file = input('file.excel'); $path = ROOT_PATH . 'public' ...
- 元素定位--firebug安装
1.火狐浏览器调试工具firebug插件的安装 打开浏览器---添加组件---搜索firebug
- Linux等操作系统杂谈
这部分基本上都是感性认识,介绍一下发展历史什么的.所以基本上都不是我原创的,转载来源都标记在文中了,如果侵权的话请联系删除 操作系统发展历史吃瓜 <Unix.Windows.Mac OS.Lin ...
- Scala学习笔记(3)
数组 ----------------------------------- 0.若长度固定则用Array,若长度可能变化则使用ArrayBuffer 1.提供初始值的时候不要使用new. 2.用() ...
- 扇形导航 css3
本篇文章将通过对css3中的2d变化以及过渡进行分析设计 先放上最终效果图 功能实现:1.给扇形home元素设置点击事件并添加2d旋转 2.给导航栏设置2d旋转 并通过 ...
- $id(id)函数
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/ ...