
PCA 主成分分析(Principal components analysis )
问题
1、 比如拿到一个汽车的样本,里面既有以“千米/每小时”度量的最大速度特征,也有“英里/小时”的最大速度特征,显然这两个特征有一个多余。
2、 拿到一个数学系的本科生期末考试成绩单,里面有三列,一列是对数学的兴趣程度,一列是复习时间,还有一列是考试成绩。我们知道要学好数学,需要有浓厚的兴趣,所以第二项与第一项强相关,第三项和第二项也是强相关。那是不是可以合并第一项和第二项呢?
3、 拿到一个样本,特征非常多,而样例特别少,这样用回归去直接拟合非常困难,容易过度拟合。比如北京的房价:假设房子的特征是(大小、位置、朝向、是否学区房、建造年代、是否二手、层数、所在层数),搞了这么多特征,结果只有不到十个房子的样例。要拟合房子特征‐>房价的这么多特征,就会造成过度拟合。
4、 这个与第二个有点类似, 假设在 IR 中我们建立的文档‐词项矩阵中, 有两个词项为 “learn”和“study” ,在传统的向量空间模型中,认为两者独立。然而从语义的角度来讲,两者是相似的,而且两者出现频率也类似,是不是可以合成为一个特征呢?
5、 在信号传输过程中,由于信道不是理想的,信道另一端收到的信号会有噪音扰动,那么怎么滤去这些噪音呢?
- 剔除和类标签无关的特征,比如“学生的名字”就和他的“成绩”无关,使用的是互信息的方法。
- 剔除和类标签有关的,但里面存在噪声或者冗余的特征。在这种情况下,需要一种特征降维的方法来减少特征数,减少噪音和冗余,减少过度拟合的可能性。
备注:互信息——指两个事件集合之间的相关性。
两个事件X和Y的互信息定义为:I(X,Y) = H(X) + H(Y) - H(X,Y)
其中 H(X,Y) 是联合熵(Joint Entropy),其定义为:H(X,Y) = - ∑ p(x,y)logp(x,y)
特征降维——去掉可分性不强和冗余的特征
PCA 的思想
将 n维特征映射到 k 维上(k<n) ,这 k 维是全新的正交特征。这 k 维特征称为主元,是重新构造出来的 k 维特征,而不是简单地从 n 维特征中去除其余 n‐k 维特征。
算法思想:最大方差理论、最小平方误差理论、坐标轴相关度理论
PCA 计算过程
假设我们得到的 2 维数据如下:

行代表样例,列代表特征,这里有 10 个样例,每个样例两个特征。
第一步,分别求 x 和 y 的平均值,然后对于所有的样例,都减去对应的均值。
这里 x 的均值是 1.81,y 的均值是 1.91,减去后得到
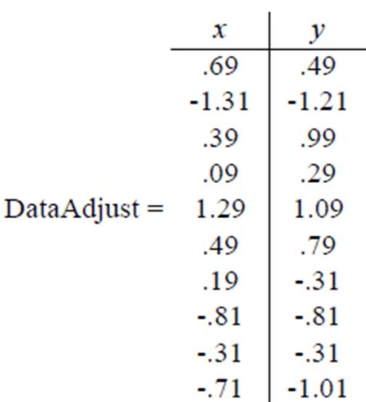
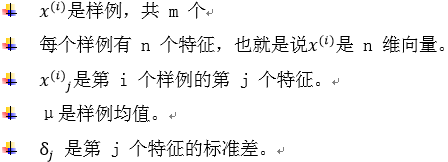
若样本特征之间的方差存在明显差异,需要对特征做方差归一化(可省略)。求每个特征的标准差σ,然后对每个样例在该特征下的数据除以σ。
第二步,求特征协方差矩阵。
如果数据是 3 维,那么协方差矩阵是
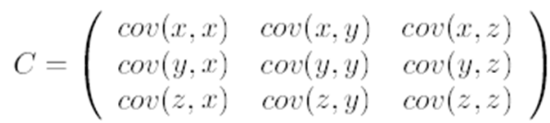
这里只有 x 和 y,求解得

注:对角线上分别是 x 和 y 的方差,非对角线上是协方差。
l 协方差 > 0时,表示 x 和 y 若有一个增,另一个也增;
l 协方差 < 0时,表示一个增,一个减;
l 协方差 = 0 时,两者独立。
l 协方差绝对值越大,两者对彼此的影响越大,反之越小。
求解协方差流程:
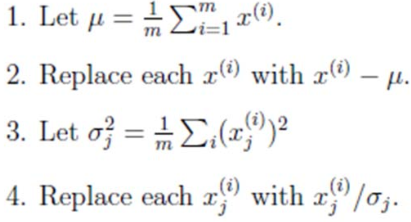
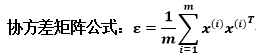
第三步,求协方差的特征值和特征向量,得到
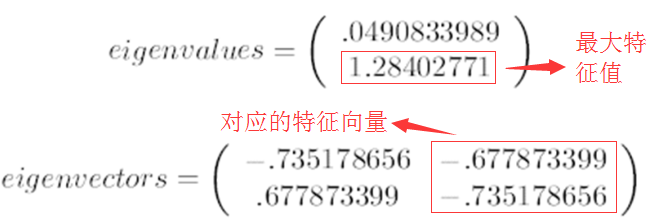
这里的特征向量都归一化为单位向量。
第四步,将特征值按照从大到小的顺序排序,选择其中最大的 k 个,然后将其对应的 k个特征向量分别作为列向量组成特征向量矩阵。
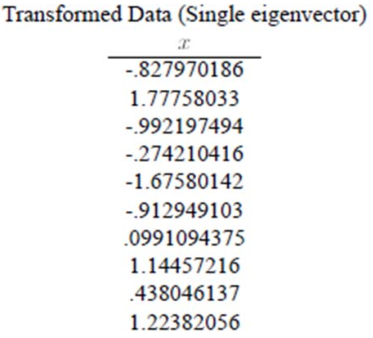
第五步,将样本点投影到选取的特征向量上。
假设样例数为 m,特征数为 n,减去均值后的样本矩阵为 DataAdjust(m*n),协方差矩阵是 n*n,选取的 k 个特征向量组成的矩阵为EigenVectors(n*k)。
那么投影后的数据为

这样,就将原始样例的 n 维特征变成了 k 维,这 k 维就是原始特征在 k 维上的投影。
本案例令k=1,得到结果:
PCA 理论基础
最大方差理论
在信号处理中认为信号具有较大的方差, 噪声有较小的方差, 信噪比就是信号与噪声的方差比,越大越好。
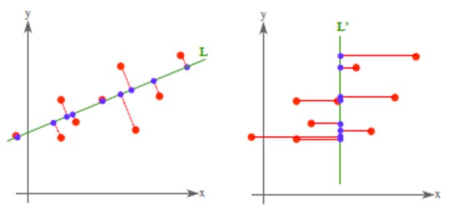
如下图所示,样本在横轴上的投影方差较大, 在纵轴上的投影方差较小,那么认为纵轴上的投影是由噪声引起的。因此我们认为,最好的k维特征,是将n维样本点转换为k维后,每一维上的样本方差都很大。

对于下图的5个样本点,假设我们选择两条不同的直线做投影。根据方差最大化理论,左边的好,因为左边投影后的样本点之间的方差最大。
投影
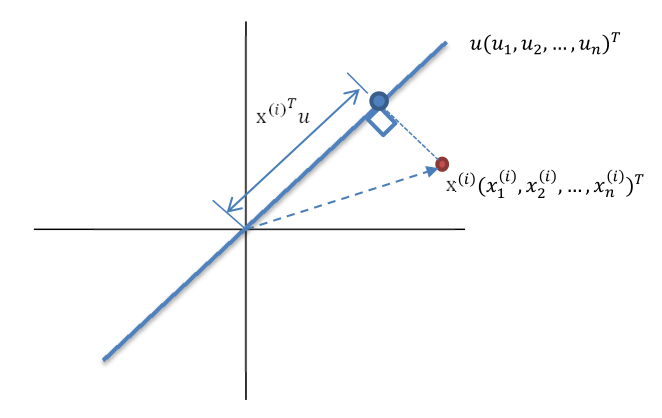
1) 红色点表示样例
2) 蓝色点是在u上的投影点,离原点的距离是<>(即或)
3) u是直线的斜率,也是直线的方向向量,而且是单位向量。
4) 样本点(样例)的每一维特征的均值,和投影到 u上的样本点的均值相等。
最佳的投影向量u,可以使得投影后的样本点方差最大。
在本案例中,已知均值为0,因此方差为
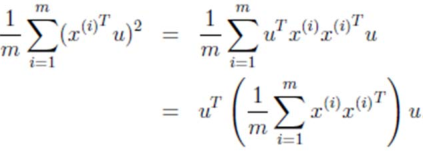
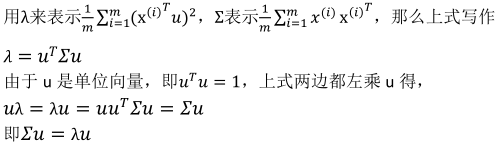
因此,λ就是Σ的特征值,u 是特征向量。最佳的投影直线,是特征值λ最大时对应的特征向量。我们只需要对协方差矩阵进行特征值分解,得到的前 k 大特征值对应的特征向量就是最佳的k维新特征,而且这k维新特征是正交的。
获得的新样本为: ,其中的第 j 维就是在上的投影。
通过选取最大的 k 个 u,使得方差较小的特征(如噪声)被丢弃。
最小平方误差理论

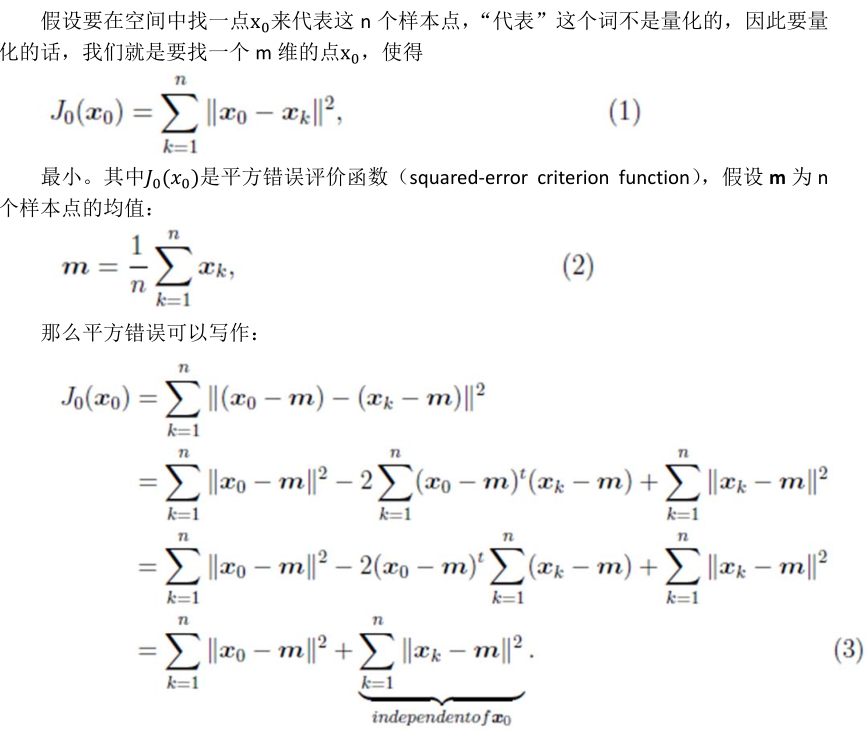
假设有这样的二维样本点(红色点),通过线性回归求一个线性函数,使得直线能够最佳拟合样本点。回归时,最小二乘法度量的是样本点到直线的坐标轴距离。
比如这个问题中,特征是 x,类标签是 y。回归时最小二乘法度量的是距离 d。如果使用回归方法来度量最佳直线,那么就是直接在原始样本上做回归了,跟特征选择就没什么关系了。因此,我们打算选用另外一种评价直线好坏的方法,使用点到直线的距离 d’ 来度量。
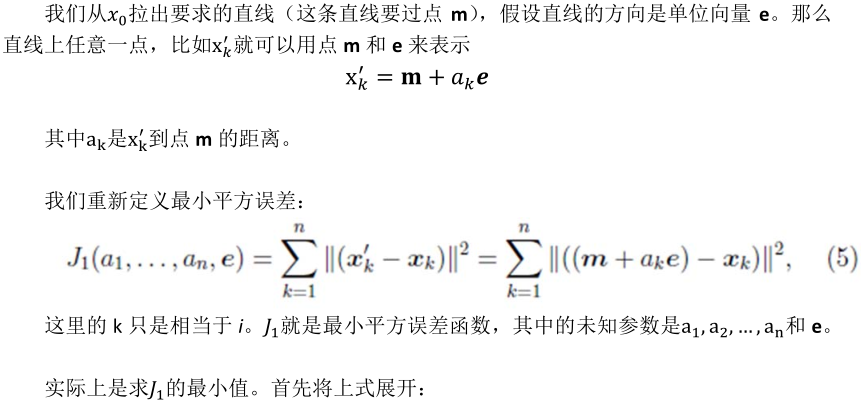
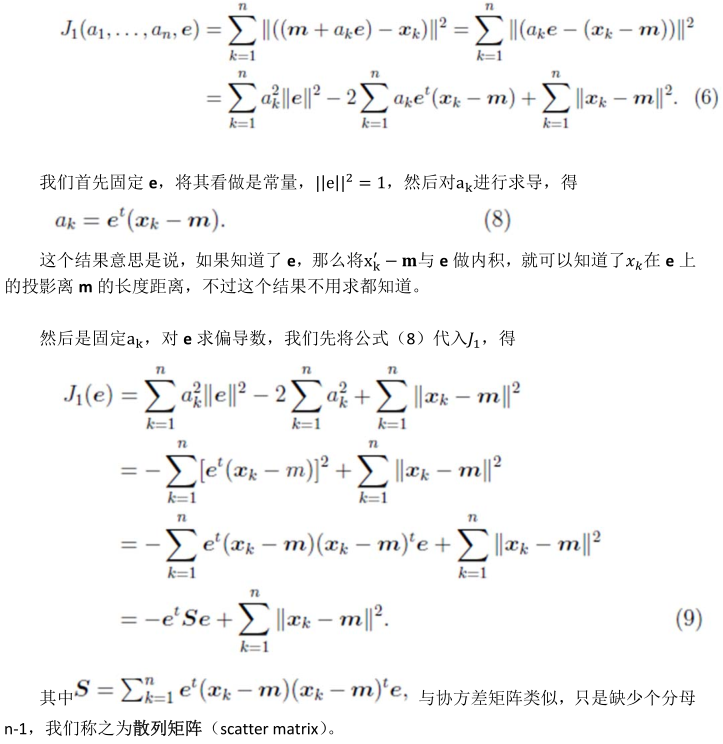
现在有 n 个样本点 ,每个样本点为 m 维。将样本点在直线上的投影记为,那么我们就是要最小化
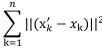
这个公式称作最小平方误差(Least Squared Error)。而确定一条直线,一般只需要确定一个点,并且确定方向即可。
第一步,确定点:
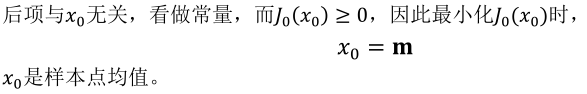
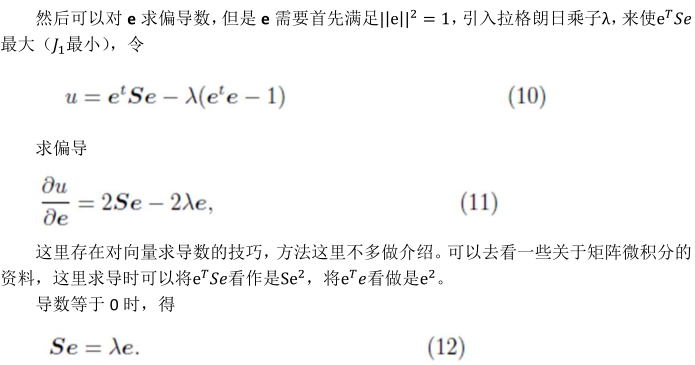
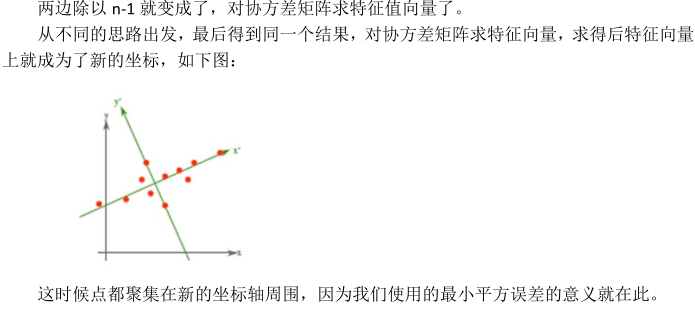
总结与讨论
1) PCA 技术的一大好处,是对数据进行降维的处理。我们可以对新求出的“主元”向量的重要性进行排序,根据需要取前面最重要的部分,将后面的维数省去,可以达到降维,从而达到简化模型或对数据进行压缩的效果,同时最大程度的保持了原有数据的信息。
2) PCA 技术的一个很大的优点是,它是完全无参数限制的。在 PCA 的计算过程中完全不需要人为的设定参数或是根据任何经验模型对计算进行干预,最后的结果只与数据相关,与用户是独立的。
3) 但是,这一点同时也可以看作是缺点。如果用户对观测对象有一定的先验知识,掌握了数据的一些特征,却无法通过参数化等方法对处理过程进行干预,可能会得不到预期的效果,效率也不高。
4) PCA 还可以用于预测矩阵中缺失的元素。
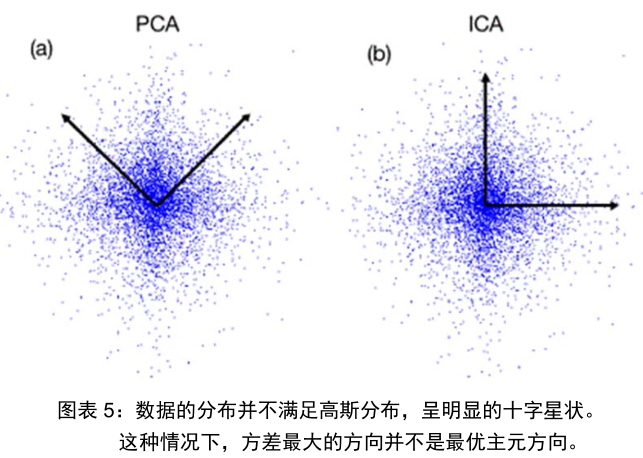
5) 有时数据的分布并不是满足高斯分布。在非高斯分布的情况下,PCA方法得出的主元可能并不是最优的。
6) 在寻找主元时,不能将方差作为衡量重要性的标准。要根据数据的分布情况,选择合适的描述完全分布的变量,然后根据概率分布式 ,来计算两个向量上数据分布的相关性。等价的,保持主元间的正交假设,寻找的主元同样要使
 。这一类方法被称为独立主元分解(ICA)。
MATLAB
函数说明
1、cov_x=cov(x) %求取x的协方差矩阵
2、[V,D] = eig(cov_x) %矩阵V为特征向量,D为特征值(对比上面的latent)组成的对角线矩阵
3、example = fix(rand(10,3)*50); %获取一个10*3的随机矩阵
4、dim1 = example(:,1); %为第一(列)维特征命名
5、mean(dim1) %求每一列的均值
mean(dim1,2) %求每一行的均值
6、std(dim1)^2 %求方差
7、row=size(A,1) · %该语句返回的是矩阵A的行数
col=size(A,2) %该语句返回的是矩阵A的列数
8、B=repmat(A,m,n) %将矩阵 A 复制 m×n 块,即把 A 作为 B 的元素,B 由 m×n 个 A 平铺而成。B 的维数是 [size(A,1)*m, (size(A,2)*n]
9、行为元组,列为属性
10、pareto 柏拉图
具体实现
%获取10*3随机数据源
MySample = fix(rand(10,3)*50);
%为每一列命名
dim1 = MySample(:,1);
dim2 = MySample(:,2);
dim3 = MySample(:,3);
%方差归一化
MySample= zscore(MySample);
%计算协方差
sum((dim1-mean(dim1)) * (dim2-mean(dim2))) / ( size(MySample,1)-1 )
sum((dim1-mean(dim1)) * (dim3-mean(dim3))) / ( size(MySample,1)-1 )
sum((dim2-mean(dim2)) * (dim3-mean(dim3))) / ( size(MySample,1)-1 )
%计算方差
std(dim1)^2
std(dim2)^2
std(dim3)^2
%计算协方差矩阵,验证结果
%方法1
C = cov(MySample)
%方法2
X = MySample- repmat(mean(MySample),10,1); % 中心化样本矩阵
C = (X'*X)/(size(X,1)-1)
%计算协方差矩阵的特征向量和特征值
[V,D] = eig(C)
latent = sort(eig(cov(MySample)),'descend'); %贡献率(一维),从大到小排序
%选择成分组成模式矢量
%得到降维后的数据
[coef,score,latent,tsquare]=princomp(MySample) %PCA降维处理
%coef:为系数矩阵,即表示输入矩阵x是如何转换成score矩阵的。
%score:主元分析加工后的数据。
%latent:一维向量,贡献率,等同于协方差矩阵的特征值,按照从大到小的顺序排列的。
%MySample:即PCA函数的输入矩阵。
%可视化( 图中的线表示累积变量解释程度,柱状表示对应成分)
figure;
percent_explained = 100*latent/sum(latent);
pareto(percent_explained);
xlabel('Principal Component');
ylabel('Variance Explained (%)');
print -djpeg 2;
WEKA
weka.filters.unsupervised.attribute.PrincipalComponents
PCA 主成分分析(Principal components analysis )的更多相关文章
- 主成分分析 | Principal Components Analysis | PCA
理论 仅仅使用基本的线性代数知识,就可以推导出一种简单的机器学习算法,主成分分析(Principal Components Analysis, PCA). 假设有 $m$ 个点的集合:$\left\{ ...
- 【机器学习】主成分分析PCA(Principal components analysis)
1. 问题 真实的训练数据总是存在各种各样的问题: 1. 比如拿到一个汽车的样本,里面既有以“千米/每小时”度量的最大速度特征,也有“英里/小时”的最大速度特征,显然这两个特征有一个多余. 2. 拿到 ...
- 主成分分析(principal components analysis)
http://www.cnblogs.com/jerrylead/tag/Machine%20Learning/ PCA的思想是将n维特征映射到k维上(k<n),这k维是全新的正交特征.这k维特 ...
- 主成分分析(principal components analysis, PCA)
原理 计算方法 主要性质 有关统计量 主成分个数的选取 ------------------------------------------------------------------------ ...
- A tutorial on Principal Components Analysis | 主成分分析(PCA)教程
A tutorial on Principal Components Analysis 原著:Lindsay I Smith, A tutorial on Principal Components A ...
- [zz] Principal Components Analysis (PCA) 主成分分析
我理解PCA应该分为2个过程:1.求出降维矩阵:2.利用得到的降维矩阵,对数据/特征做降维. 这里分成了两篇博客,来做总结. http://matlabdatamining.blogspot.com/ ...
- Andrew Ng机器学习公开课笔记–Principal Components Analysis (PCA)
网易公开课,第14, 15课 notes,10 之前谈到的factor analysis,用EM算法找到潜在的因子变量,以达到降维的目的 这里介绍的是另外一种降维的方法,Principal Compo ...
- Stat2—主成分分析(Principal components analysis)
最近在猛撸<R in nutshell>这本课,统计部分涉及的第一个分析数据的方法便是PCA!因此,今天打算好好梳理一下,涉及主城分析法的理论以及R实现!come on…gogogo… 首 ...
- Jordan Lecture Note-9: Principal Components Analysis (PCA).
Principal Components Analysis (一)引入PCA 当我们对某个系统或指标进行研究时往往会发现,影响这些系统和指标的因素或变量的数量非常的多.多变量无疑会为科学研究带来 ...
- (4)主成分分析Principal Component Analysis——PCA
主成分分析Principal Component Analysis 降维除了便于计算,另一个作用就是便于可视化. 主成分分析-->降维--> 方差:描述样本整体分布的疏密,方差越大-> ...
随机推荐
- C#迭代器
迭代器概述 迭代器是可以返回相同类型的值的有序序列的一段代码. 迭代器可用作方法.运算符或 get 访问器的代码体. 迭代器代码使用 yield return 语句依次返回每个元素.yield bre ...
- Oracle在中文环境下出现乱码解决办法
zysong.ttf下载是一款oracle字体乱码解决工具,实质于缺乏中文字体包! 01情况的例子 02情况的例子 01.在开始安装的时候出现乱码 下载zysong.ttf,unzip 解压 一 ...
- python 英文字串首字母改为大写
#英文字串首字母改为大写 st = "string" St = st[0].upper() + st[1:] 2016-10-22 后来了解到 python 内部有相关实现,感觉 ...
- there is issue about change event of checkbox in the ie8 oe ie7
some people said the change event of checkbox can not trigger in the ie7 or ie8,that's not true. thi ...
- android listview 的监听事件
今天遇到了一个比较让我头疼的问题,不过追根揭底只是我对listview理解的不够透彻罢了, 闲言少叙,说说我遇到的问题吧: 上篇随笔我写了关于listview的使用,如果你也已经写好了列表那么恭喜这一 ...
- 1019在winddow上面安装MYSQL服务
-- 在WINDOWS上安装MYSQL,利用运行包直接安装-- 第一步复制文件拷贝到对应目录-- 第二步修改配置文件,创建DATA目录[client]port=3312 [mysql]default- ...
- AngularJS指令的详解
指令作为AngularJS中最为重要的部分,所以这个框架本身也是自带了比较多的的指令,但是在开发中,这些指令通常不能满足我们的需要,所以我们也是需要自定义一些指令的.指令是我们用来扩展浏览器能力的技术 ...
- Hibernate注解映射联合主键的三种主要方式
今天在做项目的时候,一个中间表没有主键,所有在创建实体的时候也未加组件,结果报以下错误: org.springframework.beans.factory.BeanCreationException ...
- Java--剑指offer(3)
11.输入一个整数,输出该数二进制表示中1的个数.其中负数用补码表示. a)使用Integer.toBinaryString(n);来计算得出二进制的字符串,然后使用for循环截取字符串是否为1 pu ...
- 数组的方法 Array.map();Array.every()和Array.some();数组的indexof();检测是否是数组isArray(obj);
数组的方法 Array.map(); 栗子: var a=[1,2,,3]; var b=a.map( function(value){return value*value} ); alert(b); ...