
一个python小爬虫
自定义获取豆瓣网电影TOP250里的排名数量
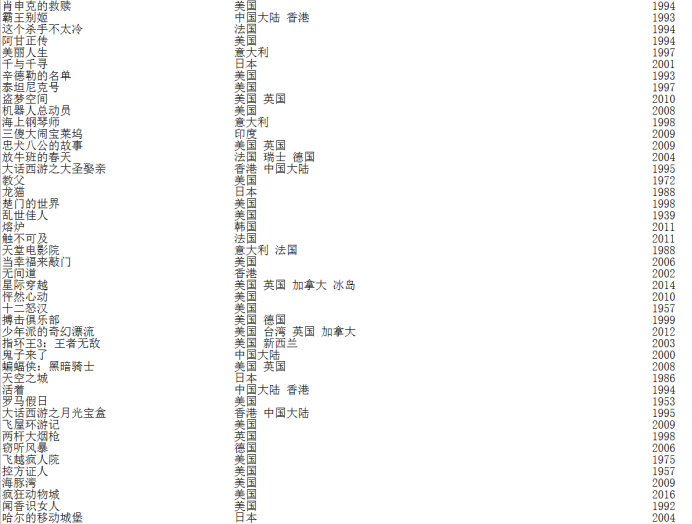
主要思路:先由requests库获取html基本信息,然后用BeautifulSoup来进行html.parser格式解析,逐个获取Tag属性,并且对内容进行字符串切片,字符串匹配,保存得到电影名称,地点,日期。
from bs4 import BeautifulSoup

import requests

import re

#由于中文编码的原因需要重新计算中文所占长度

def SuperLen(s):

    sum_len=len(s)

    chi_len=len(re.sub('[a-zA-Z]','',s))

    eng_len=sum_len-chi_len

    return (chi_len*2+eng_len)

#此函数功能是准确得到中英文混合字符串所占长度

#由于每页只有25个电影,所以用户需求电影数目不同页数(URL)也就不同

def Get_Page(n):

    if n%25!=0:

        num=int(n/25)+1

    else:

        num=int(n/25)

    return num

#此函数功能是获取页数

#根据所需参数页数来对应不同的URL

def Num_Get_Soup(n):

    url='https://movie.douban.com/top250?start='+str(n)+'&filter='

    resul=requests.get(url)

    soup=BeautifulSoup(resul.text,'html.parser')

    return soup

#此函数功能就是对URL进行requests.get 以获取对应的BeautifulSoup

#使用BeautifulSoup

def Get_Name_Date_Locat(nums):

    NAME=[]

    Date=[]

    Locat=[]

    for j in range(Get_Page(nums)):  #获取页数,进行循环操作

        soup=Num_Get_Soup(j*25)      #根据不同页数的不同URL获取soup

        Name_temp=soup.find_all('img','',limit=25)    #获取名称Tag,数目最大且为25

        Date_Locat_temp=soup.find_all('p','',limit=25)#获取日期 地点Tag

        for i in Name_temp:

            NAME.append(i.attrs['alt'])  #对获取的Tag获取属性

        for l in Date_Locat_temp:

            stemp=str(l)

            Date.append(re.sub('\D','',stemp.split('\xa0')[-5])[:4]) #对字符串切片后进行字符串匹配获取数字日期

            Locat.append(stemp.split('\xa0')[-3])  #字符串切片获取地点

    return (NAME,Date,Locat)

#此函数功能是格式化写入文件

def Write_text(n,N,D,L):

    f=open('result.txt','w')

    for i  in range(n):

        f.write(N[i]+'{}\t'.format((35-SuperLen(N[i]))*' '))

        f.write(L[i]+'{}\t'.format((70-len(L[i]*2))*' '))

        f.write(D[i])

        f.write('\n')

    f.close()

#函数的开始

def Start():

    nums=eval(input('请输入要爬取排名的个数0-250均可'))

    print('Please Waitng........')

    Name,Date,Locat=Get_Name_Date_Locat(nums)

    Write_text(nums,Name,Date,Locat)

    print('Complete!')

Start()
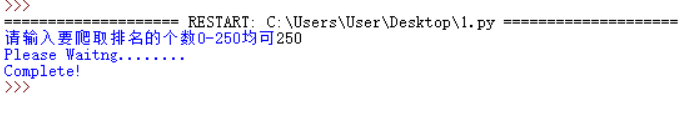
效果图:
可改进思路:正则表达和字符串切片的使用可以再合理一些,格式化保存文件也可以再简化。
一个python小爬虫的更多相关文章
- 第一个Python小爬虫
这个爬虫是参考http://python.jobbole.com/81353/这篇文章写的 这篇文章可能年代过于久远,所以有些代码会报错,然后我自己稍微修改了一下,增加了一个getContentAll ...
- 用Python 3写的一个Spider小爬虫(使用内置urllib模块and正则表达式)
用Python写了一个Spider小爬虫,爬一爬斗鱼“王者荣耀”在线直播的主播及人气
- Day1:第一个python小程序
Day1:第一个python小程序与开发工具Pycharm 一.Hello World C:\Users\wenxh>python Python 3.6.2 (v3.6.2:5fd33b5, J ...
- 第一个python小脚本
第一个python小实验 前言 作为一个工作1年的linux运维搬砖师来说,发现没点开发能力真的是不好混啊.于是下定决心学习python! 直接上刚写的语句(大神莫鄙视) 通过控制台输入一个账号密码, ...
- 【现学现卖】python小爬虫
1.给小表弟汇总一个院校列表,想来想去可以写一个小爬虫爬下来方便些,所以就看了看怎么用python写,到了基本能用的程度,没有什么特别的技巧,大多都是百度搜的,遇事不决问百度啦 2.基本流程就是: 用 ...
- python小爬虫练手
一个人无聊,写了个小爬虫爬取不可描述图片.... 代码太短,就暂时先往这里贴一下做备份吧. 注:这是很严肃的技术研究,当然爬下来的图片我会带着批判性的眼光审查一遍的.... :) #! /usr/ ...
- Python 小爬虫流程总结
接触Python3一个月了,在此分享一下知识点,也算是温故而知新了. 接触python之前是做前端的.一直希望接触面能深一点.因工作需求开始学python,几乎做的都是爬虫..第一个demo就是爬取X ...
- Python小爬虫-自动下载三亿文库文档
新手学python,写了一个抓取网页后自动下载文档的脚本,和大家分享. 首先我们打开三亿文库下载栏目的网址,比如专业资料(IT/计算机/互联网)http://3y.uu456.com/bl-197?o ...
- 发布一个Python小程序:ManHourCalendar
程序诞生的那些事儿 先聊聊背景资料档案.. 大约两年前,我只身前往岛国赚点外快.在那边的派遣制度工作中,存在一个大约叫每月的标准工作时间的概念,按照自家公司跟派遣目标公司(业界称为现场)的合同,规定了 ...
随机推荐
- 解决Charles https抓包显示<unknown>
用mac电脑开发安卓的都应该知道青花瓷吧~(不知道的都是小菜鸡,邪恶.jpg) Charles类似Windows版的Fiddler(没用过Fiddler的都是小菜鸡中的战斗机,嘲笑.png),基本用法 ...
- JS-3
运算符 数学运算符 + - * / %(取模运算符) js内置一个对象叫Math,Math提供了很多关于计算的方法,常见的 // 随机数 console.log(Math.random()); // ...
- Java 访问限制符 在同一包中或在不同包中:使用类创建对象的权限 & 对象访问成员变量与方法的权限 & 继承的权限 & 深入理解protected权限
一.实例成员与类成员 1. 当类的字节码被加载到内存, 类中类变量.类方法即被分配了相应内存空间.入口地址(所有对象共享). 2. 当该类创建对象后,类中实例变量被分配内存(不同对象的实例变量互不相同 ...
- python之路-bytes数据类型
一. python 3最重要的新特性大概要算是对文本和二进制数据作了更为清晰的区分.文本总是Unicode,由str类型表示,二进制数据则由bytes类型表示.python 3不会以任意隐式的方式混用 ...
- 关于react的分页
基于antdesign分页:表格属性pagination <Table pagination={{ total: this.state.totalNum, showSizeChanger: tr ...
- xpath简单实用
一.xpath 基本语法 /html /html/head/title 绝对路径(一层层的查找) /html//title 相对于当前节点 //title/./../.. . 当前节点 ..父节点 . ...
- 构建--> 部署-->
这一篇中我们会写一些关于自动化部署的代码.我们会使用 Powershell 书写这类代码. 你将发现这篇文章中涉及的东西非常具体,有的要求甚至相当苛刻且可能不具有通用性.这是因为部署从来都是跟环境打交 ...
- Oracle学习DayOne(SQL初步)
一.DML.DDL.DCL SQL语句分为以下三种类型: DML: Data Manipulation Language 数据操纵语言DDL: Data Definition Language 数据定 ...
- java集合(二)
- java基础继承
为什么用继承: 因为继承可以减少代码的冗余,提高维护性,为了从根本上解决存在的问题,就需要继承,就是将多个类当中的相同的地方提取到一个父类当中.父类更通用,子类更具体. 父类的继承格式 语法:publ ...