
使用sbt构建spark 程序
今日在学习scala和spark相关的知识。之前在eclipse下编写了wordcount程序。但是关于导出jar包这块还是很困惑。于是学习sbt构建scala。
关于sbt的介绍网上有很多的资料,这里就不解释了。参考:http://wiki.jikexueyuan.com/project/sbt-getting-started/install-sbt.html
关于linux下(centos)安装sbt: 依次执行
curl https://bintray.com/sbt/rpm/rpm > bintray-sbt-rpm.repo
sudo mv bintray-sbt-rpm.repo /etc/yum.repos.d/
sudo yum install sbt
使用sbt需要按照sbt的要求生成相关的目录:
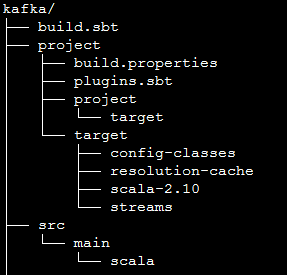
其中,kafka是项目根目录,build.sbt的内容如下:
name := "test"

version := "1.0"

scalaVersion := "2.10.5"


libraryDependencies += "org.apache.spark" % "spark-streaming_2.10" % "1.6.2" % "provided"

libraryDependencies += "org.apache.spark" %% "spark-core" % "1.6.2" % "provided"

libraryDependencies += "org.apache.spark" %% "spark-sql" % "1.6.2" % "provided"

libraryDependencies += "org.apache.spark" % "spark-streaming-kafka_2.10" % "1.6.2"  //注意版本
scalaVersion是指定编译程序的scala版本,因为这里用的是spark1.6.2,所以对应的scala版本为2.10.5
libraryDependencies 是指程序的库依赖,最后的provided 的意思是,spark内已经提供了这几个库,打包时,无需考虑这几个。
src是项目源代码所在位置:
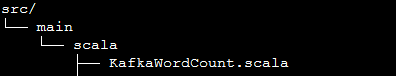
KafkaWordCount.scala内容如下:
import java.util.HashMap

import org.apache.spark.streaming._

import org.apache.spark.streaming.kafka._

import org.apache.spark.SparkConf

object KafkaWordCount {

  def main(args: Array[String]) {

    if (args.length < ) {

      System.err.println("Usage: KafkaWordCount <zkQuorum> <group> <topics> <numThreads>")

      System.exit()

    }

    val Array(zkQuorum, group, topics, numThreads) = args

    val sparkConf = new SparkConf().setAppName("KafkaWordCount")

    val ssc = new StreamingContext(sparkConf, Seconds())

    ssc.checkpoint("checkpoint")

    val topicMap = topics.split(",").map((_, numThreads.toInt)).toMap

    val lines = KafkaUtils.createStream(ssc, zkQuorum, group, topicMap).map(_._2)

    val words = lines.flatMap(_.split(" "))

    val wordCounts = words.map(x => (x, 1L))

      .reduceByKeyAndWindow(_ + _, _ - _, Minutes(), Seconds(), )

    wordCounts.print()

    ssc.start()

    ssc.awaitTermination()

  }

}
在项目的根目录,即kafka目录下面,运行: sbt compile 对项目进行编译。sbt package 导出jar包。
在spark目录运行:
./bin/spark-submit --master spark://192.168.1.241:7077 --class KafkaWordCount /root/kafka/target/scala-2.10/test_2.10-1.0.jar 127.0.0.1:2181 2 2 2
这样运行出错,提示没有kafkaUtil这个类,网上查了下,是使用package打包时,并没有将依赖的jar包打成一个,因此需要使用assembly插件
并且运行的时候,会有类似错误:
Exception in thread "main" org.apache.spark.SparkException:
 Checkpoint RDD CheckpointRDD[] at foreachRDD at WebPagePopularityValueCalculator.scala:68(0)
has different number of partitions than original RDD MapPartitionsRDD[] at updateStateByKey at WebPagePopularityValueCalculator.scala:62(2)
这是因为在集群模式运行时,需要将checkpoint文件夹设置为hdfs类似的路径。解决方法为:使用hdfs的路径: hdfs:ip:9000/data
关于assembly的介绍: http://blog.csdn.net/beautygao/article/details/32306637
参考:http://stackoverflow.com/questions/27198216/sbt-assembly-deduplicate-error-exclude-error
http://blog.csdn.net/ldds_520/article/details/51443606
http://www.cnblogs.com/scnu-ly/p/5106726.html
使用sbt构建spark 程序的更多相关文章
- sbt编译spark程序提示value toDF is not a member of Seq()
sbt编译spark程序提示value toDF is not a member of Seq() 前提 使用Scala编写的Spark程序,在sbt编译打包的时候提示value toDF is no ...
- 构建Spark作业
首先,要清楚,一个Java或Scala或python实现的Spark作业. 1.用sbt构建Spark作业 2.用Maven构建Spark作业 3.用non-maven-aware工具构建Spark作 ...
- sbt打包Scala写的Spark程序,打包正常,提交运行时提示找不到对应的类
sbt打包Scala写的Spark程序,打包正常,提交运行时提示找不到对应的类 详述 使用sbt对写的Spark程序打包,过程中没有问题 spark-submit提交jar包运行提示找不到对应的类 解 ...
- SBT安装及命令行打包spark程序
1.从https://www.scala-sbt.org/download.html官网上寻找所需要的安装包 可以直接本地下载完扔进去也可以wget路径,在这里我用的是sbt1.2.8版本的,下载到/ ...
- SBT 构建scala eclipse开发
scala eclipse sbt 应用程序开发 搭建Eclipse开发Scala应用程序的一般步骤 一.环境准备: 1.Scala : http://www.scala-lang.org/ 2.Sc ...
- 使用IDEA运行Spark程序
使用IDEA运行Spark程序 1.安装IDEA 从IDEA官网下载Community版本,解压到/usr/local/idea目录下. tar –xzf ideaIC-13.1.4b.tar.gz ...
- Spark:利用Eclipse构建Spark集成开发环境
前一篇文章“Apache Spark学习:将Spark部署到Hadoop 2.2.0上”介绍了如何使用Maven编译生成可直接运行在Hadoop 2.2.0上的Spark jar包,而本文则在此基础上 ...
- 构建Spark的Eclipse开发环境
前言 无论Windows 或Linux 操作系统,构建Spark 开发环境的思路一致,基于Eclipse 或Idea,通过Java.Scala 或Python 语言进行开发.安装之前需要提前准备好JD ...
- 使用SBT构建Scala应用(转自git)
# 使用SBT构建Scala应用 ## SBT简介 SBT是Simple Build Tool的简称,如果读者使用过Maven,那么可以简单将SBT看做是Scala世界的Maven,虽然二者各有优劣, ...
随机推荐
- Django 之 分表
app名称为'core',基本的models.py文件内容如下: class Province(models.Model): name = models.CharField(u'省份名称',max_l ...
- ORACLE10gRAC数据库迁移至10gRAC
1.数据库备份RUN {ALLOCATE CHANNEL ch00 DEVICE TYPE disk;ALLOCATE CHANNEL ch01 DEVICE TYPE disk;ALLOCATE C ...
- 修改.gitignore后让其生效
在使用git的时候我们有时候需要忽略一些文件或者文件夹.我们一般在仓库的根目录创建.gitignore文件在提交之前,修改.gitignore文件,添加需要忽略的文件.然后再做add commit p ...
- Google App Engine, Python2.7的UnicodeDecodeError bug
在跟Web Development,要在Google App Engine上写作业,出师不利,遇到以下bug: 2014-05-06 16:14:17 Running command: "[ ...
- Dynamics AX Hostory
现在谈起Dynamics AX,在微软Dynamics系列产品当中,作为最受瞩目和最有前景的Dynamics套装产品线,很多人也许只知道它曾经由于资本市场的上市和并购,前后经历了三个“东家”.对于它长 ...
- 删除Json中的不需要的键值
var json = {'A': 1, ,'B': 2, 'ccc': 333} delete json['ccc'];
- jquery easyui校验select下拉列表值是否为空的问题
属性名 类型 描述 默认值 required 布尔 定义文本域是否为必填项 false validType 字符串 定义字段的验证类型,比如email, url, etc. null missingM ...
- Objective C ARC 使用及原理
手把手教你ARC ,里面介绍了ARC的一些特性, 还有将非ARC工程转换成ARC工程的方法 ARC 苹果官方文档 下面用我自己的话介绍一下ARC,并将看文档过程中的疑问和答案写下来.下面有些是翻译,但 ...
- S2SH CRUD 整合
采用的框架 Struts2+Spring4+Hbiernate4. 目录结构 : EmployeeAction: package com.xx.ssh.actions; import java. ...
- cs11_c++_lab3
Matrix.hh class Matrix { int row; int col; int *p; void copy(const Matrix &m); void clearup(); p ...