
python爬取北京政府信件信息02
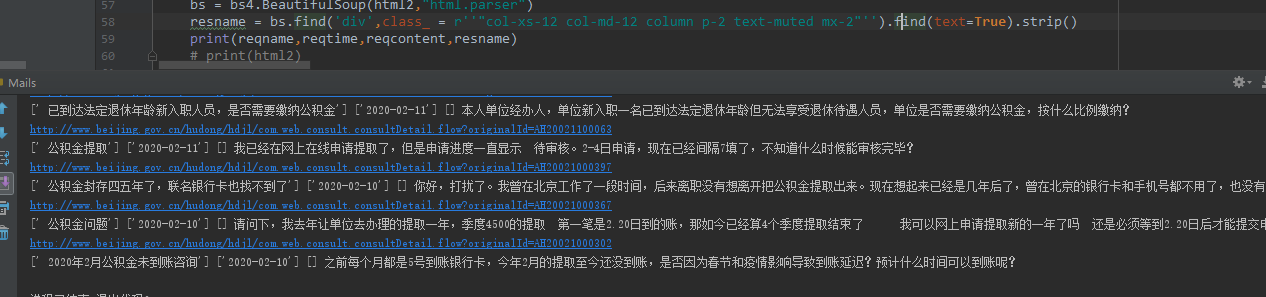
在爬取详细信息页面中,又遇到了问题,就是标签内的信息爬取,用re的正则表达式没有找到解决办法,只能又去网上搜索解决办法
用bs4来解决,用
soup = BeautifulSoup(text,"html.parser")#解析text中的HTML
来进行分析,虽说这样会有标签信息附着,从网上找到解决办法,
第一种方法
调用find(text=True).strip()
第二种方法
调用stripped_strings
第三种方法
.get_text().lstrip().rstrip()
个人感觉第三种很好用,在实践之后特意添加
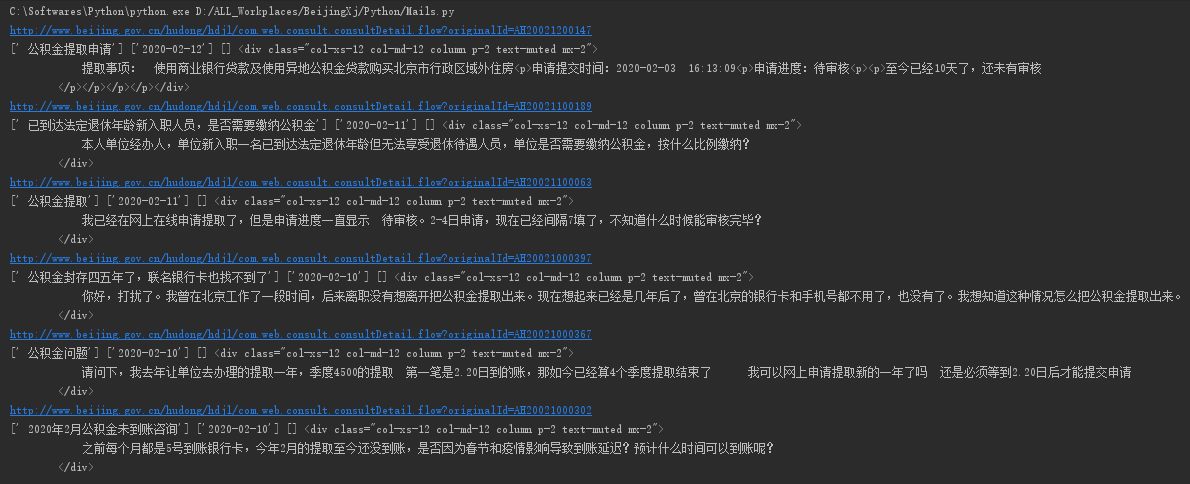
经过测试,不是很理想,对于简单的,只有div标签的很容易,对于第一种,好多p标签的就不好用了,正在寻找更加实用的代码
for add in ad:

    r = add

    address_ = "http://www.beijing.gov.cn/hudong/hdjl/com.web.consult.consultDetail.flow?originalId=%s" % add

    print(address_)

    # 爬取子页面的网页

    html2 = requests.get(address_,headers = head2).text

    reqname = re.findall(r'<div class="col-xs-10 col-sm-10 col-md-10 o-font4 my-2"><strong>(.*?)</strong></div>',html2)

    reqtime = re.findall(r'<div class="col-xs-5 col-lg-3 col-sm-3 col-md-3 text-muted ">时间:(.*?)</div>',html2)

    reqcontent = re.findall(r'<div class="col-xs-12 col-md-12 column p-2 text-muted mx-2">(.*?)</div>',html2)

    # resname = re.findall(r'<strong>[官方回答]:</strong>(.*?)</div>',html2)

    bs = bs4.BeautifulSoup(html2,"html.parser")

    resname = bs.find('div',class_ = r''"col-xs-12 col-md-12 column p-2 text-muted mx-2"'')

    print(reqname,reqtime,reqcontent,resname)

    # print(html2)
python爬取北京政府信件信息02的更多相关文章
- python爬取北京政府信件信息01
python爬取,找到目标地址,开始研究网页代码格式,于是就开始根据之前学的知识进行爬取,出师不利啊,一开始爬取就出现了个问题,这是之前是没有遇到过的,明明地址没问题,就是显示网页不存在,于是就在百度 ...
- 用Python爬取智联招聘信息做职业规划
上学期在实验室发表时写了一个爬取智联招牌信息的爬虫. 操作流程大致分为:信息爬取——数据结构化——存入数据库——所需技能等分词统计——数据可视化 1.数据爬取 job = "通信工程师&qu ...
- python爬取 “得到” App 电子书信息
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 静觅 崔庆才 PS:如有需要Python学习资料的小伙伴可以加点击下 ...
- Python爬取房天下二手房信息
一.相关知识 BeautifulSoup4使用 python将信息写入csv import csv with open("11.csv","w") as csv ...
- 这价格看得我偷偷摸了泪——用python爬取北京二手房数据
如果想了解更多关于python的应用,可以私信我,或者加群,里面到资料都是免费的 http://t.cn/A6Zvjdun 近期,有个朋友联系我,想统计一下北京二手房的相关的数据,而自己用Excel统 ...
- 【python】用python爬取中科院院士简介信息
018/07/09 23:43 项目名称:爬取中科院871个院士的简介信息 1.爬取目的:中科院871个院士的简介信息 2.爬取最终结果: 3.具体代码如下: import re # 不用安装(注意! ...
- Python 爬取赶集网租房信息
代码已久,有可能需要调整 #coding:utf-8 from bs4 import BeautifulSoup #有这个bs4不用正则也可以定位要爬取的内容了 from urlparse impor ...
- 利用python爬取贝壳网租房信息
最近准备换房子,在网站上寻找各种房源信息,看得眼花缭乱,于是想着能否将基本信息汇总起来便于查找,便用python将基本信息爬下来放到excel,这样一来就容易搜索了. 1. 利用lxml中的xpath ...
- python爬取实习僧招聘信息字体反爬
参考博客:http://www.cnblogs.com/eastonliu/p/9925652.html 实习僧招聘的网站采用了字体反爬,在页面上显示正常,查看源码关键信息乱码,如下图所示: 查看网页 ...
随机推荐
- Linux基础服务——Bind DNS服务 Part1
Linux基础服务--Bind DNS服务 Part1 DNS正向解析 实验环境: CentOS8.3.2011 IP地址:192.168.100.50 VMware虚拟环境 NAT网段 需要解析的区 ...
- 面阿里P7,竟问这么简单的题目?
关于作者:程序猿石头(ID: tangleithu),来自十八县贫困农村(查看我的逆袭之路),BAT某厂P7,是前大疆(无人机)技术主管,曾经也在创业公司待过,有着丰富的经验. 本文首发于微信公众号, ...
- 使用CUDA Warp-Level级原语
使用CUDA Warp-Level级原语 NVIDIA GPU以SIMT(单指令,多线程)的方式执行称为warps 的线程组.许多CUDA程序通过利用warp执行来实现高性能.本文将展示如何使用cud ...
- GPU与显卡
GPU与显卡 一.什么是GPU? GPU这个概念是由Nvidia公司于1999年提出的.GPU是显卡上的一块芯片,就像CPU是主板上的一块芯片.那么1999年之前显卡上就没有GPU吗?当然有,只不过那 ...
- TensorRT 3:更快的TensorFlow推理和Volta支持
TensorRT 3:更快的TensorFlow推理和Volta支持 TensorRT 3: Faster TensorFlow Inference and Volta Support 英伟达Tens ...
- 通过Mellanox ConnectX NIC使用XDP加速
通过Mellanox ConnectX NIC使用XDP加速 Accelerating with XDP over Mellanox ConnectX NICs XDP(eXpress Data Pa ...
- 利用NVIDIA NGC的TensorRT容器优化和加速人工智能推理
利用NVIDIA NGC的TensorRT容器优化和加速人工智能推理 Optimizing and Accelerating AI Inference with the TensorRT Contai ...
- 从C到C++过渡的3个原因
从C到C++过渡的3个原因 3 reasons to transition from C to C++ 几十年来,嵌入式软件工程师们一直在争论他们是否应该使用C或C++.根据2019年嵌入式市场调查, ...
- Python_Selenium之basepage 识别元素、浏览器操作、获取属性、鼠标事件、键盘事件、弹窗、切换frame、切换句柄等封装
#coding=gbkimport osimport timefrom selenium import webdriverfrom selenium.webdriver.common.by impor ...
- seldom 1.0 发布
seldom 是我几个月前重启的Web UI 自动化开源项目,源项目名 pyse, 基于 unittest 和 selenium 的自动化测试框架. seldom 1.0 做为第一个正式版做了以下改进 ...