
sumafan:python爬虫多线程爬取数据小练习(附答案)
抓取 https://www.cnbeta.com/ 首页中新闻内容页网址,

抓取内容例子: https://hot.cnbeta.com/articles/game/825125
将抓取下来的内容页地址组成list,利用多线程,把所有内容页的内容写入文件,文件名以新闻id命名 以上一篇为例子就是 825125.html。
☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆`·.·˙˙`·..·˙˙`·..·☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆`·.·˙˙`·☆.·˙˙`·..·☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆`·.·˙˙`·..·˙˙`·..·☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆`·.·˙˙`·☆.·˙˙`·..·☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆`·.·˙˙`·..·˙˙`·..·☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆`·.·˙˙`·☆.·˙˙`·..·☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆`·.·˙˙`·..·˙˙`·..·☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆`·.·˙˙`·☆.·˙˙`·..·☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆`·.·˙˙`·..·˙˙`·..·☆`·.·˙˙`·..·˙˙`·..·˙☆`·.·˙˙`·..·˙☆`·.·˙˙`·
很久没有用到线程,看到这题的时候脑袋炸了(稳住不慌!)慌得一笔啊哈哈哈啊哈哈
import requests,time,os

from lxml import etree

import re

import threading

#定义请求类

class News(object):

    # # # #定义抓取方法

    def get_content(self,url):

        r = requests.get(url)

        html = r.content.decode("utf-8")

        # with open('./news.html','w',encoding='utf-8') as f:

        #     f.write(html)

        return html

    #定义数据匹配方法

    def get_data(self,html):

        #转换格式

        res = etree.HTML(html)

        detailurl = res.xpath("//div[@class='item']/dl/a/@href")

        # print(detailurl)

        urllist = []

        for i in detailurl:

            a  = re.compile(r'^h[\w.:/]*')

            res = re.match(a,i)

            if res:

                urllist.append(i)

        # print(urllist)

        urllistname=[]

        for i in urllist:

            name = i[-10:-4:1]

            urllistname.append(name)

        # print(urllistname)

        return urllistname,urllist

    def write_data(self,a,b):

        print(a,b)

        res = self.get_content(b)

        with open("./text/"+a+'.html','w',encoding='utf-8') as e:

            e.write(res)

if __name__ == '__main__':

    news = News()

    html = news.get_content("https://www.cnbeta.com/")

    urllistname,urllist = news.get_data(html)

    # print(urllist)

    for i in range(len(urllist)):

        write = threading.Thread(target=news.write_data,args=(urllistname[i],urllist[i]))

        write.setDaemon(True)

        write.start()

    write.join()

    print('ok')
效果: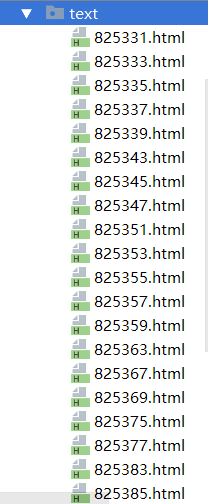 点进去就是一个下载后的详情页。
sumafan:python爬虫多线程爬取数据小练习(附答案)的更多相关文章
- Python爬虫:爬取美拍小姐姐视频
最近在写一个应用,需要收集微博上一些热门的视频,像这些小视频一般都来自秒拍,微拍,美拍和新浪视频,而且没有下载的选项,所以只能动脑想想办法了. 第一步 分析网页源码. 例如:http://video. ...
- [Python爬虫] Selenium爬取新浪微博客户端用户信息、热点话题及评论 (上)
转载自:http://blog.csdn.net/eastmount/article/details/51231852 一. 文章介绍 源码下载地址:http://download.csdn.net/ ...
- 如何手动写一个Python脚本自动爬取Bilibili小视频
如何手动写一个Python脚本自动爬取Bilibili小视频 国庆结束之余,某个不务正业的码农不好好干活,在B站瞎逛着,毕竟国庆嘛,还让不让人休息了诶-- 我身边的很多小伙伴们在朋友圈里面晒着出去游玩 ...
- python爬虫实战---爬取大众点评评论
python爬虫实战—爬取大众点评评论(加密字体) 1.首先打开一个店铺找到评论 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经 ...
- Python爬虫之爬取慕课网课程评分
BS是什么? BeautifulSoup是一个基于标签的文本解析工具.可以根据标签提取想要的内容,很适合处理html和xml这类语言文本.如果你希望了解更多关于BS的介绍和用法,请看Beautiful ...
- from appium import webdriver 使用python爬虫,批量爬取抖音app视频(requests+Fiddler+appium)
使用python爬虫,批量爬取抖音app视频(requests+Fiddler+appium) - 北平吴彦祖 - 博客园 https://www.cnblogs.com/stevenshushu/p ...
- Python爬虫之爬取淘女郎照片示例详解
这篇文章主要介绍了Python爬虫之爬取淘女郎照片示例详解,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友们下面随着小编来一起学习学习吧 本篇目标 抓取淘宝MM ...
- Python爬虫之爬取站内所有图片
title date tags layut Python爬虫之爬取站内所有图片 2018-10-07 Python post 目标是 http://www.5442.com/meinv/ 如需在非li ...
- python爬虫项目-爬取雪球网金融数据(关注、持续更新)
(一)python金融数据爬虫项目 爬取目标:雪球网(起始url:https://xueqiu.com/hq#exchange=CN&firstName=1&secondName=1_ ...
随机推荐
- Python基础01
Python基础 1.Python介绍 2.安装 3.Hello World程序 4.变量 5.用户输入 6.表达式if ...else语句 7.表达式for 循环 8.表达式while 循环 9.数 ...
- Hbase学习04
3.2.4 反向时间戳 反向扫描API HBASE-4811(https://issues.apache.org/jira/browse/HBASE-4811)实现了一个API来扫描一个表或范围内的一 ...
- js中html拼接
https://i.cnblogs.com/EditPosts.aspx?postid=10620765&update=1
- Linux命令(十四)gdb调试
1. gdb调试 fun.c #include <stdio.h> #include "head.h" int sum(int a, int b) { printf(& ...
- Python复习笔记(五)面向对象
1. __init__方法 # 1. 为对象在内存 中分配空间 -- 创建对象 # 2. 为对象属性 设置初始值 -- 初始化方法(init)+-------------- # 3. __init__ ...
- C#中ICollection介绍
ICollection 接口是 System.Collections 命名空间中类的基接口,ICollection 接口扩展 IEnumerable,IDictionary 和 IList 则是扩展 ...
- ubuntu常用
一.查看分区磁盘的速度命令 $ hdparm -Tt /dev/sda1 在终端打印出如下信息: /dev/sda1: Timing cached reads: MB in 2.00 seconds ...
- 10、 在QQ音乐中爬取某首歌曲的歌词
需求就是把关卡内的代码稍作修改,将周杰伦前五页歌曲的歌词都爬取下来,结果就是全部展示打印出来. URL https://y.qq.com/portal/search.html#p ...
- 函数的作用域、global与nonlocal
global 表示不再使用局部局部作用域中的内容,而是改用全局作用域中的变量 a = 100 def func(): global a # 表示不再局部创建这个变量,而是直接使用这个全局的a a = ...
- 细说REST API安全之防止数据篡改
通常可以使用MD5或SHA-1对API参数进行签名,在服务器端通过校验签名结果来验证数据是否被修改. 举个例子:添加用户 地址:http://192.168.0.10/v1/user/add?sign ...