
Google BERT摘要
1.BERT模型
BERT的全称是Bidirectional Encoder Representation from Transformers,即双向Transformer的Encoder,因为decoder是不能获要预测的信息的。模型的主要创新点都在pre-train方法上,即用了Masked LM和Next Sentence Prediction两种方法分别捕捉词语和句子级别的representation。
1.1 模型结构
由于模型的构成元素Transformer已经解析过,就不多说了,BERT模型的结构如下图最左:
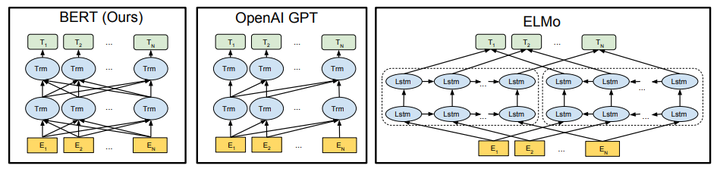
对比OpenAI GPT(Generative pre-trained transformer),BERT是双向的Transformer block连接;就像单向rnn和双向rnn的区别,直觉上来讲效果会好一些。
对比ELMo,虽然都是“双向”,但目标函数其实是不同的。ELMo是分别以 和
作为目标函数,独立训练处两个representation然后拼接,而BERT则是以
作为目标函数训练LM。
1.2 Embedding
这里的Embedding由三种Embedding求和而成:
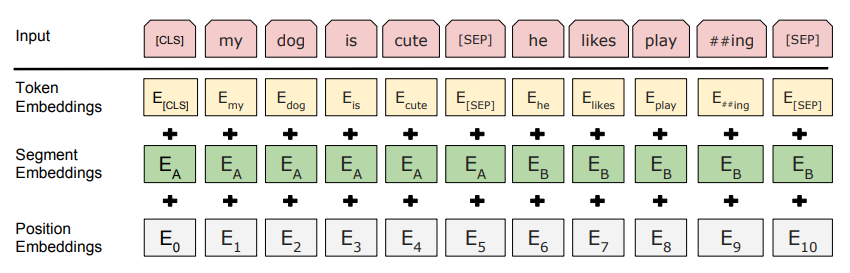
其中:
- Token Embeddings是词向量,第一个单词是CLS标志,可以用于之后的分类任务
- Segment Embeddings用来区别两种句子,因为预训练不光做LM还要做以两个句子为输入的分类任务
- Position Embeddings和之前文章中的Transformer不一样,不是三角函数而是学习出来的
总结:
1. BERT的特征提取,是在捕捉词的(前后)位置关系。bidirectional决定了能获得前后的关系,position embedding决定了能学到更长的顺序关系。
2.训练,分为pre-train和fine-tune。pre-train中用到了MLM, Masked LM.
3. trick: MLM. 在训练过程中作者随机mask 15%的token,而不是把像cbow一样把每个词都预测一遍。最终的损失函数只计算被mask掉那个token。
4. 缺点: (1)[MASK]标记在实际预测中不会出现,训练时用过多[MASK]影响模型表现
(2)每个batch只有15%的token被预测,所以BERT收敛得比left-to-right模型要慢(它们会预测每个token)
https://zhuanlan.zhihu.com/p/46652512
https://arxiv.org/pdf/1810.04805.pdf
Google BERT摘要的更多相关文章
- Google BERT应用之《红楼梦》对话人物提取
Google BERT应用之<红楼梦>对话人物提取 https://www.jiqizhixin.com/articles/2019-01-24-19
- Google BERT
概述 BERT的全称是Bidirectional Encoder Representation from Transformers,即双向Transformer的Encoder,因为decoder是不 ...
- HTML5扩展之微数据与丰富网页摘要
一.微数据是? 一个页面的内容,例如人物.事件或评论不仅要给用户看,还要让机器可识别.而目前机器智能程度有限,要让其知会特定内容含义,我们需要使用规定的标签.属性名以及特定用法等.举个简单例子,我们使 ...
- HTML5扩展之微数据与丰富网页摘要itemscope, itemtype, itemprop
HTML5扩展之微数据与丰富网页摘要 by zhangxinxu from http://www.zhangxinxu.com本文地址:http://www.zhangxinxu.com/wordpr ...
- HTML5扩展之微数据与丰富网页摘要——张鑫旭
一.微数据是? 一个页面的内容,例如人物.事件或评论不仅要给用户看,还要让机器可识别.而目前机器智能程度有限,要让其知会特定内容含义,我们需要使用规定的标签.属性名以及特定用法等.举个简单例子,我们使 ...
- Google论文BigTable拜读
这周少打点dota2,争取把这篇论文读懂并呈现出来,和大家一起分享. 先把论文搞懂,然后再看下和论文搭界的知识,比如hbase,Chubby和Paxos算法. Bigtable: A Distribu ...
- BERT预训练模型的演进过程!(附代码)
1. 什么是BERT BERT的全称是Bidirectional Encoder Representation from Transformers,是Google2018年提出的预训练模型,即双向Tr ...
- BERT模型
BERT模型是什么 BERT的全称是Bidirectional Encoder Representation from Transformers,即双向Transformer的Encoder,因为de ...
- 我爱自然语言处理bert ner chinese
BERT相关论文.文章和代码资源汇总 4条回复 BERT最近太火,蹭个热点,整理一下相关的资源,包括Paper, 代码和文章解读. 1.Google官方: 1) BERT: Pre-training ...
随机推荐
- 爬虫-requests用法
中文文档 API: http://requests.kennethreitz.org/zh_CN/latest/ 安装 pip install requests 获取网页 # coding=utf-8 ...
- Game Based Learning: Why Does it Work?
Forty years of research[i] says yes, games are effective learning tools. People learn from games, an ...
- React.js Tutorial: React Component Lifecycle
Introduction about React component lifecycle. 1 Lifecycle A React component in browser can be any of ...
- tomcat catalina
脚本catalina用于启动和关闭tomcat服务器,是最关键的脚本 在tomcat里有此文件 写这个脚本的人为什么命名为catalina一开始我还以为是其初恋女友,后来才知道原来是一个小岛的名字.
- 函数式编程—函数的关系—is-a、has-a、use-a
is-a:函数的实现与函数类型的关系: has-a:匿名(闭包)函数的创建者与匿名函数的关系:匿名函数与环境和上下文(函数)的关系: use-a:高阶函数与参量函数的关系: 函数式编程的基本功之一就是 ...
- [React] Fix "React Error: Rendered fewer hooks than expected"
In this lesson we'll see an interesting situation where we're actually calling a function component ...
- Java中lambda表达式学习
一.Lambda表达式的基础语法: Java8中引入了一个新的操作符"->"该操作符称为箭头操作符或Lambda操作符,箭头操作符将Lambda表达式拆分为两部分: 左侧:L ...
- [RN] React Native FlatList跳转到顶部/底部
React Native FlatList跳转到顶部/底部 核心代码如下: <ScrollView showsVerticalScrollIndicator={false} contentCon ...
- Vue的Key属性,v-for和v-if,v-if/v-show,v-pre不渲染,v-once只渲染一次
key属性为什么要加 key -- api 解释 key的特殊属性主要用在vue的虚拟dom算法,如果不适用key,vue会使用一种最大限度减少动态元素并且尽可能的尝试修复/再利用相同类型元素的算法. ...
- windows内核代码之进程操作
[toc] 一丶简介 整理一下windows内核中.常用的代码.这里只整理下进程的相关代码. 二丶 windows内核之遍历进程 内核中记录进程的结构体是EPROCESS结构.所以只需要遍历这个结构即 ...