
Scrapy 爬虫框架学习笔记(未完,持续更新)
Scrapy 爬虫框架
Scrapy 是一个用 Python 写的 Crawler Framework 。它使用 Twisted 这个异步网络库来处理网络通信。
Scrapy 框架的主要架构
根据它官网上的设计架构图,一个完整的 Spider 主要分成 7 个部分:Scrapy Engine,Scheduler,Downloader,Spider,Item Pipeline,Downloader middlewares,Spider middlewares。
Scrapy 引擎( Engine ):负责控制数据流在系统种所有组件中流动,并在相应动作时触发事件。
调度器( Scheduler ) :调度器从引擎中接收 Request 并将它们入队,以便之后引擎请求 Request 时提供给引擎。
下载器( Downloader ):下载器负责获取页面数据并提供给引擎。
Spider :是 Scrapy 用户用于分析 Response 并提取 Item 或者额外跟进 URL 的类。每个 Spider 负责处理特定(或一些)网站。
Item Pipeline :负责处理被 Spider 提取出来的 Item 。例如数据持久化。
Downloader middlewares 下载中间件:是引擎与下载器之间特定的钩子,处理 Downloader 传递给引擎的 Response 。
Spider 中间件( Spider middlewares ):是引擎和 Spider 之间的特定钩子,处理 Spider 的输入( Response )和输出( Items 和 Response )。
这些模块的之间的数据流向可以清楚地反应 Scrapy 的工作流程,具体如下:
- 引擎打开一个网站,找到处理该网站的 Spider 并向该 Spider 请求第一个要爬取的 URL 。
- 引擎从 Spider 中获取第一个要爬取的 URL 并通过调度器以 Request 进行调度。
- 引擎向调度器请求下一个要爬取的 URL 。
- 调度器返回下一个要爬取的 URL 给引擎,引擎将 URL 通过下载中间件转发给下载器。
- 一旦页面下载完成,下载器生成一个该页面的 Response ,并将器通过下载中间件发送给引擎。
- 引擎从下载器中接收到 Response 并通过 Spider 中间件发送给 Spider 处理。
- Spider 处理 Response 并返回爬取到的 Item 及新的 Request 给引擎。
- 引擎将爬取到的 Item 给 Item Pipeline ,将 Request 给调度器。
- 重复直到调度器中没有更多的 Request ,引擎关闭该网站。
这和之前学习的普通的爬虫思路架构是很像的。
安装 Scrapy 框架
我用的 WSL2 ,直接安装即可。
pip install scrapy
Scrapy, Hello World!
创建一个新的文件夹做项目的根路径。然后运行命令创建项目:
scrapy startproject cnblogsSpider
然后他就会生成如下的项目目录。
.

└── cnblogSpider

    ├── cnblogSpider => 该项目的 python 模块

    │   ├── __init__.py

    │   ├── items.py => Item 文件

    │   ├── middlewares.py => 中间件

    │   ├── pipelines.py => Pipeline 文件

    │   ├── settings.py => 配置文件

    │   └── spiders => 放置 Spider 文件的文件夹

    │       └── __init__.py

    └── scrapy.cfg => 项目部署文件
在 Spiders 文件夹下创建一个文件 cnblogs_spider.py 然后编写如下代码:
import scrapy

class CnblogsSpider(scrapy.Spider):

    # * 爬虫的名字,必须唯一

    name = "cnblogs"

    allowed_domains = ["cnblogs.com"]

    # * 爬取入口 URL 列表,将会首先爬取这里面的 URL

    start_urls = [

        "http://www.cnblogs.com/qiyeboy/default.html?page=1"

    ]

    # * 用来解析返回的 Response 数据的方法

    # * 每个 URL 相应后的 Response 都会传递给这个方法

    # * 进行提取 item 以及 URL Request 对象

    def parse(self, response):

        pass
在 cnBlogsSpider 文件夹下执行:
scrapy crawl cnblogs
第一个爬虫就成功完成了。
Scrapy 命令行工具
scrapy shell 分为两种类型的命令,一种是必须在 Scrapy 项目下运行的,一种是全局命令。
startproject 命令:
语法:
scrapy startproject myproject功能就是创建项目。
settings 命令:
语法:
scrapy settings [options]在项目运行时,运行这个命令将会输出项目的设定值,否则就输出 Scrapy 的默认设定。
scrapy settings --get BOT_NAME

# cnblogSpider

scrapy settings --get DOWNLOAD_DELAY

# 0
runspider 命令:
语法:
scrapy runspider <spider_file.py>在没有创建项目的情况下,运行一个编写好的 Spider 模块。
shell 命令:
语法:
scrapy shell [url]用于启动 Scrapy shell , URL 可选。
scrapy shell "http://www.cnblogs.com/qiyeboy/default.html?page=1"
fetch 命令:
语法:
scrapy fetch <url>使用 Scrapy 下载器下载给定的 URL ,并将内容送到终端。
如果是在项目内运行,会用项目内下载器的配置,如果不是就会用默认的 Scrapy Downloader 配置。
scrapy fetch --nolog "http://www.cnblogs.com/qiyeboy/default.html?page=1"

scrapy fetch --nolog --headers "http://www.cnblogs.com/qiyeboy/default.html?page=1"
view 命令:
语法:
scrapy view <url>。在浏览器中打开给定的 URL ,并以 Scrapy spider 获取到的形式展现。
scrapy view "http://www.cnblogs.com/qiyeboy/default.html?page=1"
bench 命令:
语法:
scrapy bench测试 Scrapy 在硬件上的效率。
Spider 模块
Spider 模块最重要的一个功能就是从 Downloader 中处理好的 Response 数据提取出想要的 Item 或者是新的 URL 。 Scrapy 框架提供了 Selector 来帮助我们提取数据。
在不使用框架的时候,我们使用的是 BeautifulSoup 或者是 XPath 完成网页数据的提取。而在 Scrapy 的框架下,内置了这些数据提取的工具,让我们可以直接使用内置的选择器来完成数据的提取。
Selector 的用法
四个基本用法
xpath(query):传入 XPath 表达式,返回表达式对应的所有节点的 selector list 列表。
css(query):传入 CSS 表达式,返回表达式对应的所有节点的 selector list 列表。
extract():序列化节点为 Unicode 字符串。
re(regex):根据传入的正则表达式对数据进行提取
这个是 Scrapy 里面的 Selector 最常用的 4 个方法。在 Spider 文件里的 parse(self, response) 方法里,只要将传入的 Response 传入 Selector 里,就能构建一个 Selector 。
selector = Selector(response)
由于 XPath 和 CSS 查询非常普遍, Scrapy 在 Request 里内置了两个可以直接调用的方法: xpath(query) -> SelectorList ,和 css(query) -> SeletorList 。它们返回的都是选择器列表。于是我们可以使用这种简写方式跳过构造 Selector 。
我们尝试从 HTML 页面上提取信息,改写一下 parse(response) 方法:
def parse(self, response):

    papers = response.xpath(".//*[@class='day']")

    for paper in papers:

        url = paper.xpath(".//*[@class='postTitle']/a/@href").extract()[0]

        title = paper.xpath(".//*[@class='postTitle']/a/span/text()").extract()[0]

        time = paper.xpath(".//*[@class='dayTitle']/a/text()").extract()[0]

        content = paper.xpath(".//*[@class='postCon']/div/text()").extract()[0]

        print(url, title, time, content)
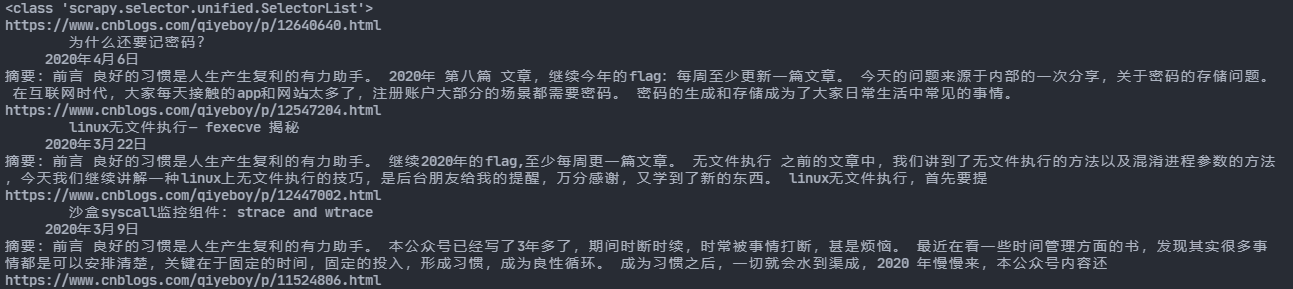
运行 scrapy crawl cnblogs 然后就可以发现成功获取了数据:
Scrapy 爬虫框架学习笔记(未完,持续更新)的更多相关文章
- scrapy爬虫框架学习笔记(一)
scrapy爬虫框架学习笔记(一) 1.安装scrapy pip install scrapy 2.新建工程: (1)打开命令行模式 (2)进入要新建工程的目录 (3)运行命令: scrapy sta ...
- Go web编程学习笔记——未完待续
1. 1).GOPATH设置 先设置自己的GOPATH,可以在本机中运行$PATH进行查看: userdeMacBook-Pro:~ user$ $GOPATH -bash: /Users/user/ ...
- linux学习笔记---未完待续,缓慢更新
做为linux菜鸟,由于work的需要,慢慢的开始接触学习linux. <鸟哥的linux私房菜>学习笔记. 一.基础命令操作 1.显示日期的命令 date 执行date命令后,显示结果为 ...
- jQuery 学习笔记(未完待续)
一.jQuery概述 宗旨: Write Less, Do More. 基础知识: 1.符号$代替document.getElementById()函数 2.使 ...
- Scrapy爬虫框架学习
一.Scrapy框架简介 1. 下载页面 2. 解析 3. 并发 4. 深度 二.安装 linux下安装 pip3 install scrapy windows下安装 a.pip3 install w ...
- oracle-绑定变量学习笔记(未完待续)
--定义变量SQL> var a number; --给绑定变量赋值SQL> exec :a :=123; PL/SQL procedure successfully completed. ...
- Java学习笔记(未完待续)
变量的作用域(scope)是指变量可以在程序中引用的范围.在方法中定义的变量称为局部变量(local variable).局部变量的作用域从声明变量的地方开始,直到包含该变量的块结束为止.局部变量都必 ...
- Greys学习笔记(未完待续)
Greys介绍 greys-anatomy是一个Java线上诊断工具,取名来自美剧<实习医生格雷>,由菜鸟-杜琨同学开发维护.比我们常用的脚本工具btrace提供更多的功能,greys采用 ...
- (阿里巴巴)数据库连接池——Druid (未完持续更新)
Java程序很大一部分要操作数据库,为了提高性能操作数据库的时候,有不得不使用数据库连接池.数据库连接池有很多选择,c3p.dhcp.proxool等,druid作为一名后起之秀,凭借其出色的性能,也 ...
随机推荐
- postman之将获取响应数据-创建环境变量,用于不同的接口调用
应用场景: token的获取,用于不同接口的取值 在test中进行如下设置: var jd = pm.response.json(); var access_token = jd.access_tok ...
- 编译原理-翻译程序(Translator)
分为编译程序(compiler)和解释程序(interpreter) 编译程序:把源程序(高级语言编写)转换成目标程序(汇编语言或机器语言编写). 解释程序:对源程序边翻译边执行. 编译型语言 优点: ...
- python operator操作符函数
本模块主要包括一些Python内部操作符对应的函数.这些函数主要分为几类:对象比较.逻辑比较.算术运算和序列操作.
- 【HTML】同页面锚点跳转
跳转: <a href="#maodian001">去吧!</a> 锚点: <a id="maodian001"></ ...
- 【C++】Vector排序
1.普通类型(由大到小排序) int main() { sort(v.begin(),v.end()); } 2.普通类型(由小到大排序) bool comp(const int &a,con ...
- 【题解】入阵曲 luogu3941 前缀和 压维
丹青千秋酿,一醉解愁肠. 无悔少年枉,只愿壮志狂 题目 题目描述 小 F 很喜欢数学,但是到了高中以后数学总是考不好. 有一天,他在数学课上发起了呆:他想起了过去的一年.一年前,当他初识算法竞赛的 时 ...
- Linux常用命令详解下
Linux常用命令详解 目录 一.Linux常用命令 1.1.查看及切换目录(pwd.cd.ls.du) 1.2.创建目录和文件(mkdir.touch.ln) 1.3.复制.删除.移动目录和文件(c ...
- 为什么catch了异常,但事务还是回滚了?
前几天我发了这篇文章<我来出个题:这个事务会不会回滚?>得到了很多不错的反馈,也有不少读者通过微信.群或者邮件的方式,给了我一些关于test4的回复.其中还有直接发给我测试案例,来证明我的 ...
- 为了提高开发效率,我实现了 uTools 的超级面板
前言 为了进一步提高开发工作效率,最近我们基于 electron 开发了一款媲美 uTools 的开源工具箱 rubick.该工具箱不仅仅开源,最重要的是可以使用 uTools 生态内所有开源插件!这 ...
- 仅使用JsonUtility和File类实现Json数据读写
using System.Collections; using System.Collections.Generic; using UnityEngine; using System; using S ...