
Spark Shuffle 堆外内存溢出问题与解决(Shuffle通信原理)
Spark Shuffle 堆外内存溢出问题与解决(Shuffle通信原理)
http://xiguada.org/spark-shuffle-direct-buffer-oom/
问题描述
Spark-1.6.0已经在一月份release,为了验证一下它的性能,我使用了一些大的SQL验证其性能,其中部分SQL出现了Shuffle失败问题,详细的堆栈信息如下所示:
16/02/17 15:36:36 WARN server.TransportChannelHandler: Exception in connection from /10.196.134.220:7337
java.lang.OutOfMemoryError: Direct buffer memory
at java.nio.Bits.reserveMemory(Bits.java:658)
at java.nio.DirectByteBuffer.<init>(DirectByteBuffer.java:123)
at java.nio.ByteBuffer.allocateDirect(ByteBuffer.java:306)
at io.netty.buffer.PoolArena$DirectArena.newChunk(PoolArena.java:645)
at io.netty.buffer.PoolArena.allocateNormal(PoolArena.java:228)
at io.netty.buffer.PoolArena.allocate(PoolArena.java:212)
at io.netty.buffer.PoolArena.allocate(PoolArena.java:132)
at io.netty.buffer.PooledByteBufAllocator.newDirectBuffer(PooledByteBufAllocator.java:271)
at io.netty.buffer.AbstractByteBufAllocator.directBuffer(AbstractByteBufAllocator.java:155)
at io.netty.buffer.AbstractByteBufAllocator.directBuffer(AbstractByteBufAllocator.java:146)
at io.netty.buffer.AbstractByteBufAllocator.ioBuffer(AbstractByteBufAllocator.java:107)
at io.netty.channel.AdaptiveRecvByteBufAllocator$HandleImpl.allocate(AdaptiveRecvByteBufAllocator.java:104)
at io.netty.channel.nio.AbstractNioByteChannel$NioByteUnsafe.read(AbstractNioByteChannel.java:117)
at io.netty.channel.nio.NioEventLoop.processSelectedKey(NioEventLoop.java:511)
at io.netty.channel.nio.NioEventLoop.processSelectedKeysOptimized(NioEventLoop.java:468)
at io.netty.channel.nio.NioEventLoop.processSelectedKeys(NioEventLoop.java:382)
at io.netty.channel.nio.NioEventLoop.run(NioEventLoop.java:354)
at io.netty.util.concurrent.SingleThreadEventExecutor$2.run(SingleThreadEventExecutor.java:111)
at java.lang.Thread.run(Thread.java:744)
从失败信息可以看出,是堆外内存溢出问题,为什么会出现堆外内存溢出呢?
Spark的shuffle部分使用了netty框架进行网络传输,但netty会申请堆外内存缓存(PooledByteBufAllocator ,AbstractByteBufAllocator);Shuffle时,每个Reduce都需要获取每个map对应的输出,当一个reduce需要获取的一个map数据比较大(比如1G),这时候就会申请一个1G的堆外内存,而堆外内存是有限制的,这时候就出现了堆外内存溢出。
Shuffle不使用堆外内存
为Executor增加配置-Dio.netty.noUnsafe=true,就可以让shuffle不使用堆外内存,但相同的作业还是出现了OOM,这种方式没办法解决问题。
java.lang.OutOfMemoryError: Java heap space
at io.netty.buffer.PoolArena$HeapArena.newUnpooledChunk(PoolArena.java:607)
at io.netty.buffer.PoolArena.allocateHuge(PoolArena.java:237)
at io.netty.buffer.PoolArena.allocate(PoolArena.java:215)
at io.netty.buffer.PoolArena.allocate(PoolArena.java:132)
at io.netty.buffer.PooledByteBufAllocator.newHeapBuffer(PooledByteBufAllocator.java:256)
at io.netty.buffer.AbstractByteBufAllocator.heapBuffer(AbstractByteBufAllocator.java:136)
at io.netty.buffer.AbstractByteBufAllocator.heapBuffer(AbstractByteBufAllocator.java:127)
at io.netty.buffer.CompositeByteBuf.allocBuffer(CompositeByteBuf.java:1347)
at io.netty.buffer.CompositeByteBuf.consolidateIfNeeded(CompositeByteBuf.java:276)
at io.netty.buffer.CompositeByteBuf.addComponent(CompositeByteBuf.java:116)
at org.apache.spark.network.util.TransportFrameDecoder.decodeNext(TransportFrameDecoder.java:148)
at org.apache.spark.network.util.TransportFrameDecoder.channelRead(TransportFrameDecoder.java:82)
at io.netty.channel.AbstractChannelHandlerContext.invokeChannelRead(AbstractChannelHandlerContext.java:308)
at io.netty.channel.AbstractChannelHandlerContext.fireChannelRead(AbstractChannelHandlerContext.java:294)
at io.netty.channel.DefaultChannelPipeline.fireChannelRead(DefaultChannelPipeline.java:846)
at io.netty.channel.nio.AbstractNioByteChannel$NioByteUnsafe.read(AbstractNioByteChannel.java:131)
at io.netty.channel.nio.NioEventLoop.processSelectedKey(NioEventLoop.java:511)
at io.netty.channel.nio.NioEventLoop.processSelectedKeysOptimized(NioEventLoop.java:468)
at io.netty.channel.nio.NioEventLoop.processSelectedKeys(NioEventLoop.java:382)
当数据量大时能否直接写磁盘
MapReduce中Shuffle数据量大时,会把Shuffle数据写到磁盘。
Spark Shuffle通信机制
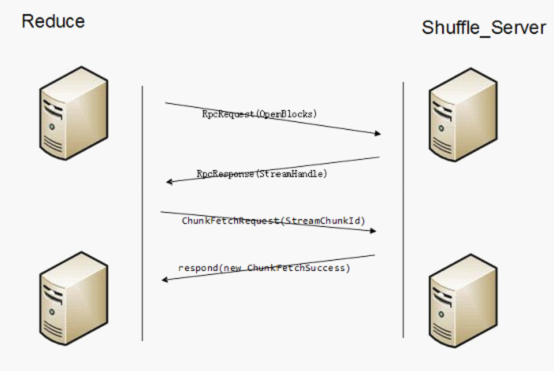
上图显示了Shuffle的通信原理。
服务端会启动Shuffle_Service。
(1)客户端代码调用堆栈
BlockStoreShuffleReader.read
ShuffleBlockFetcherIterator.sendRequest
ExternalShuffleClient.fetchBlocks
OneForOneBlockFetcher.start
TransportClient.sendRpc
发送RpcRequest(OpenBlocks)信息
(2)服务端代码调用堆栈
TransportRequestHandler.processRpcRequest
ExternalShuffleBlockHandler.receive
ExternalShuffleBlockHandler.handleMessage
ExternalShuffleBlockResolver.getBlockData(shuffle_ShuffleId_MapId_ReduceId)
ExternalShuffleBlockResolver.getSortBasedShuffleBlockData
FileSegmentManagedBuffer
handleMessage会把所需的appid的一个executor需要被fetch的block全部封装成List<ManagedBuffer>,然后注册为一个Stream,然后把streamId和blockid的个数返回给客户端,最后返回给客户端的信息为RpcResponse(StreamHandle(streamId, msg.blockIds.length))。
(3)客户端
客户端接收到RpcResponse后,会为每个blockid调用:
TransportClient.fetchChunk
Send ChunkFetchRequest(StreamChunkId(streamId, chunkIndex))
(4)服务端
TransportRequestHandler.processFetchRequest
OneForOneStreamManager.getChunk
返回respond(new ChunkFetchSuccess(req.streamChunkId, buf))给客户端,buf就是某一个blockid的FileSegmentManagedBuffer。
(5)客户端
OneForOneBlockFetcher.ChunkCallback.onSuccess
listener.onBlockFetchSuccess(blockIds[chunkIndex], buffer)
ShuffleBlockFetcherIterator.sendRequest.BlockFetchingListener.onBlockFetchSuccess
results.put(new SuccessFetchResult(BlockId(blockId), address, sizeMap(blockId), buf))
客户端的另外一个线程
ShuffleBlockFetcherIterator.next
(result.blockId, new BufferReleasingInputStream(buf.createInputStream(), this))
Download文件的通信原理
另外还有一个stream通信协议,客户端首先需要构造StreamRequest请求,StreamRequest中包含待下载文件的URL。
(1)客户端调用堆栈
Executor.updateDependencies...
org.apache.spark.util.Utils.fetchFile
org.apache.spark.util.Utils.doFetchFile
NettyRpcEnv.openChannel
TransportClient.stream
Send StreamRequest(streamId) streamId为文件的目录。
(2)服务端处理流程
TransportRequestHandler.handle
TransportRequestHandler.processStreamRequest
OneForOneStreamManager.openStream
返回new StreamResponse(req.streamId, buf.size(), buf)
(3)客户端处理流程
TransportResponseHandler.handle
TransportFrameDecoder.channelRead
TransportFrameDecoder.feedInterceptor
StreamInterceptor.handle
callback.onData即NettyRpcEnv.FileDownloadCallback.onData
然后返回client.stream(parsedUri.getPath(), callback)给Utils.doFetchFile,最后org.apache.spark.util.Utils.downloadFile
问题分析:
当前spark shuffle时使用Fetch协议,由于使用堆外内存存储Fetch的数据,当Fetch某个map的数据特别大时,容易出现堆外内存的OOM。而申请内存部分在Netty自带的代码中,我们无法修改。
另外一方面,Stream是下载文件的协议,需要提供文件的URL,而Shuffle只会获取文件中的一段数据,并且也不知道URL,因此不能直接使用Stream接口。
解决方案:
新增一个FetchStream通信协议,在OneForOneBlockFetcher中,如果一个block小于100M(spark.shuffle.max.block.size.inmemory)时,使用原有的方式Fetch数据,如果大于100M时,则使用新增的FetchStream协议,服务端在处理FetchStreamRequest和FetchRequest的区别在于,FetchStreamRequest返回数据流,客户端根据返回的数据量写到本地临时文件,然后构造FileSegmentManagedBuffer给后续处理流程。
Spark Shuffle 堆外内存溢出问题与解决(Shuffle通信原理)的更多相关文章
- Java堆外内存之六:堆外内存溢出问题排查
一.堆外内存组成 通常JVM的参数我们会配置 -Xms 堆初始内存 -Xmx 堆最大内存 -XX:+UseG1GC/CMS 垃圾回收器 -XX:+DisableExplicitGC 禁止显示GC -X ...
- Java堆外内存管理
Java堆外内存管理 1.JVM可以使用的内存分外2种:堆内存和堆外内存: 堆内存完全由JVM负责分配和释放,如果程序没有缺陷代码导致内存泄露,那么就不会遇到java.lang.OutOfMemo ...
- Java堆外内存之三:堆外内存回收方法
一.JVM内存的分配及垃圾回收 对于JVM的内存规则,应该是老生常谈的东西了,这里我就简单的说下: 新生代:一般来说新创建的对象都分配在这里. 年老代:经过几次垃圾回收,新生代的对象就会放在年老代里面 ...
- JVM源码分析之堆外内存完全解读
JVM源码分析之堆外内存完全解读 寒泉子 2016-01-15 17:26:16 浏览6837 评论0 阿里技术协会 摘要: 概述 广义的堆外内存 说到堆外内存,那大家肯定想到堆内内存,这也是我们 ...
- 【Spark篇】---Spark调优之代码调优,数据本地化调优,内存调优,SparkShuffle调优,Executor的堆外内存调优
一.前述 Spark中调优大致分为以下几种 ,代码调优,数据本地化,内存调优,SparkShuffle调优,调节Executor的堆外内存. 二.具体 1.代码调优 1.避免创建重复的RDD,尽 ...
- 从内存泄露、内存溢出和堆外内存,JVM优化参数配置参数
内存泄漏 内存泄漏是指程序在申请内存后,无法释放已申请的内存空间,无用对象(不再使用的对象)持续占有内存或无用对象的内存得不到及时释放,从而造成内存空间的浪费.内存泄漏最终会导致OOM. 造成内存泄漏 ...
- [转]perftools查看堆外内存并解决hbase内存溢出
最近线上运行的hbase发现分配了16g内存,但是实际使用了22g,堆外内存达到6g.感觉非常诡异.堆外内存用一般的工具很难查看,可以通过google-perftools来跟踪: http://cod ...
- perftools查看堆外内存并解决hbase内存溢出
最近线上运行的hbase发现分配了16g内存,但是实际使用了22g,堆外内存达到6g.感觉非常诡异.堆外内存用一般的工具很难查看,可以通过google-perftools来跟踪: http://cod ...
- spark-调节executor堆外内存
什么时候需要调节Executor的堆外内存大小? 当出现一下异常时: shuffle file cannot find,executor lost.task lost,out of memory 出现 ...
随机推荐
- 【转载】Python: Enum枚举的实现
转自:http://www.cnblogs.com/codingmylife/archive/2013/05/31/3110656.html 从C系语言过来用Python,好不容易适应了写代码不打 ...
- 树莓派与windows互传文件
这是 meelo 原创的 玩转树莓派 系列文章 安装WinSCP 登录即可在左右两侧分别显示windows和树莓派中的文件 只需将文件从一侧拖到另一侧即可开始文件的传送
- npoi的用法,动态的判断单元格的大小,设置列的宽度
public MemoryStream GridToExcelByNPOI(DataTable dt, string strExcelFileName) { HSSFWorkbook wk = new ...
- 【Java多线程】线程池学习
Java线程池学习 众所周知,Java不仅提供了线程,也提供了线程池库给我们使用,那么今天来学学线程池的具体使用以及线程池基本实现原理分析. ThreadPoolExecutor ThreadPool ...
- 【Floyd】文化之旅
[NOIP2012]文化之旅 题目描述 有一位使者要游历各国,他每到一个国家,都能学到一种文化,但他不愿意学习任何一 种文化超过一次(即如果他学习了某种文化,则他就不能到达其他有这种文化的国家).不 ...
- 【记忆化搜索】codevs2823锁妖塔
[codevs2823]锁妖塔 Description 琐妖塔会在一会儿后倒塌.大量妖魔涌出塔去,塔内的楼梯都挤满了人(哦,错了,是妖),(那他们怎么不飞下去--)要求是,景天一行一定要下塔,琐妖塔一 ...
- BZOJ 2296【POJ Challenge】随机种子(构造)
[题目链接] http://www.lydsy.com/JudgeOnline/problem.php?id=2296 [题目大意] 给出一个数x,求一个10的16次以内的数使得其被x整除并且数字包含 ...
- 【最小割】【Dinic】Gym - 101201G - Maximum Islands
题意:方格内有些位置是水域,有些位置是陆地,有些位置是被云彩遮挡住了:让你自己规定被云彩遮挡住的地方是陆地还是水域,使得陆地个数最多.(均为四连通块) 显然与陆地邻接的云彩填成水比较优.其他云彩格子填 ...
- 【DFS】【拓扑排序】【动态规划】Gym - 100642A - Babs' Box Boutique
给你10个箱子,有长宽高,每个箱子你可以决定哪个面朝上摆.把它们摞在一起,边必须平行,上面的不能突出来,问你最多摆几个箱子. 3^10枚举箱子用哪个面.然后按长为第一关键字,宽为第二关键字,从大到小排 ...
- 【枚举+贪心】POJ2718-Smallest Difference
[题目大意] 按升序输出几个不同的数字,任意组成两个数字,输出最小的差值. [思路] 虽然是在穷竭搜索的章节里找到的题目,但是我觉得不需要穷竭搜索,枚举一下就可以了,0MS.分为一下三种情况: (1) ...