
实验 3 Spark 和 Hadoop 的安装
1. 安装 Hadoop 和 Spark
进入 Linux 系统,参照本教程官网“实验指南”栏目的“Hadoop 的安装和使用”,完成 Hadoop 伪分布式模式的安装。完成 Hadoop 的安装以后,再安装Spark(Local 模式)。
2. HDFS 常用操作
使用 hadoop 用户名登录进入 Linux 系统,启动 Hadoop,参照相关 Hadoop 书籍或网络资料,或者也可以参考本教程官网的“实验指南”栏目的“HDFS 操作常用 Shell 命令”,
使用Hadoop 提供的 Shell 命令完成如下操作:
(1) 启动Hadoop,在HDFS 中创建用户目录“/user/hadoop”;
hadoop fs -mkdir /user/hadoop
(2) 在 Linux 系统的本地文件系统的“/home/hadoop”目录下新建一个文本文件 test.txt,并在该文件中随便输入一些内容,然后上传到 HDFS 的“/user/hadoop”目录下;
hdfs dfs -put /home/hadoop/test.txt /usr/hadoop
(3) 把 HDFS 中“/user/hadoop”目录下的 test.txt 文件,下载到 Linux 系统的本地文件系统中的“/home/hadoop/下载”目录下;
hdfs dfs -get /user/hadoop/test.txt /home/hadoop
(4) 将HDFS 中“/user/hadoop”目录下的test.txt文件的内容输出到终端中进行显示;
hdfs dfs -cat /user/hadoop/test.txt
(5) 在 HDFS 中的“/user/hadoop” 目录下, 创建子目录 input ,把 HDFS 中 “/user/hadoop”目录下的 test.txt 文件,复制到“/user/hadoop/input”目录下;
hadoop fs -mkdir /user/hadoop/input

hdfs dfs -cp /user/hadoop/test.txt /user/hadoop/input
(6) 删除HDFS 中“/user/hadoop”目录下的test.txt文件,删除HDFS 中“/user/hadoop”目录下的 input 子目录及其子目录下的所有内容。
hdfs dfs -rm /user/hadoop/test.txt

hdfs dfs -rm -r /user/hadoop/input
3. Spark 读取文件系统的数据
(1) 在 spark-shell 中读取Linux 系统本地文件“/home/hadoop/test.txt”,然后统计出文件的行数;
bin/spark-shell

val textFile = sc.textFile("file:///home/hadoop/test1.txt")

textFile.count()

(2) 在 spark-shell 中读取HDFS 系统文件“/user/hadoop/test.txt”(如果该文件不存在,请先创建),然后,统计出文件的行数;
val textFile = sc.textFile("hdfs://node01:8020/user/hadoop/test.txt")
textFile.count()

(3) 编写独立应用程序,读取 HDFS 系统文件“/user/hadoop/test.txt”(如果该文件不存在,请先创建),然后,统计出文件的行数;通过 sbt 工具将整个应用程序编译打包成 JAR 包,并将生成的JAR 包通过 spark-submit 提交到 Spark 中运行命令。
cd ~                                                           # 进入用户主文件夹

mkdir ./sparkapp3                                              # 创建应用程序根目录

mkdir -p ./sparkapp3/src/main/scala                            # 创建所需的文件夹结构

vim ./sparkapp3/src/main/scala/SimpleApp.scala

----------------------------------------------------------

/* SimpleApp.scala */

import org.apache.spark.SparkContext

import org.apache.spark.SparkContext._

import org.apache.spark.SparkConf

object SimpleApp {

  def main(args: Array[String]) {

    val logFile = "hdfs://localhost:9000/home/hadoop/test.csv"

    val conf = new SparkConf().setAppName("Simple Application")

    val sc = new SparkContext(conf)

    val logData = sc.textFile(logFile, 2)

    val num = logData.count()

    println("这个文件有 %d 行!".format(num))

  }

}

----------------------------------------------------------

vim ./sparkapp3/simple.sbt

----------------------------------------------------------

name := "Simple Project"

version := "1.0"

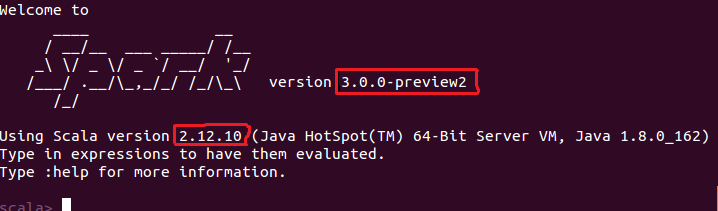
scalaVersion := "2.12.10"

libraryDependencies += "org.apache.spark" %% "spark-core" % "3.0.0-preview2"

----------------------------------------------------------
注意:文件 simple.sbt 需要指明 Spark 和 Scala 的版本,如下图所示:
cd ~/sparkapp3

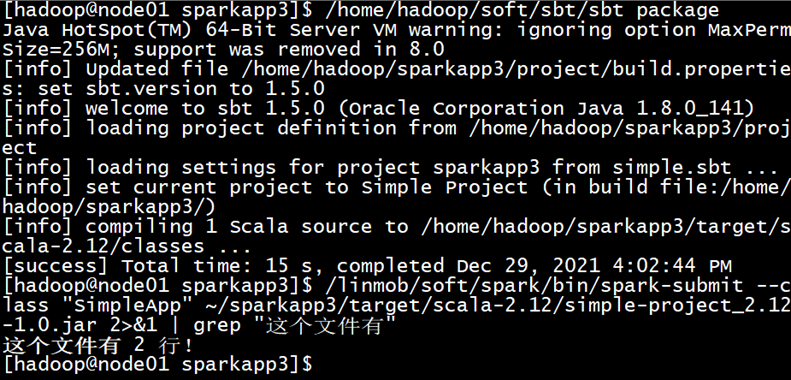
 /usr/local/sbt/sbt package           #这里是需要安装一个sbt,教程在下一篇linux安装sbt - 我试试这个昵称好使不 - 博客园 (cnblogs.com)
/usr/local/spark/bin/spark-submit --class "SimpleApp" ~/sparkapp3/target/scala-2.12/simple-project_2.12-1.0.jar 2>&1 | grep "这个文件有"
实验 3 Spark 和 Hadoop 的安装的更多相关文章
- spark实验(三)--Spark和Hadoop的安装(1)
一.实验目的 (1)掌握在 Linux 虚拟机中安装 Hadoop 和 Spark 的方法: (2)熟悉 HDFS 的基本使用方法: (3)掌握使用 Spark 访问本地文件和 HDFS 文件的方法. ...
- spark实验(一)--spark安装(1)
一.实验目的 (1)掌握 Linux 虚拟机的安装方法.Spark 和 Hadoop 等大数据软件在 Linux 操作系统 上运行可以发挥最佳性能,因此,本教程中,Spark 都是在 Linux 系统 ...
- Spark Hadoop Free 安装遇到的问题
运行 ./sbin/start-master.sh : SparkCommand:/usr/lib/jvm/java-8-openjdk-amd64/jre/bin/java -cp /home/se ...
- spark的standlone模式安装和application 提交
spark的standlone模式安装 安装一个standlone模式的spark集群,这里是最基本的安装,并测试一下如何进行任务提交. require:提前安装好jdk 1.7.0_80 :scal ...
- Spark系列—01 Spark集群的安装
一.概述 关于Spark是什么.为什么学习Spark等等,在这就不说了,直接看这个:http://spark.apache.org, 我就直接说一下Spark的一些优势: 1.快 与Hadoop的Ma ...
- Spark大数据平台安装教程
一.Spark介绍 Apache Spark 是专为大规模数据处理而设计的快速通用的计算引擎.Spark是开源的类Hadoop MapReduce的通用并行框架,Spark拥有Hadoop MapRe ...
- Spark学习笔记--Linux安装Spark集群详解
本文主要讲解如何在Linux环境下安装Spark集群,安装之前我们需要Linux已经安装了JDK和Scala,因为Spark集群依赖这些.下面就如何安装Spark进行讲解说明. 一.安装环境 操作系统 ...
- Spark standalone模式的安装(spark-1.6.1-bin-hadoop2.6.tgz)(master、slave1和slave2)
前期博客 Spark运行模式概述 Spark standalone简介与运行wordcount(master.slave1和slave2) 开篇要明白 (1)spark-env.sh 是环境变量配 ...
- 网站用户行为分析——Hadoop的安装与配置(单机和伪分布式)
Hadoop安装方式 Hadoop的安装方式有三种,分别是单机模式,伪分布式模式,伪分布式模式,分布式模式. 单机模式:Hadoop默认模式为非分布式模式(本地模式),无需进行其他配置即可运行.非分布 ...
随机推荐
- css3渐变色字体
\3cspan id="mce_marker" data-mce-type="bookmark">\3c/span>\3cspan id=" ...
- 2022年官网下安装GIT最全版与官网查阅方法
目录 安装部署Git 1.百度搜索git,双击进入. 2.进入主页,双击如图位置. 3.进入下载列表,双击下载. 4.找到本地文件位置,双击安装,弹出界面,选择next 5.进入安装路径位置,修改路径 ...
- 微信小程序发布列表页面处理
wxml: <!--pages/good_index/good_index.wxml--> <view class='list'> <block wx:for='{{in ...
- Owin + WebApi + OAuth2 搭建授权模式(授权码模式 Part I)
绪 最近想要整理自己代码封装成库,也十分想把自己的设计思路贴出来让大家指正,奈何时间真的不随人意. 想要使用 OWIN 做中间件服务,该服务中包含 管线.授权 两部分.于是决定使用 webapi .O ...
- MacOS新功能“通用控制”,多台设备操作互联太方便了!
昨天看到macOS推送了12.3的更新,记得之前预告过一个"通用控制"的功能,所以赶紧升级一波体验一下,效果惊艳到我了,赶紧安利一波! 先交代一下现在隔离在家的办公情况,我主要是用 ...
- ArcMap线上均匀生成点
面中均匀生成点方法: [创建渔网]→[要素转点](或[要素折点转点])→[裁剪](或[按位置选择]→[导出数据]),即可. ArcMap中随机生成点: [随机生成点]工具 最近博主的朋友有均匀布点的需 ...
- 论如何在使用RedisStandaloneConfiguration时让JedisConnectionFactory用上JedisPoolConfig
前言 公司项目上线后经常运行一两天后就会出现延时.无响应的情况,当时第一反应觉得可能是某些业务优化不行,检查业务也没发现有什么问题,前前后后倒是修了两三个BUG,本以为没啥事儿了,但也就好了两天,很奇 ...
- Java基础——类与接口
一.类与接口的关系 1.类与类的关系 继承关系,只能单继承,不能多继承:但是可以多层继承 2.类与接口的关系 实现关系,可以单实现,也可以多实现,还可以继承一个类的同时实现多个接口 3.接口与接口的关 ...
- 4月2日 python学习总结
昨天内容回顾: 1.迭代器 可迭代对象: 只要内置有__iter__方法的都是可迭代的对象 既有__iter__,又有__next__方法 调用__iter__方法==>得到内置的迭代器对象 调 ...
- 关于使用charles进行mock步骤
1.应用场景: 1.1 测试环境中,可能存在部分依赖外部系统的http接口,因为外部系统未部署或服务不可用等其他原因,导致接口无法正常响应(特别是qa1环境): 而平时的测试主要还是以界面上的功能测试 ...