
正则爬取某段子网站前20页段子(request库)
首先还是谷歌浏览器抓包对该网站数据进行分析,结果如下:
- 该网站地址:http://www.budejie.com/text
- 该网站数据都是通过html页面进行展示,网站url默认为第一页,http://www.budejie.com/text/2为第二页,以此类推
- 对网站的内容段子所处位置进行分析,发现段子内容都是在一个 a 标签中
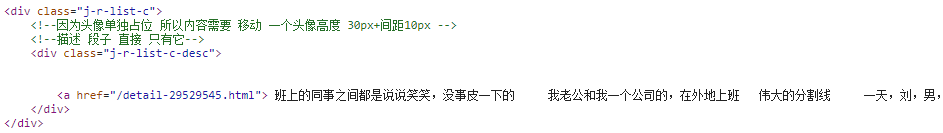
- 坑还是有的,这是我第一次写的正则:
content_list = re.findall(r'<a href="/detail-.*">(.+?)</a>', html_str)
- 之后发现竟然匹配到了一些推荐的内容,最后我把正则改变下面这样,发现没有问题了,关于正则的知识这里就不做过多解释了
content_list = re.findall(r'<div class="j-r-list-c-desc">\s*<a href="/detail-.*">(.+?)</a>', html_str)
- 现在要的是爬取前20页的段子并保存到本地,已经知道翻页的规律和匹配内容的正则,就直接可以写代码了
代码如下,整体思路还是和前两排爬虫博客一样,面向对象的写法:
 import requests

 import re

 import json

 class NeihanSpider(object):

     """内涵段子,百思不得其姐,正则爬取一页的数据"""

     def __init__(self):

         self.temp_url = 'http://www.budejie.com/text/{}'  # 网站地址,给页码留个可替换的{}

         self.headers = {

             'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36',

         }

     def pass_url(self, url):  # 发送请求,获取响应

         print(url)

         response = requests.get(url, headers=self.headers)

         return response.content.decode()

     def get_first_page_content_list(self, html_str):  # 提取第一页的数据

         content_list = re.findall(r'<div class="j-r-list-c-desc">\s*<a href="/detail-.*">(.+?)</a>', html_str)  # 非贪婪匹配

         return content_list

     def save_content_list(self, content_list):

         with open('neihan.txt', 'a', encoding='utf-8') as f:

             for content in content_list:

                 f.write(json.dumps(content, ensure_ascii=False))

                 f.write('\n')  # 换行

             print('成功保存一页!')

     def run(self):  # 实现主要逻辑

         for i in range(20):  # 只爬取前20页数据

             # 1. 构造url

             # 2. 发送请求,获取响应

             html_str = self.pass_url(self.temp_url.format(i+1))

             # 3. 提取数据

             content_list = self.get_first_page_content_list(html_str)

             # 4. 保存

             self.save_content_list(content_list)

 if __name__ == '__main__':

     neihan = NeihanSpider()

     neihan.run()
正则爬取某段子网站前20页段子(request库)的更多相关文章
- requests+正则爬取豆瓣图书
#requests+正则爬取豆瓣图书 import requests import re def get_html(url): headers = {'User-Agent':'Mozilla/5.0 ...
- 正则爬取京东商品信息并打包成.exe可执行程序
本文爬取内容,输入要搜索的关键字可自动爬取京东网站上相关商品的店铺名称,商品名称,价格,爬取100页(共100页) 代码如下: ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 1 ...
- requests+正则爬取猫眼电影前100
最近复习功课,日常码农生活. import requests from requests.exceptions import RequestException import re import jso ...
- 【Python】python3 正则爬取网页输出中文乱码解决
爬取网页时候print输出的时候有中文输出乱码 例如: \\xe4\\xb8\\xad\\xe5\\x8d\\x8e\\xe4\\xb9\\xa6\\xe5\\xb1\\x80 #爬取https:// ...
- 正则爬取京东商品信息并打包成.exe可执行程序。
本文爬取内容,输入要搜索的关键字可自动爬取京东网站上相关商品的店铺名称,商品名称,价格,爬取100页(共100页) 代码如下: import requests import re # 请求头 head ...
- 爬取百度贴吧前1000页内容(requests库面向对象思想实现)
此程序以李毅吧为例子,以面向对象的设计思想实现爬取保存网页数据,暂时并未用到并发处理,以后有机会的话会加以改善 首先去百度贴吧分析贴吧地址栏中url后的参数,找到分页对应的参数pn,贴吧名字对应的参数 ...
- 爬虫实战1:使用requests和正则爬取电影信息
代码如下 # coding=utf-8 import requests from requests.exceptions import RequestException import re impor ...
- go 正则 爬取邮箱代码
package main import ( "net/http" "fmt" "io/ioutil" "regexp" ...
- <爬虫>用正则爬取B站首页图片
import re import requests headers = { 'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) Apple ...
随机推荐
- 2019牛客暑期多校训练营(第二场)E 线段树维护dp转移矩阵
题意 给一个\(n\times m\)的01矩阵,1代表有墙,否则没有,每一步可以从\(b[i][j]\)走到\(b[i+1][j]\),\(b[i][j-1]\),\(b[i][j+1]\),有两种 ...
- apt 和 apt-get的区别
apt 和 apt-get的区别 - liudsl的博客 - CSDN博客 https://blog.csdn.net/liudsl/article/details/79200134 Linux软件 ...
- MySQL_(Java)提取工具类JDBCUtils
MySQL_(Java)使用JDBC向数据库发起查询请求 传送门 MySQL_(Java)使用JDBC创建用户名和密码校验查询方法 传送门 MySQL_(Java)使用preparestatement ...
- HLS协议解析
1. 综述 HLS(HTTP Live Streaming) 把整个流分成一个个小的基于 HTTP 的文件来下载,每次只下载一些.HLS 协议由三部分组成:HTTP.M3U8.TS.这三部分中,HTT ...
- Redis5.0 3台主机三主三从部署Cluster集群
1.下载安装 [root@ip101 redis-5.0.4]# pwd /opt/app/redis-5.0.4 [root@ip101 redis-5.0.4]# ls 00-RELEASENOT ...
- Unexpected ConvertTo-Json results? Answer: it has a default -Depth of 2
Unexpected ConvertTo-Json results? Answer: it has a default -Depth of 2 问题 Why do I get unexpected C ...
- react 的定义组件(了解)
react 中定义组件的方法 1. 定义组件 React.createClass() (被淘汰了) 定义组件中的函数 methods 的中的 this 统统指向 组件 2. 函数定义组件 定义的组件时 ...
- ccf 201712-4 行车路线(70分)
ccf 201712-4 行车路线 解题思路: 首先Dijkstra是基于贪心算法的,即每一次作出的选择都具有贪心选择性.此题由于有“如果连续走小道,小明的疲劳值会快速增加,连续走s公里小明会增加s2 ...
- LC 846. Hand of Straights
Alice has a hand of cards, given as an array of integers. Now she wants to rearrange the cards into ...
- vs2010 SetUp 安装软件时,界面出现乱码的问题
AppLocale在简体中文系统里使用之后, 会令某些简体中文的MSI形式的安装程序 显示乱码(比如: OFFICE2000简体中文版安装程序). 解决方法: 方法一: 卸载AppLocale即可解决 ...