
Python爬取前程无忧网站上python的招聘信息
前言
文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理。
作者: 我姓刘却留不住你的心
PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取
http://note.youdao.com/noteshare?id=3054cce4add8a909e784ad934f956cef
本文获取的字段有为职位名称,公司名称,公司地点,薪资,发布时间
创建爬虫项目
scrapy startproject qianchengwuyou
cd qianchengwuyou
scrapy genspider -t crawl qcwy www.xxx.com
items中定义爬取的字段
import scrapy
class QianchengwuyouItem(scrapy.Item):
# define the fields for your item here like:
job_title = scrapy.Field()
company_name = scrapy.Field()
company_address = scrapy.Field()
salary = scrapy.Field()
release_time = scrapy.Field()
qcwy.py文件内写主程序
import scrapy
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule
from qianchengwuyou.items import QianchengwuyouItem
class QcwySpider(CrawlSpider):
name = 'qcwy'
# allowed_domains = ['www.xxx.com']
start_urls = ['https://search.51job.com/list/000000,000000,0000,00,9,99,python,2,1.html?']
# https://search.51job.com/list/000000,000000,0000,00,9,99,python,2,7.html?lang=c&postchannel=0000&workyear=99&cotype=99°reefrom=99&jobterm=99&companysize=99&ord_field=0&dibiaoid=0&line=&welfare=
rules = (
Rule(LinkExtractor(allow=r'https://search.51job.com/list/000000,000000,0000,00,9,99,python,2,(\d+).html?'), callback='parse_item', follow=True),
)
def parse_item(self, response):
list_job = response.xpath('//div[@id="resultList"]/div[@class="el"][position()>1]')
for job in list_job:
item = QianchengwuyouItem()
item['job_title'] = job.xpath('./p/span/a/@title').extract_first()
item['company_name'] = job.xpath('./span[1]/a/@title').extract_first()
item['company_address'] = job.xpath('./span[2]/text()').extract_first()
item['salary'] = job.xpath('./span[3]/text()').extract_first()
item['release_time'] = job.xpath('./span[4]/text()').extract_first()
yield item
pipelines.py文件中写下载规则
import pymysql
class QianchengwuyouPipeline(object):
conn = None
mycursor = None
def open_spider(self, spider):
print('链接数据库...')
self.conn = pymysql.connect(host='172.16.25.4', user='root', password='root', db='scrapy')
self.mycursor = self.conn.cursor()
def process_item(self, item, spider):
print('正在写数据库...')
job_title = item['job_title']
company_name = item['company_name']
company_address = item['company_address']
salary = item['salary']
release_time = item['release_time']
sql = 'insert into qcwy VALUES (null,"%s","%s","%s","%s","%s")' % (
job_title, company_name, company_address, salary, release_time)
bool = self.mycursor.execute(sql)
self.conn.commit()
return item
def close_spider(self, spider):
print('写入数据库完成...')
self.mycursor.close()
self.conn.close()
settings.py文件中打开下载管道和请求头
ITEM_PIPELINES = {

   'qianchengwuyou.pipelines.QianchengwuyouPipeline': 300,

}

USER_AGENT = 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/534.57.2 (KHTML, like Gecko) Version/5.1.7 Safari/534.57.2'
运行爬虫,同时写入.json文件
scrapy crawl qcwy -o qcwy.json --nolog
查看数据库是否写入成功,
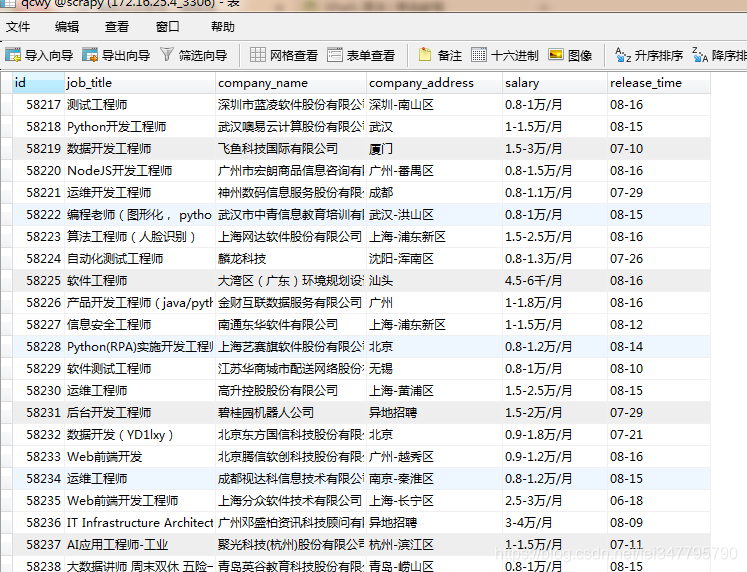
.
Python爬取前程无忧网站上python的招聘信息的更多相关文章
- 爬取前程无忧网站上python的招聘信息。
本文获取的字段有为职位名称,公司名称,公司地点,薪资,发布时间 创建爬虫项目 scrapy startproject qianchengwuyou cd qianchengwuyou scrapy g ...
- python爬取当当网的书籍信息并保存到csv文件
python爬取当当网的书籍信息并保存到csv文件 依赖的库: requests #用来获取页面内容 BeautifulSoup #opython3不能安装BeautifulSoup,但可以安装Bea ...
- 使用python爬取东方财富网机构调研数据
最近有一个需求,需要爬取东方财富网的机构调研数据.数据所在的网页地址为: 机构调研 网页如下所示: 可见数据共有8464页,此处不能直接使用scrapy爬虫进行爬取,因为点击下一页时,浏览器只是发起了 ...
- [转]使用python爬取东方财富网机构调研数据
最近有一个需求,需要爬取东方财富网的机构调研数据.数据所在的网页地址为: 机构调研 网页如下所示: 可见数据共有8464页,此处不能直接使用scrapy爬虫进行爬取,因为点击下一页时,浏览器只是发起了 ...
- Python爬取散文网散文
配置python 2.7 bs4 requests 安装 用pip进行安装 sudo pip install bs4 sudo pip install requests 简要说明一下bs4的使用因为是 ...
- Python 爬取赶集网租房信息
代码已久,有可能需要调整 #coding:utf-8 from bs4 import BeautifulSoup #有这个bs4不用正则也可以定位要爬取的内容了 from urlparse impor ...
- 利用python爬取贝壳网租房信息
最近准备换房子,在网站上寻找各种房源信息,看得眼花缭乱,于是想着能否将基本信息汇总起来便于查找,便用python将基本信息爬下来放到excel,这样一来就容易搜索了. 1. 利用lxml中的xpath ...
- python爬取返利网中值得买中的数据
先使用以前的方法将返利网的数据爬取下来,scrapy框架还不熟练,明日再战scrapy 查找目标数据使用的是beautifulsoup模块. 1.观察网页,寻找规律 打开值得买这块内容 1>分析 ...
- Python爬取网址中多个页面的信息
通过上一篇博客了解到爬取数据的操作,但对于存在多个页面的网址来说,使用上一篇博客中的代码爬取下来的资料并不完整.接下来就是讲解该如何爬取之后的页面信息. 一.审查元素 鼠标移至页码处右键,选择检查元素 ...
随机推荐
- os.path.isfile()的正确用法(正确用法)
之前网上查找os.path.isfile( )的使用:发现有些是错误的,主要原因是,传入的参数是相对路径,不是绝对路径. 但是,经过我的实验发现:os.path.isfile( )需要传入的参数是绝对 ...
- [转]为什么group by后面不能使用别名(除MySQL)
同事工作中遇到一个问题: select count(billingdate),to_char(billingdate,'YYYYmm') month from tu_trade where to_ ...
- Fiddler使用过程中容易忽略的小技巧
fiddler的基本使用,在之前的一篇博文中有详细介绍,可参见Fiddler抓包工具使用详解,今天来分享几个容易忽略的小技巧. 1.ios机装了证书,依然抓不到包 近期总被同事问及ios机装了证书,但 ...
- CRM第一篇
2.1搭建前提 我们在搭建CRM开发环境之前,需要明确2件事情: a.我们搭建环境采用基于注解的配置. b.搭建环境需要测试,我们以客户的保存和列表查询作为测试功能. 2.2搭建步骤 2.2.1导入S ...
- 在做nav-bar部分点击路由跳转相同地址时,控制台报错问题。
报错信息: Uncaught (in promise) NavigationDuplicated {_name: "NavigationDuplicated", name: &qu ...
- Oracle 备份数据库
[目录] ①备份数据库(https://www.cnblogs.com/xqz0618/p/oracle_backup.html) ②定时备份数据库(https://www.cnblogs.com/x ...
- 读取property配置的N种方式
@Value注解 @Value("${ddd}") <!-- 加载配置属性文件 --> <context:property-placeholder ignore- ...
- 中间人攻击,HTTPS也可以被碾压
摘要: 当年12306竟然要自己安装证书... 原文:知道所有道理,真的可以为所欲为 公众号:可乐 Fundebug经授权转载,版权归原作者所有. 一.什么是MITM 中间人攻击(man-in-the ...
- 由导入paramkio包失败,而pip list又能查到此包,而引出的:离线安装python第三方库的实用方法:解决公司内网,服务器/电脑不能上网却需要安装python三方库问题(下:Linux环境中)
问题描述: 公司的Linux服务器是内网,今天要实现某个功能,会用到python控制ssh,需要安装一个Paramkio库,和上一篇一样,仅仅依靠Pypi上下载下来的离线.whl安装包是不行的,lin ...
- docker 存储卷 Volumes
一,docker容器面临的困境: 容器运行中产生的数据,是放到容器栈的最顶层,当容器停止并被删除后,这些数据就被删除了. docker采用COW(写时复制)策略,导致性能低下.比如有个mysql容器, ...