
Python爬无止境,获得王者荣耀全部高清皮肤
作为一名热爱王者两年的程序员,早就想爬取所有英雄皮肤的高清照片,在设个幻灯片放映,真香,这次只用16行代码就能实现,对于新手拿这个作为实战练手项目既简单又容易上手,快来尝试下。
百度"王者荣耀"进入官网 https://pvp.qq.com/,我这边直接以Goole Chrome浏览器为例,在更多工具中选择开发者工具,或直接按F12进入调试界面,然后按F5刷新界面
图中标识的herolist.json文件就是我们所需要的英雄列表,其中包括英雄编号、英雄名称、英雄类型、皮肤的名称等信息,在文件上右击复制链接
接下来验证一下我们寻找的是否正确,代码:
import urllib.request

import json

import os

response = urllib.request.urlopen("http://pvp.qq.com/web201605/js/herolist.json")

hero_json = json.loads(response.read())

hero_num = len(hero_json)

print(hero_json)

print("hero_num : " , str(hero_num))
以上代码读取英雄列表并存入hero_json,并获取英雄数量,运行效果如下图
点击首页的“游戏资料”标签页,进入新的页面后随意点击一个英雄头像进入英雄资料页面,以李白为例。同样的F12然后F5,将鼠标在李白的几个皮肤上一次扫过 如图:
可以看到李白的高清皮肤一共有6个,同样我们在一个皮肤上右键复制链接得到:
https://game.gtimg.cn/images/yxzj/img201606/skin/hero-info/131/131-bigskin-6.jpg
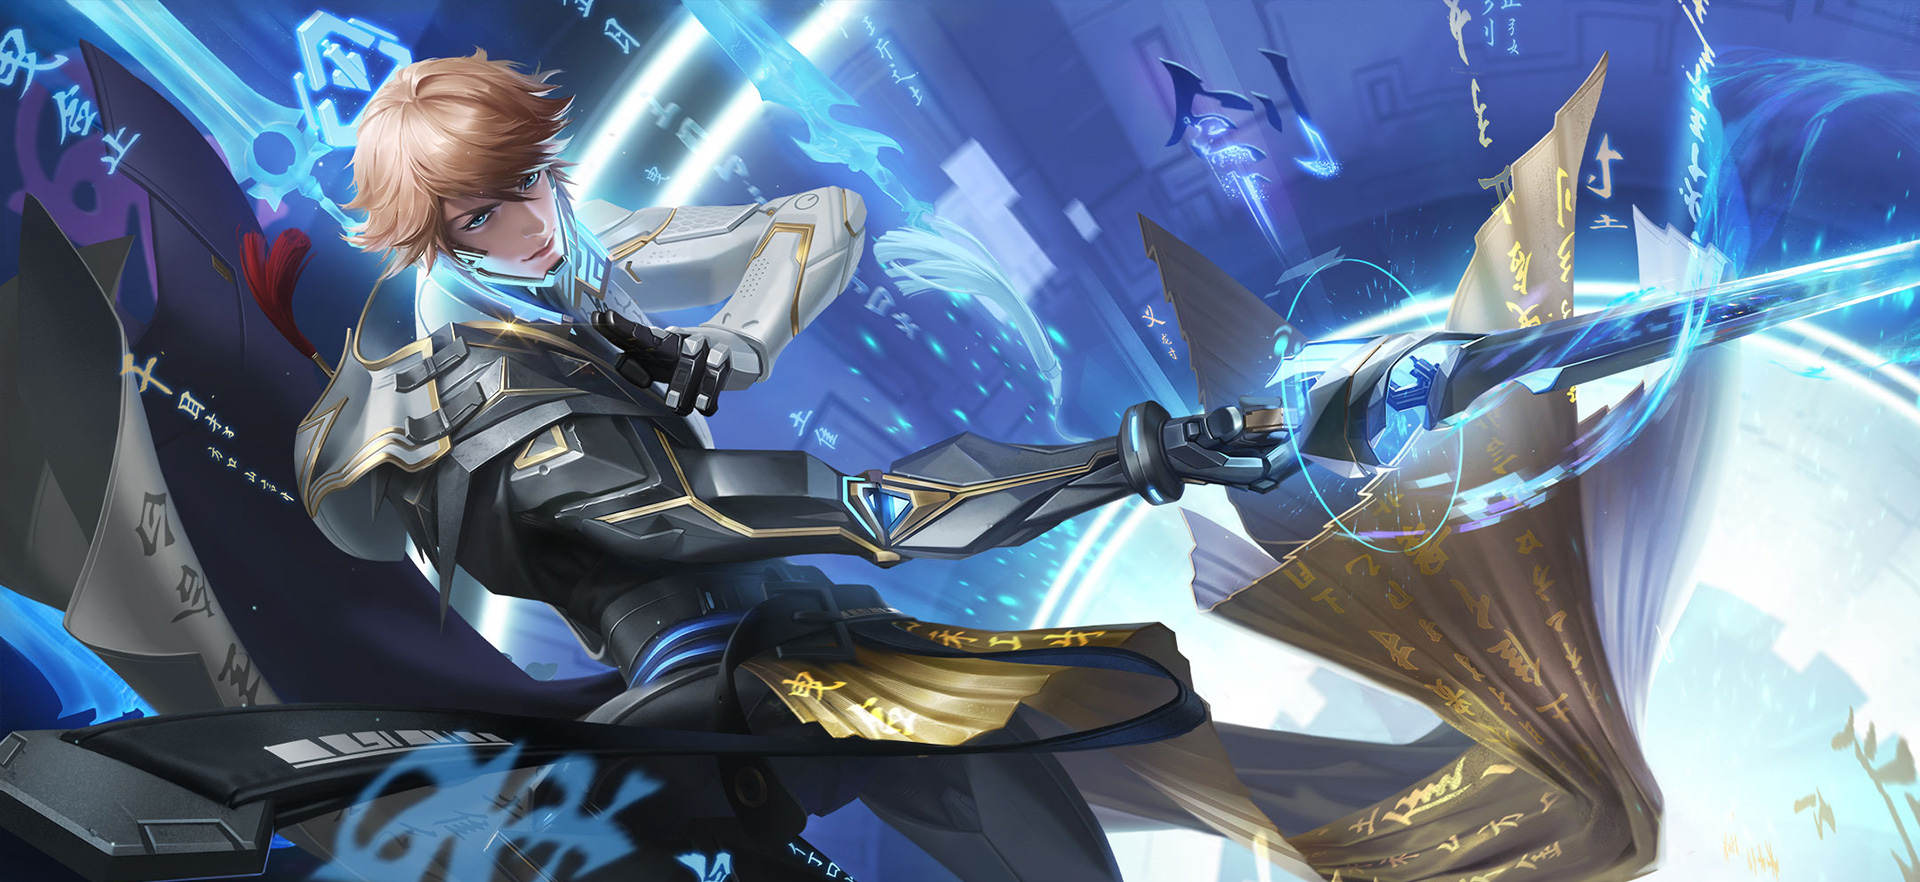
分析这个链接我们可以发现,其中‘131'是英雄的编号,最后的'-6'是该英雄的皮肤编号。到这里,浏览器上所需要的信息我们已经全部获得,可以开始下载
在第一步获取到的herolist.json文件中有'skin_name'字段,我们只要解析这个字段就可以获取皮肤数量与名称。 代码如下:
hero_name = hero_json[0]['cname']

skin_names = hero_json[0]['skin_name'].split('|')

skin_num = len(skin_names)

print('hero_name: ', hero_name)

print('skin_names :', skin_names)

print('skin_num: ' + str(skin_num))
下载文件用到urlretrieve接口,并且考虑两个问题:
- 检查文件夹是否存在,不存在则创建。
save_dir = 'D:\heroskin\\'

if not os.path.exists(save_dir):

os.mkdir(save_dir)
- 检查图片文件是否存在,如果存在则跳过下载。
if not os.path.exists(save_file_name):

urllib.request.urlretrieve(skin_url, save_file_name)
完整代码如下,除去注释和空行一共16行代码:
import urllib.request

import json

import os

response = urllib.request.urlopen("http://pvp.qq.com/web201605/js/herolist.json")

hero_json = json.loads(response.read())

hero_num = len(hero_json)

save_dir = 'D:\heroskin\\'

if not os.path.exists(save_dir):

 os.mkdir(save_dir)

 for i in range(hero_num):

  # 获取英雄皮肤列表

  skin_names = hero_json[i]['skin_name'].split('|')

  for cnt in range(len(skin_names)):

   save_file_name = save_dir + str(hero_json[i]['ename']) + '-' +hero_json[i]['cname']+ '-' +skin_names[cnt] + '.jpg'

   skin_url = 'http://game.gtimg.cn/images/yxzj/img201606/skin/hero-info/'+str(hero_json[i]['ename'])+ '/' +str(hero_json[i]['ename'])+'-bigskin-' + str(cnt+1) +'.jpg'

   print(skin_url)

   if not os.path.exists(save_file_name):

    urllib.request.urlretrieve(skin_url, save_file_name)
实现后的效果如图所示:
分享到这结束啦,更多Python精彩内容可以关注我看我主页,
Python爬无止境,获得王者荣耀全部高清皮肤的更多相关文章
- python爬虫王者荣耀高清皮肤大图背景故事通用爬虫
wzry-spider python通用爬虫-通用爬虫爬取静态网页,面向小白 基本上纯python语法切片索引,少用到第三方爬虫网络库 这是一只小巧方便,强大的爬虫,由python编写 主要实现了: ...
- Python编程:从入门到项目实践高清版附PDF百度网盘免费下载|Python入门编程免费领取
百度网盘:Python编程:从入门到项目实践高清版附PDF免费下载 提取码:oh2g 第一部分 基础知识第1章 起步 21.1 搭建编程环境 21.1.1 Python 2和Python 3 21 ...
- 用python的requests第三方模块抓取王者荣耀所有英雄的皮肤
本文使用python的第三方模块requests爬取王者荣耀所有英雄的图片,并将图片按每个英雄为一个目录存入文件夹中,方便用作桌面壁纸 下面时具体的代码,已通过python3.6测试,可以成功运行: ...
- 别人用钱,而我用python爬虫爬取了一年的4K高清壁纸
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取htt ...
- Python爬虫——你们要的王者荣耀高清图
曾经144区的王者 学了计算机后 头发逐渐从李白变成了达摩 秀发有何用,变秃亦变强 (emmm徒弟说李白比达摩强,变秃不一定变强) 前言 前几天开了农药的安装包,发现农药是.Net实现的游戏 虽然游戏 ...
- java学习无止境,工资价更高
原 推荐10个Java方向最热门的开源项目(8月) 2018年08月28日 17:54:32 SnailClimb在CSDN 阅读数:849 版权声明:本文为博主原创文章,未经博主允许不得转载. ...
- 利用Python进行数据分析【第二版】【高清中文版英文版源代码】
如果被河蟹请回复我更新链接 这是我花钱弄的,免费分享给大家.没有密码,直接可以观看! 希望大家不要拿去后再做收费分享 如果好用,请给个赞好嘛~~~ 1.中文pdf 链接:https:/ ...
- Python爬虫-爬取科比职业生涯高清图集
前面学习了Python爬取豆瓣电影Top250的数据,爬取的信息是电影信息的文本信息,但是在互联网上流行的图片才有更大的吸引力,本篇我们来使用python爬取网页上的图片并保存在本地硬盘上,很兴奋吧, ...
- Python 爬取高清桌面壁纸
今天写了一个脚本用来爬取ZOL桌面壁纸网站的高清图片: 链接:http://desk.zol.com.cn/1920x1080/ 本程序只爬了美女板块的图片,若要下载其他板块,只需修改程序中的&quo ...
随机推荐
- Spring学习02(DI依赖注入)
5.依赖注入(Dependency Injection,DI) 5.1 概念 依赖 : 指Bean对象的创建依赖于容器 . Bean对象的依赖资源 . 注入 : 指Bean对象所依赖的资源 , 由容器 ...
- shell——sed编辑器
目录 一.sed编辑器 1.1.sed编辑器工作流程 读取: 执行: 显示: 1.2.格式 1.3.常用选项 1.4.常用操作 1.5.替换 一.sed编辑器 sed是一种流编辑器,流编辑器会在编辑器 ...
- 刚学spark
https://blog.csdn.net/u013019431/article/details/80776662 在jupyter notebook import pysparkhttps:// ...
- 开源中国【面经】Java后台开发
2021.04.09 直接正文: 开场自我介绍,说一下自己 有没有实习经历?(毕业实习) 毕业实习学了什么?(前端) 有什么大项目吗?(除了课设就是毕设) 能说一下毕设的情况吗?(做了大概,没有开始登 ...
- Python 读写文件的正确方式
当你用 Python 写程序时,不论是简单的脚本,还是复杂的大型项目,其中最常见的操作就是读写文件.不管是简单的文本文件.繁杂的日志文件,还是分析图片等媒体文件中的字节数据,都需要用到 Python ...
- docker 实现redis主从复制
目录 一.概览 二.安装master库 三.安装slave从库 四.错误分析 五.参考网址 一.概览 主库:192.168.3.13:6380 从库一:192.168.3.14:6381 从库二:19 ...
- nodejs koa2 设置 静态资源目录
参考这篇文章:https://blog.csdn.net/qq_38262910/article/details/89147571?utm_medium=distribute.pc_relevant_ ...
- 使用VC6.0开发COM组件 - 傻瓜式,不讲理论,只讲实例
1.创建一个ATL COM AppWizard工程,如图:
- jsoup的Node类
一.简介 Node类直接继承Object,实现了Cloneable接口,它是一个抽象类,类声明:public abstract class Node extends Object implements ...
- 修改python import模块中的变量
可以直接通过 模块名.变量名=xx 的方式修改模块中的全局变量,测试代码如下 模块:test_model.py x = 111 def inc_x(): global x x = x + 1 测试脚本 ...