
【Python3爬虫】最新的12306爬虫
一、写在前面
我在以前写过一次12306网站的爬虫,当时实现了模拟登录和查询车票,但是感觉还不太够,所以对之前的代码加以修改,还实现了一个订购车票的功能。
二、主要思路
在使用Selenium做模拟登录12306网站的时候,需要将登录成功后的Cookie保存下来,这个Cookie在后面是必需的。然后就是在12306网站上查票订票,同时使用Fiddler软件进行抓包,通过分析得到订票所需的十多个请求,只要依次发送这些请求,在请求成功之后就能够订到票。
三、模拟登录
之前的代码已经基本实现了模拟登录的功能,但是还没法得到想要的Cookie,所以需要对之前的代码进行改进。虽然Selenium模块提供了get_cookies()方法,但是使用这个方法得到的是当前会话的Cookie,也就是Selenium开启的浏览器中当前页面的Cookie,这个Cookie和本地浏览器中的Cookie是不同的。如下是从本地Chrome中拷贝的Cookie,其中以_jc_save开头的字段都是之前查询车票的记录,而其余字段都是生成的:
JSESSIONID=A318817EEE594DE954CE352761DF4CD7;
_jc_save_fromStation=%u6B66%u6C49%2CWHN;
_jc_save_wfdc_flag=dc;
_jc_save_toStation=%u4E0A%u6D77%2CAOH;
RAIL_EXPIRATION=1560095439082;
RAIL_DEVICEID=P2wunHEkKFe9MgTM56h-NxsWiIGNkK6JLCOVaG0DHzRm-RxYa7YnDwftPoumiZ0wL7GPsQ93YBHRHgMgB_GLWwZ9Vb65tNiVuwaIOytW8lVG7B1KopI4pSyUr1u06RWpKPhvExBg3FA7ed87WxO3E-68Wg-hXZLl;
_jc_save_fromDate=2019-06-30;
_jc_save_toDate=2019-06-06;
_jc_save_showIns=true;
route=495c805987d0f5c8c84b14f60212447d;
BIGipServerotn=300941834.24610.0000;
BIGipServerpool_passport=250413578.50215.0000
下面是使用Selenium模块的get_cookies()方法得到的Cookie,可以看到和浏览器中的Cookie有很大不同,缺少了很多字段:
[{'domain': 'kyfw.12306.cn', 'httpOnly': False, 'name': 'JSESSIONID', 'path': '/otn', 'secure': False, 'value': '672BAF8C694C50C49D3EFFCF9913A745'},
{'domain': 'kyfw.12306.cn', 'httpOnly': False, 'name': 'route', 'path': '/', 'secure': False, 'value': 'c5c62a339e7744272a54643b3be5bf64'},
{'domain': 'kyfw.12306.cn', 'httpOnly': False, 'name': 'BIGipServerotn', 'path': '/', 'secure': False, 'value': '1139802634.24610.0000'}]
解决办法是使用add_cookie()方法向Selenium开启的Chrome中添加Cookie,达到模拟本地浏览器的效果,最终就能登录成功。在登录成功之后,要获取此时的Cookie,除了使用get_cookies()方法或者get_cookie()方法,还可以使用如下语句:
cookie = browser.execute_script("return document.cookie;")不过为了验证是否真的登录成功了,还需要进行一下测试,验证是否登录成功的方法如下代码,这段代码会发送一个请求,请求的结果中包含了是否登录信息(即is_login)和用户名等信息:
 def get_name(self):

     """

     获取用户姓名

     :return:

     """

     url = "https://kyfw.12306.cn/otn/login/conf"

     res = requests.post(url, headers=self.headers)

     is_login = res.json()['data']['is_login']

     if is_login == 'Y':

         self.name = res.json()['data']['name']

         print("欢迎用户:{}".format(self.name))

     else:

         print("未登录!请先登录。")
四、订购车票
由于查询车票之前就已经做过了,所以这里就不再赘述。这里就说查询车票之后的操作,首先是在12306网站上查余票,然后选择一个车次点击预订,就会跳转到如下页面:
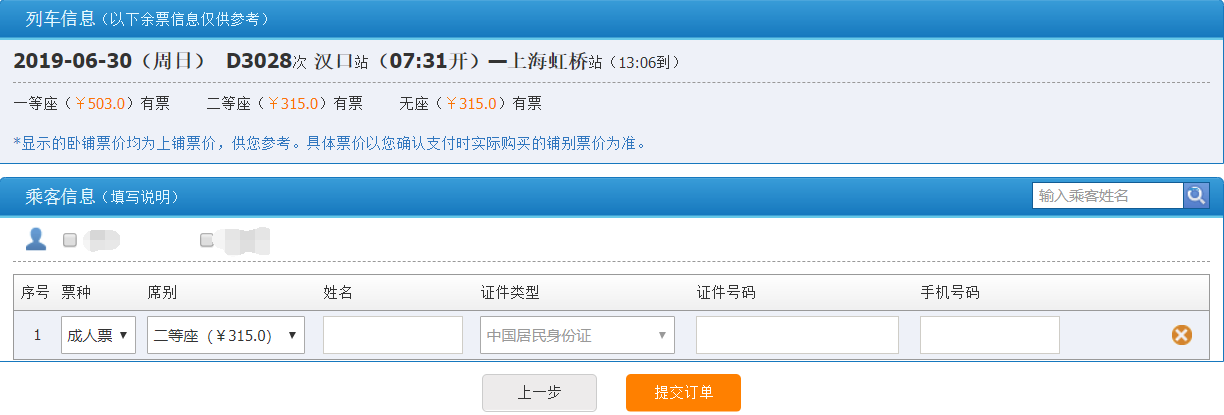
在这个页面上可以选择乘客、选择座位类型,然后再提交订单。这里虽然我们可以使用开发者工具然后刷新页面来抓包,但是为了避免遗漏掉某些请求,所以我选择使用Fiddler软件抓包,最终经过分析实践得到12个请求,其url和对应的含义如下图所示:
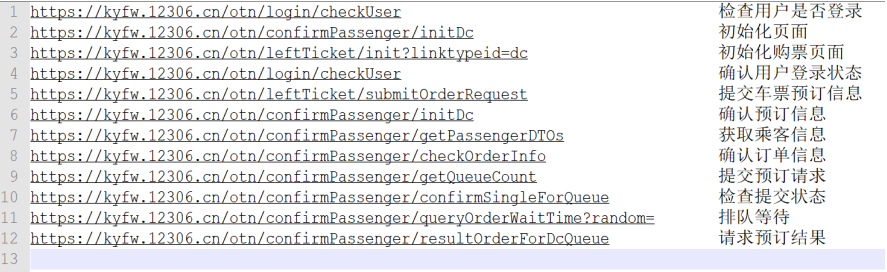
这里我并不打算把所有的请求都说一遍,我会将几个重要的请求拿出来描述,这些请求所使用的headers都是一样的,其中包含了登录后的Cookie,如果Cookie失效就会导致订票失败。
1.初始化页面
首先是initDc这个请求,在这个请求的结果中包含了后面请求所必需的一个参数--token(如下图),获取的方法也比较简单,可以直接使用正则表达式进行匹配:
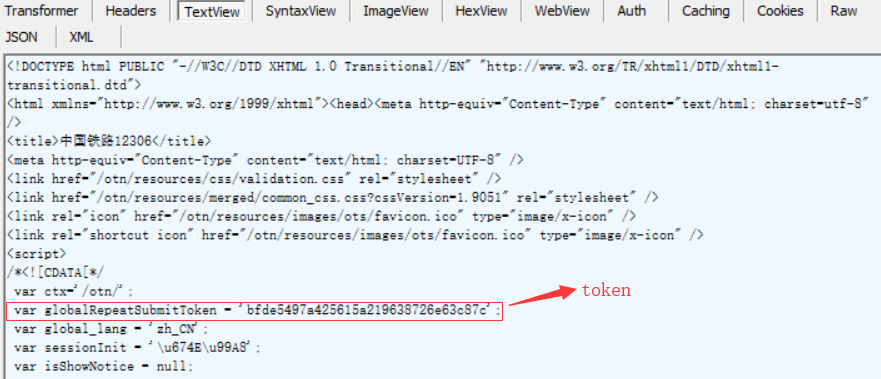
初始化页面获取token的代码如下:
 # 初始化,获取token值

 def init_dc():

     global token

     url = "https://kyfw.12306.cn/otn/confirmPassenger/initDc"

     data = {

         "_json_att": ""

     }

     res = requests.post(url, headers=headers, data=data)

     result = re.findall(" var globalRepeatSubmitToken = '(.*?)';", res.text)

     # print(result)

     if len(result):

         token = result[0]

     else:

         raise Exception("Error init")
2.提交车票预订信息
其次是提交车票预订信息,在Fiddler中点击Inspectors,然后选择WebForms,可以看到如下图所示信息,其中包含了出发城市、目的城市、出发日期等:

需要注意的是secretStr这个加密字符串,其来源于查询车票时的结果,在结果中每一条车次信息中都包含了一个字符串,不过这两个字符串并不完全一样。如下图所示就是两个字符串的对比,要得到加密字符串只需要使用unquote()方法:

3.确认订单信息
在选择完车次、座位类型、乘客之后会生成一个订单,然后就会发送一个确认订单信息的请求,其中包含了很多重要的信息。这里我放上该部分的代码:
 # 确认订单信息

 def check_order_info(name, uid, mobile, type_id):

     # 商务座,一等座,二等座,软卧,硬卧,硬座

     type_str = ["9,0,1,", "M,0,1,", "O,0,1,", "4,0,1,", "3,0,1,", "1,0,1,"][type_id]

     url = "https://kyfw.12306.cn/otn/confirmPassenger/checkOrderInfo"

     data = {

         "_json_att": "",

         "bed_level_order_num": "",

         "cancel_flag": "",

         "oldPassengerStr": name + ",1," + uid + ",1_",

         "passengerTicketStr": type_str + name + ",1," + uid + "," + mobile + ",N",

         "REPEAT_SUBMIT_TOKEN": token,

         "randCode": "",

         "tour_flag": "dc",

         "whatsSelect": ""

     }

     res = requests.post(url, headers=headers, data=data)

     # print(res.text)
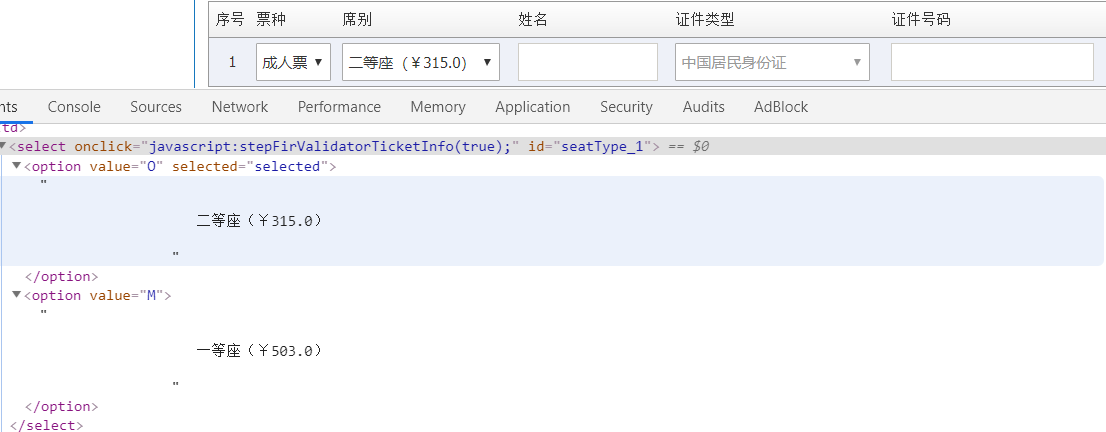
这个方法包含了四个参数,name、uid和mobile分别表示乘客的姓名、身份证号和电话号码,这三个值都是在获取乘客信息时得到的,第四个参数是座位类别id。在这个请求携带的参数中有一个REPEAT_SUBMIT_TOKEN,这就是前面说过的token,由于我已经将token设置为了全局变量,所以这里就不用作为参数传到方法里了。要注意的是每个座位类别对应的字符是不同的,我通过在页面上选择元素得到了每个座位类型对应的字符,最后生成一个列表,然后通过改变座位类别id就能完成选择座位类别的功能。
4.提交预订请求
在确认订单之后就是提交预订请求,还是在Fiddler软件中找到这个请求,然后查看其携带的参数,如下图所示:

其中包含了车次编码、出发站编码、目的站编码、token等信息,这些编码信息都可以在查询车票的结果中得到,需要注意的是train_date,可以看到这是一个日期信息,而且是一个格林威治标准时间,要得到这个时间可以使用如下方法,这就能将日期转变成格林威治标准时间:
train_date = datetime.datetime.strptime(train_date, "%Y-%m-%d").date()
this_date = train_date.strftime("%a+%b+%d+%Y")
5.检查提交状态
在提交预订请求之后,需要检查提交状态,这个请求包含了很多参数,其中一些参数的值都包含在提交预订请求的结果中,除此之外这些参数还有乘客姓名、身份证号、乘客电话、token等。这个请求返回的结果中有一个submitStatus,需要提取出来,该值表明了提交是否成功。该部分的代码如下所示:
 # 检查提交状态

 def confirm(key_check, left_ticket, passenger_name, passenger_id, passenger_mobile, location, type_id):

     # 商务座,一等座,二等座,软卧,硬卧,硬座

     type_str = ["9,0,1,", "M,0,1,", "O,0,1,", "4,0,1,", "3,0,1,", "1,0,1,"][type_id]

     url = "https://kyfw.12306.cn/otn/confirmPassenger/confirmSingleForQueue"

     data = {

         "choose_seats": "",

         "dwAll": "N",

         "key_check_isChange": key_check,

         "leftTicketStr": left_ticket,

         "oldPassengerStr": passenger_name + ",1," + passenger_id + ",1_",

         "passengerTicketStr": type_str + passenger_name + ",1," + passenger_id + "," + passenger_mobile + ",N",

         "purpose_codes": "",

         "randCode": "",

         "REPEAT_SUBMIT_TOKEN": token,

         "roomType": "",

         "seatDetailType": "",

         "train_location": location,

         "whatsSelect": "",

         "_json_att": "", }

     res = requests.post(url, headers=headers, data=data)

     try:

         js = json.loads(res.text)

         status = js["data"]["submitStatus"]

         # print(status)

         return status

     except Exception as e:

         print(e)

         raise Exception("Confirm Error!")
6.排队等待
当我们的订单提交成功之后,就需要排队等待了,此时会发送一个请求,该请求中携带了一个时间戳参数(random),如下图所示:
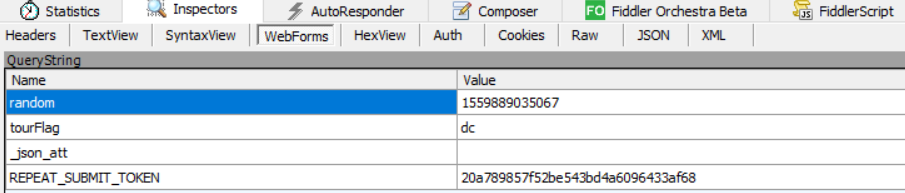
这是一个十三位的时间戳,在Python中可以使用 int(time() * 1000) 得到十三位时间戳。需要注意的是排队等待的结果是不确定的,正确的结果如下图所示:

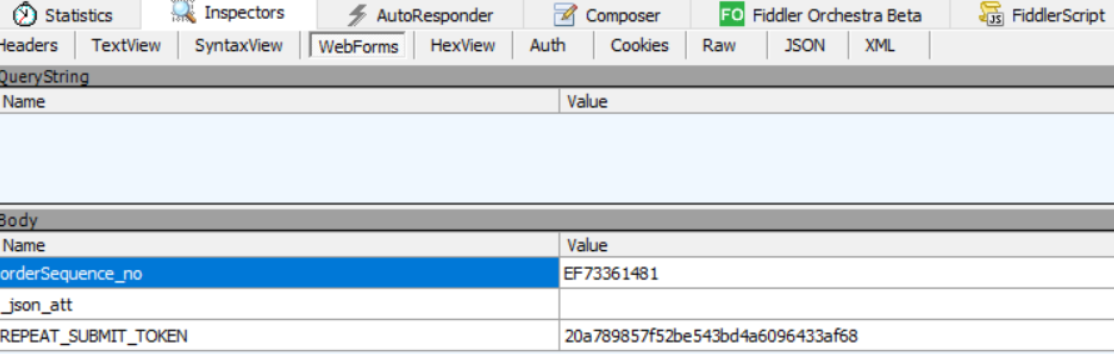
其中有一个orderId,这个值是我们需要的。如果返回的结果中不包含orderId,就需要重新发送请求。
7.请求预订结果
在得到orderId之后,就可以请求预订结果了,请求无误的话就能够成功订到票了。下图是在Fiddler软件中截到的图,其中EF73361481就是前面得到的orderId:
}801JL24.png)


五、运行结果
下图是在Pycharm中的运行截图,在登录成功之后查询余票,将查询的结果显示出来:

查询车票之后就是预订车票,需要输入车次名称、座位类别和选择乘客,然后提交订单,最终成功订到火车票。
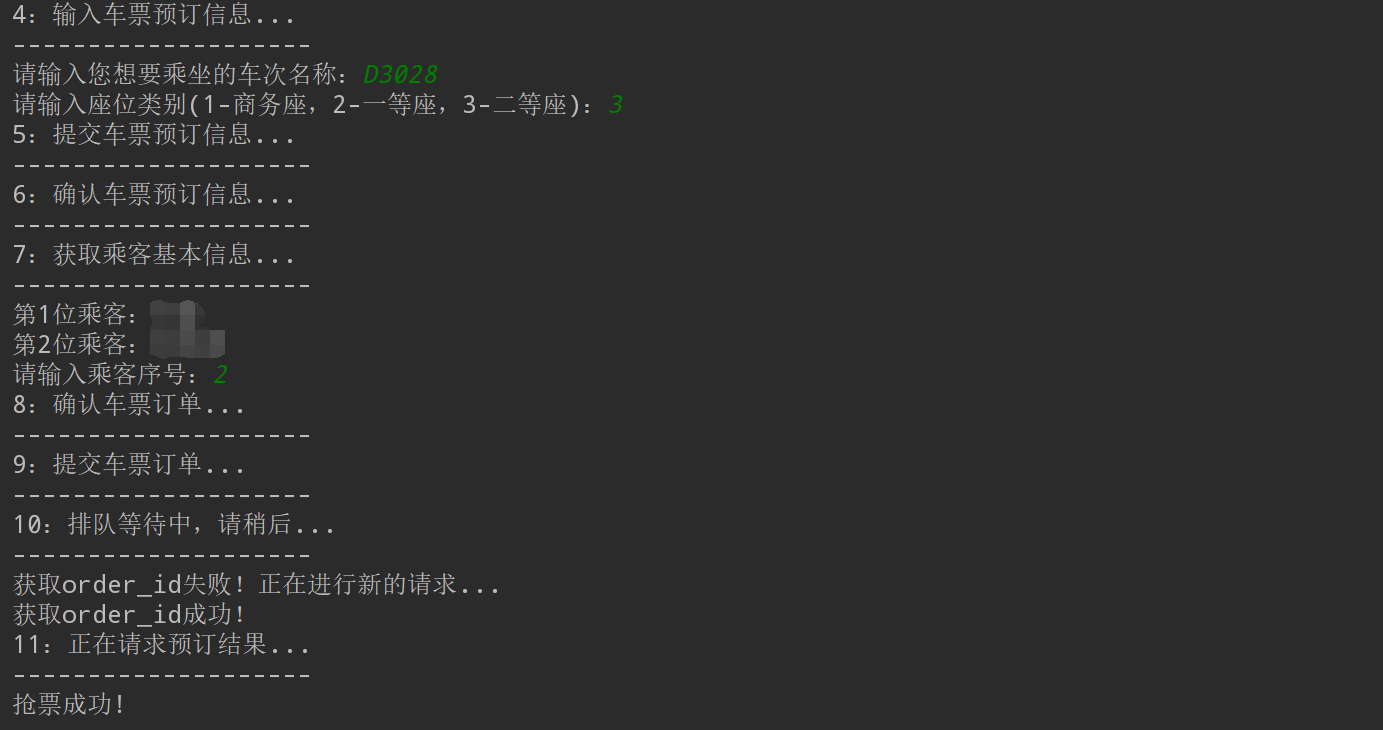
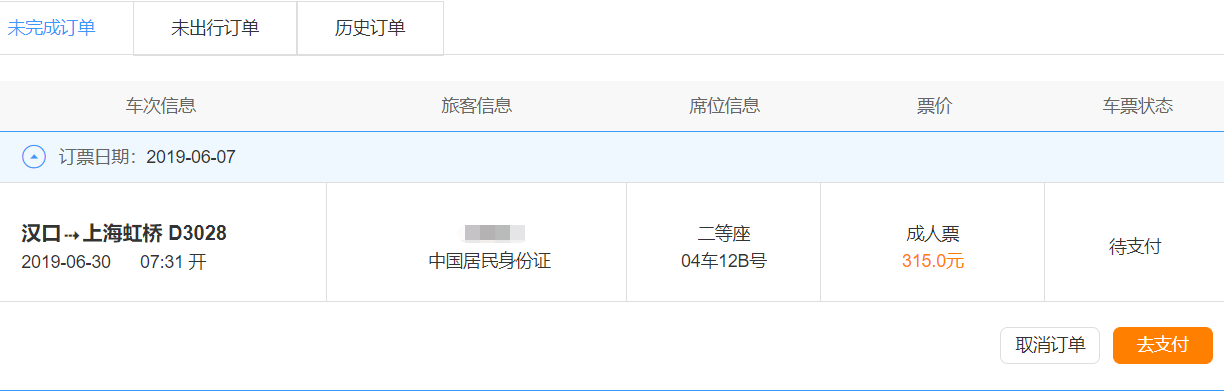
订票成功之后,进入12306网站进行查看,可以看到成功订到票了, 如下图所示:
完整代码已上传到GitHub!
【Python3爬虫】最新的12306爬虫的更多相关文章
- python3编写网络爬虫23-分布式爬虫
一.分布式爬虫 前面我们了解Scrapy爬虫框架的基本用法 这些框架都是在同一台主机运行的 爬取效率有限 如果多台主机协同爬取 爬取效率必然成倍增长这就是分布式爬虫的优势 1. 分布式爬虫基本原理 1 ...
- 利用Python实现12306爬虫--查票
在上一篇文章(http://www.cnblogs.com/fangtaoa/p/8321449.html)中,我们实现了12306爬虫的登录功能,接下来,我们就来实现查票的功能. 其实实现查票的功能 ...
- 【Python3爬虫】学习分布式爬虫第一步--Redis分布式爬虫初体验
一.写在前面 之前写的爬虫都是单机爬虫,还没有尝试过分布式爬虫,这次就是一个分布式爬虫的初体验.所谓分布式爬虫,就是要用多台电脑同时爬取数据,相比于单机爬虫,分布式爬虫的爬取速度更快,也能更好地应对I ...
- python3.7.1安装Scrapy爬虫框架
python3.7.1安装Scrapy爬虫框架 环境:win7(64位), Python3.7.1(64位) 一.安装pyhthon 详见Python环境搭建:http://www.runoob.co ...
- Python爬虫合集:花6k学习爬虫,终于知道爬虫能干嘛了
爬虫Ⅰ:爬虫的基础知识 爬虫的基础知识使用实例.应用技巧.基本知识点总结和需要注意事项 爬虫初始: 爬虫: + Request + Scrapy 数据分析+机器学习 + numpy,pandas,ma ...
- Python爬虫与数据分析之爬虫技能:urlib库、xpath选择器、正则表达式
专栏目录: Python爬虫与数据分析之python教学视频.python源码分享,python Python爬虫与数据分析之基础教程:Python的语法.字典.元组.列表 Python爬虫与数据分析 ...
- 爬虫笔记之刷小怪练级:yymp3爬虫(音乐类爬虫)
一.目标 爬取http://www.yymp3.com网站歌曲相关信息,包括歌曲名字.作者相关信息.歌曲的音频数据.歌曲的歌词数据. 二.分析 2.1 歌曲信息.歌曲音频数据下载地址的获取 随便打开一 ...
- 月薪45K的Python爬虫工程师告诉你爬虫应该怎么学,太详细了!
想用Python做爬虫,而你却还不会Python的话,那么这些入门基础知识必不可少.很多小伙伴,特别是在学校的学生,接触到爬虫之后就感觉这个好厉害的样子,我要学.但是却完全不知道从何开始,很迷茫,学的 ...
- python之爬虫(二)爬虫的原理
在上文中我们说了:爬虫就是请求网站并提取数据的自动化程序.其中请求,提取,自动化是爬虫的关键!下面我们分析爬虫的基本流程 爬虫的基本流程 发起请求通过HTTP库向目标站点发起请求,也就是发送一个Req ...
随机推荐
- Windows+Qt使用gRPC
上篇文章<Windows+VS2017使用gRPC>编译出了Windows下可用的gRPC静态lib库文件,在此基础上要想在Qt上使用,需要使用MSVC2017 64bit构建组件进行构建 ...
- maven 学习---NetBeans IDE集成Maven
NetBeans6.7更新版本已经内置对Maven支持.如遇以前的版本,Maven插件在插件管理器中可用.我们正在使用NetBeans在这个例子中使用6.9. 在NetBeans一些特点如下 您可以从 ...
- python学习2-数据库配置操作
1.创建实体类models-自定义数据库的字段与名称 class Register (models.Model): idCard=models.CharField(max_length=18) pwd ...
- Maven+SSM框架,实现单表简单的增删改查
目录 1.创建web Maven项目 2.创建java源码文件和resources资源文件 3.创建数据库配置文件:jdbc.properties 4.项目总体目录: 5.添加spring配置文件:a ...
- Python必备面试题
Python部分 1. __new__.__init__区别,如何实现单例模式,有什么优点 __new__是一个静态方法,__init__是一个实例方法 __new__返回一个创建的实例,__in ...
- 如何下载windows版的kubectl.exe文件
github上的下载链接,不能直接下载. https://github.com/kubernetes/kubernetes/blob/master/CHANGELOG-1.14.md#client-b ...
- Spring Data介绍
Spring Data是Spring 的一个子项目.用于简化数据库访问,支持NoSQL和关系数据库存储.其主要目标是使数据库的访问变得方便快捷. Spring Data 项目所支持NoSQL存储: M ...
- Dockerfile解析(八)
一.Dockerfile是什么 Dockerfile是用来构建Docker镜像的构建文件,是由一系列命令和参数构成的脚本. 1. 构建的步骤 运行容器:docker run 构建新的镜像:docker ...
- Linux SSH建立连接过程分析
https://blog.csdn.net/qwertyupoiuytr/article/details/71213463 SSH建立连接的过程主要分为下面几个阶段: SSH协议版本协商阶段.SSH目 ...
- JS判断是否是ioS或者Android
每个客户端都带有自身的UA标识,通过JavaScript,可以获取客户端标识,我们可以获取浏览器的userAgent,用正则来判断手机是ios(苹果)还是Android(安卓)客户端. 项目实例:ht ...