
.md图片链接转存并替换路径,及相关报错解决方法
最初我想把Typora中.md文件中的web图片链接都下载保存到本地,并且替换.md文本中的路径
说干就干,因为在网上没有找到现成的程序所以自己写了这个程序
思路是循环查找文件夹中的文件,然后yield返回
再用readlines()方法读取该文件,开始是采用 r 模式读取,后来遇到一些编码问题就改为 rb 模式,后面会介绍
获取文件中的数据后按行得到了一个list,再对每行进行正则匹配,匹配到图片链接就进行下载,并返回该文件名
再用正则替换该文件内容,大致就是这样
从文件夹获取文件函数
def get_files(dir):

    """

    获取一个目录下所有文件列表,包括子目录

    :param dir:

    :return:

    """

    for root, dirs, files in os.walk(dir, topdown=False):

        if 'HTML' in root or '.assets' in root:  # 文件过滤

            continue

        for file in files:

            if '.zip' in file:

                continue

            yield os.path.join(root, file)
得到文件路径进行读取, 但显示编码报错 "UnicodeDecodeError: 'gbk' codec can't decode byte 0x80 in position 48: illegal multibyte sequence"
with open(file, 'r') as f:
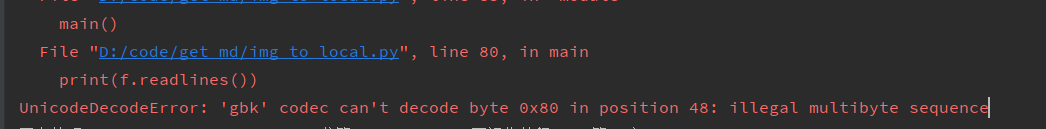
然后我试了加encoding="gbk"和utf-8编码格式都不行,最后采取rb二进制读取解决此问题
下面是对数据匹配后进行替换,代码如下
def thread_task(file, md_content):
    """
    多线程任务
    :param file:文件路径
    :param md_content:文件转为list二进制数据
    :return:
    """
    print(f'正在处理:{file}')
    for index, url in enumerate(md_content):
        if uu := re.findall(br'\((http|https://.+\.\w+)\)', url):
            print(f'下载中:{uu[0]}')
            if file_name := download_pics(uu[0].decode(), file):
                md_content[index] = re.sub(br'\((http|https://.+\.\w+)\)', f'({file_name})'.encode(), url)
    with open(file, 'wb') as f:
        f.writelines(md_content)
        f.close()
    sem.release()
代码中用到了海象运算符,所以python版本要在3.8及以上,或者自行改动一点代码就能使用
因为一个文件中有许多个图片链接,所以我采用readlines方式读取,得到一个list的二进制数据文件
在对该文件数据进行正则匹配,但是匹配时候报错 "TypeError: cannot use a string pattern on a bytes-like object"
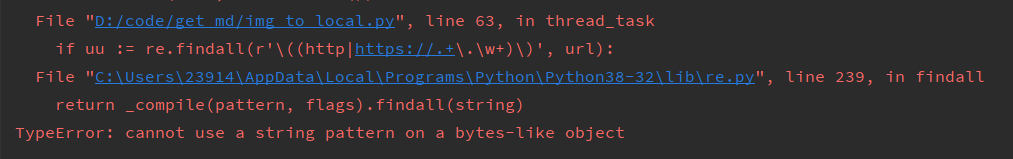
解决方法就是在正则匹配语句前加上 b 转为对二进制匹配,不加b默认是字符串匹配,参考如下
re.findall(br'\((http|https://.+\.\w+)\)', url)
下面是下载文档中图片链接的代码,源码如下
def download_pics(url, file):

    """

    下载图片

    :param url: https://matplotlib.org/_images/sphx_glr_dark_background_001.png

    :param file: D:\code\get_md\PYtext\书籍\Matplotlib 参考实例\MD\第10章 样式表.md

    :return:

    """

    try:

        img_data = requests.get(url).content

    except Exception as e:

        print(f'路径:{file} 下载出错:{e}')

        return

    filename = os.path.basename(file)  # 第10章 样式表.md

    dirname = os.path.dirname(file)  # D:\code\get_md\PYtext\书籍\Matplotlib 参考实例\MD

    targer_dir = os.path.join(dirname, f'{filename}.assets')

    if not os.path.exists(targer_dir):

        os.mkdir(targer_dir)

    with open(os.path.join(targer_dir, os.path.basename(url)), 'w+') as f:  # \Matplotlib 参考实例\MD\第10章 样式表.md.assets\dark_background_001.png

        f.buffer.write(img_data)

        f.close()

    print(url, '下载成功')

    return f'{filename}.assets/{os.path.basename(url)}'
创建文件夹下载图片保存到里面,也没啥需要多讲的 略过~
下一步进行多线程优化,代码如下
def main():
    for file in get_files(r'D:\code\get_md\PYtext\书籍'):
        with open(file, 'rb') as f:
            sem.acquire()
            Thread(target=thread_task, args=(file, f.readlines())).start()
            f.close()
            # thread_task(file, f.readlines())
下面是完整的程序源码,分享给有需要的同志
#!/usr/bin/env python
# -*- coding: UTF-8 -*-
"""
@Project :get_md
@File    :img to local.py
@IDE     :PyCharm
@Author  :Naihe
@Date    :2021/7/6 14:51
"""
import os
import re
import requests
import threading

from threading import Thread

sem = threading.Semaphore(5)  # 限制线程的最大数量

def get_files(dir):
    """
    获取一个目录下所有文件列表,包括子目录
    :param dir:
    :return:
    """
    for root, dirs, files in os.walk(dir, topdown=False):
        if 'HTML' in root or '.assets' in root:
            continue
        for file in files:
            if '.zip' in file:
                continue
            yield os.path.join(root, file)

def download_pics(url, file):
    """
    下载图片
    :param url: https://matplotlib.org/_images/sphx_glr_dark_background_001.png
    :param file: D:\code\get_md\PYtext\书籍\Matplotlib 参考实例\MD\第10章 样式表.md
    :return:
    """
    try:
        img_data = requests.get(url).content
    except Exception as e:
        print(f'路径:{file} 下载出错:{e}')
        return
    filename = os.path.basename(file)  # 第10章 样式表.md
    dirname = os.path.dirname(file)  # D:\code\get_md\PYtext\书籍\Matplotlib 参考实例\MD
    targer_dir = os.path.join(dirname, f'{filename}.assets')
    if not os.path.exists(targer_dir):
        os.mkdir(targer_dir)
    with open(os.path.join(targer_dir, os.path.basename(url)), 'w+') as f:  # \Matplotlib 参考实例\MD\第10章 样式表.md.assets\dark_background_001.png
        f.buffer.write(img_data)
        f.close()
    print(url, '下载成功')
    return f'{filename}.assets/{os.path.basename(url)}'

def thread_task(file, md_content):
    """
    多线程任务
    :param file:文件路径
    :param md_content:文件转为list二进制数据
    :return:
    """
    print(f'正在处理:{file}')
    for index, url in enumerate(md_content):
        if uu := re.findall(br'\((http|https://.+\.\w+)\)', url):
            print(f'下载中:{uu[0]}')
            if file_name := download_pics(uu[0].decode(), file):
                md_content[index] = re.sub(br'\((http|https://.+\.\w+)\)', f'({file_name})'.encode(), url)
    with open(file, 'wb') as f:
        f.writelines(md_content)
        f.close()
    sem.release()

def main():
    for file in get_files(r'D:\code\get_md\PYtext\书籍'):
        with open(file, 'rb') as f:
            sem.acquire()
            Thread(target=thread_task, args=(file, f.readlines())).start()
            f.close()
            # thread_task(file, f.readlines())

if __name__ == '__main__':
    sem = threading.Semaphore(4)  # 限制线程的最大数量为4个
    main()
码字不易,还请各位三连鼓励(^v^)
.md图片链接转存并替换路径,及相关报错解决方法的更多相关文章
- vue 动态加载图片路径报错解决方法
最近遇到图片路径加载报错的问题 之前一直都是把图片放到assets的文件下的.总是报错,看到一些文章并且尝试成功了,特意记录下 首先先说明下vue-cli的assets和static的两个文件的区别, ...
- 搭建lamp或者lnmp环境,本地链接mysql报错解决方法
报错:1130-host...is not allowed to connect to this mysql server 解决方法: 1.改表法 可能是你的账号不允许从远程登录,这个时候只要进入服务 ...
- python listdir() 中文路径 中文文件夹 乱码 解决方法
python listdir() 中文路径 中文文件夹 乱码 解决方法 listdir(path)返回的结果的编码似乎和我们提供的 path 参数的编码有关: path = 'd:/test' try ...
- pod导入融云路径报错解决办法
build Settings中搜索sear Search Patchs下点开Library Search Paths 将$(inherited)"$(SRCROOT)/Pods"分 ...
- vue-cli项目 build后请求本地static文件中的 json数据,路径不对,报错404处理方法
vue-cli 项目 build 出错点: 1,build生成dist 放在tomcat上 报错,不显示内容 解决办法: config>index.js===>assetsPublic ...
- vue项目打包后一片空白及资源引入的路径报错解决办法
网上很多说自己的VUE项目通过Webpack打包生成的list文件,放到HBulider打包后,通过手机打开一片空白.这个主要原因是路径的问题. 1.记得改一下config下面的index.js中bu ...
- TP3.2框架,实现空模块、空控制器、空操作的页面404替换||同步实现apache报错404页面替换
一,前言 一.1)以下代码是在TP3.0版本之后,URL的默认模式=>PATHINFO的前提下进行的.(通俗点,URL中index.php必须存在且正确) 代码和讲解如下: 1.空模块解决:ht ...
- vue2.0 在页面中使用process获取全局路径的时候 报错 process is not defined
如果是刚配置好的全局变量需要 重新启动一下vue才能通过proccess.env.xxx 获取到 如果想在html中使用 需要在data中声明一个变量 然后在vue生命周期中 将process.env ...
- SQL Server 2008 修改安装路径后安装出错的解决方法
1.安装时如果修改安装路径后报错 例如想把“C:\Program Files\Microsoft SQL Server” 修改为“D:\Program Files\Microsoft SQL Serv ...
随机推荐
- 关于webstorm打开HTML文件出现404错误的情况
第一种情况是你的端口号错误.你可以到设置里面找到调试器(第四个可以展开的按钮里面),找到端口号,把端口号改成8080(默认),再勾选旁边的按钮(可以接受外部链接). 你的文件命名方式不对,最好的文件名 ...
- 手写一个仿微信登录的nodejs程序
前言 首先,我们看一下微信开放文档中的一张图: 上面的一幅图中清楚地介绍了微信登录整个过程,下面对图上所示进行总结: 一.二维码的获得 用户打开登录网页后,登录网页后台根据微信OAuth2.0协议向微 ...
- 让我们用Vue cli全家桶搭建项目
一般项目都会用到这几个,这里不在详细介绍概念,只是简单的使用.一.搭建cli 1.事先安装好cnpm(淘宝镜像) npm install -g cnpm --registry=https://regi ...
- SAP 维护视图隐藏字段
PBO: MODULE reset_index. 其中ZDT_BPC002_T02 为视图名称. MODULE reset_index OUTPUT. FIELD-SYMBOLS:<fs ...
- Linux远程连接工具和运行级别
常用的Linux远程连接工具: xshell MobaXterm windows的命令行工具 Linux的运行级别 linux有七个运行级别 0----所有的服务都不开启,代表的式关机 1---代表的 ...
- JS中通过Input中id获取输入框中的值
HTML中 <input type="text" id="ONE" oninput="kpi()"> JS中 function ...
- Docker Buildx使用教程:使用Buildx构建多平台镜像
写在前边 记录一下前阵子在X86_64平台使用Docker Buildx构建多平台镜像的办法,包含但不限于构建ARM镜像. 构建环境 软件名 版本 Ubuntu 18.04.2 LTS Docker ...
- HMS Core 机器学习服务打造同传翻译新“声”态,AI让国际交流更顺畅
2022年6月,HMS Core机器学习服务面向开发者提供一项全新的开放能力--同声传译,通过AI语音技术减少资源成本,加强沟通交流,旨在帮助开发者制作丰富多样的同声传译应用. HMS Core同声传 ...
- Pytorch从0开始实现YOLO V3指南 part3——实现网络前向传播
本节翻译自:https://blog.paperspace.com/how-to-implement-a-yolo-v3-object-detector-from-scratch-in-pytorch ...
- 如何准备论文线上Presentation视频录制教程(Summary of Video Recording)
0:前言 由于国外的疫情严重,目前大多数学术会议都是线上举办,因此往往需要制作presentation的视频录制.由于各种软件横飞,有的需要会员并且不熟悉操作,特别浪费时间.因此,我将这次的操作和遇到 ...