
Hive基本命令解析
1. Hive的分区作用
命令:创建分区
create table t_sz_part(id int, name string)

partitioned by (country string)

row format delimited

fields terminated by ','
往分区中插入数据:load data local inpath '/home/hadoop/sz.dat' into table t_sz_part partition(country = 'China');
说明:首先,创建分区表的时候,需要通过关键字partitioned by (name string) 声明该表是分区表,并且是按照字段name进行分区的;其次,向分区表导入数据的时候,要通过关键字partition(country='China')显示声明数据要导入到表的哪个分区中。所谓分区,这是将满足某些条件的记录打包,做个记号,在查询时提高效率,相当于按文件夹对文件进行分类,文件夹名可类比分区字段。这个分区字段形式上存在于数据表中,在查询时会显示到客户端上,但并不真正在存储在数据表文件中,是所谓伪列。所以,千万不要以为是对属性表中真正存在的列按照属性值的异同进行分区。比如上面的分区依据的列country并不真正的存在于数据表中,是我们为了方便管理添加的一个伪列,这个列的值也是我们人为规定的,不是从数据表中读取之后根据值的不同将其分区。我们并不能按照某个数据表中真实存在的列,如id来分区。
2. Hive的分桶作用
命令:创建分桶
create table t_bluk(id string, name string)

clustered by(id) sort by (id) into 4 buckets;
解析:clustered by(id) 意思是根据id分成4个桶,并且桶内按照id排序。
上述命令执行后,将会在相应的hdfs文件目录下创建四个子目录,如:
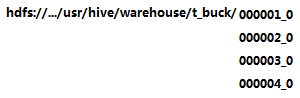
可能遇到的问题:当使用命令“insert into t_buck select * from other”时,出现t_buck目录下并没有四个子目录,只有一个子目录,需要如下操作:
① 设置如下变量:
#设置变量,设置分桶为true, 设置reduce数量是分桶的数量个数

set hive.enforce.bucketing = true;

set mapreduce.job.reduces=4;
② 使用“insert ... select ...”命令向t_buck插入数据才会最终生成四个分区。
额外说明:insert into t_buck select id,name from t_p distribute by (id) sort by (id);
distribute by (id)指定分区字段; sort by (id) 指定排序字段
当排序和分桶的字段相同的时候可以使用 distribute by (sno) sort by (sno asc) 或Cluster by(字段)。cluster by等同于分桶+排序(sort)
分区和分桶的区别:分区依据的是伪列,分桶则是相对分区进行更细粒度的划分。分桶将整个数据内容按照某列属性值的hash值进行区分,如要按照name属性分为3个桶,就是对name属性值的hash值对3取摸,按照取模结果对数据分桶。如取模结果为0的数据记录存放到一个文件,取模为1的数据存放到一个文件,取模为2的数据存放到一个文件。与分区不同的是,分区依据的不是真实数据表文件中的列,而是我们指定的伪列,但是分桶是依据数据表中真实的列而不是伪列。所以在指定分区依据的列的时候要指定列的类型,因为在数据表文件中不存在这个列,相当于新建一个列。而分桶依据的是表中已经存在的列,这个列的数据类型显然是已知的,所以不需要指定列的类型。
3. Hive的join操作解析
稍后补上
Hive基本命令解析的更多相关文章
- [Hive]HiveSQL解析原理
Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是基于Hive搭建,每天执行近万次的Hive ETL计算流程,负责每天数百GB的数据存储和分析.Hive的稳定性和 ...
- hive中解析json数组
-- hive中解析json数组 select t1.status ,substr(ss.col,,) as col ,t3.evcId ,t3.evcLicense ,t3.evcAddress , ...
- Hive部分函数解析
Hive部分函数解析 Hive里的exists ,in ,not exists ,not in 相关函数 表数据准备: 1.选择指定数据库 eg: use bg_database1; 2. 创建表 ...
- hive源代码解析之一hive主函数入口
hive其实做的就是解析一条sql然后形成到mapreduce任务,就是一个代码解释器.hive源代码本身就可以分为ql/metasotre/service/serde 这几块:其中 对于Hive来说 ...
- hive 元数据解析
在使用Hive进行开发时,我们往往需要获得一个已存在hive表的建表语句(DDL),然而hive本身并没有提供这样一个工具. 要想还原建表DDL就必须从元数据入手,我们知道,hive的元数据并不存放在 ...
- Hive Hadoop 解析 orc 文件
解析 orc 格式 为 json 格式: ./hive --orcfiledump -d <hdfs-location-of-orc-file> 把解析的 json 写入 到文件 ./hi ...
- 如何在 Apache Hive 中解析 Json 数组
我们都知道,Hive 内部提供了大量的内置函数用于处理各种类型的需求,参见官方文档:Hive Operators and User-Defined Functions (UDFs).我们从这些内置的 ...
- hive sql 解析json
在hive中会有很多数据是用json格式来存储的,而我们用数据的时候又必须要将json格式的数据解析成为正常的数据,今天我们就来聊聊hive中是如何解析json数据的. 下面这张表就是json格式的表 ...
- Hive基本命令整理
创建表: hive> CREATE TABLE pokes (foo INT, bar STRING); Creates a table called pokes with t ...
随机推荐
- Hdoj 2191.悼念512汶川大地震遇难同胞——珍惜现在,感恩生活 题解
Problem Description 急!灾区的食物依然短缺! 为了挽救灾区同胞的生命,心系灾区同胞的你准备自己采购一些粮食支援灾区,现在假设你一共有资金n元,而市场有m种大米,每种大米都是袋装产品 ...
- Graham Scan凸包算法
获得凸包的算法可以算是计算几何中最基础的算法之一了.寻找凸包的算法有很多种,Graham Scan算法是一种十分简单高效的二维凸包算法,能够在O(nlogn)的时间内找到凸包. 首先介绍一下二维向量的 ...
- css颜色表示法
css颜色值主要有三种表示方法: 1.颜色名表示,比如:red 红色,gold 金色 2.rgb表示,比如:rgb(255,0,0)表示红色 3.16进制数值表示,比如:#ff0000 表示红色,这种 ...
- hexo从零开始
部署Hexo Hexo官方文档 新建一个文件夹,比如,Blog,然后进入该文件夹下: npm install hexo-cli -g hexo version 安装依赖包 npm install 配置 ...
- CF1142C U2(计算几何,凸包)
题目大意:平面上有 $n$ 个点,第 $i$ 个点是 $(x_i,y_i)$.问有多少条抛物线(二次项系数为 $1$),经过这些点中不同的两个点,并且内部(不含边界)没有任何这些点.重合的抛物线只算一 ...
- redis执行lua文件
1.编写lua文件 还lua表示循环插入1-100的键为1-100值为1-100的键值对到redis中 for i=0,100 do redis.call("set",i,i) e ...
- SQL查询语句的进阶使用
MySQL的进阶使用 sql语句一些功能的使用 导入现有大量数据文件步骤 1) 把*.sql文件拷贝到Linux某一位置(例如Desktop) 2) Linux命令行进入该位置 cd ~/Deskto ...
- springAop 使用@Around,@After等注解时,代码运行两边的问题
springAop使用@Around,@After等注解时,代码运行两边的问题 将@Component注解删掉就好了
- oath2
最近在补架构师图谱里的内容,OAuth2.0是其中一块,抽空看了几个文章,理解了一下. 不过我感觉多数文章都不是很直观,花费了好久才理解其中的过程,以及为什么要这么设计,也许里面还有一些为什么没搞清楚 ...
- 在 Docker 中使用 mysql 的一些技巧
启动到后台: docker-compose start docker-composer 执行命令: entrypoint: pwd app: build: ./app working_dir: /a ...