
Hadoop生态圈-使用MapReduce处理HBase数据
Hadoop生态圈-使用MapReduce处理HBase数据
作者:尹正杰
版权声明:原创作品,谢绝转载!否则将追究法律责任。
一.对HBase表中数据进行单词统计(TableInputFormat)
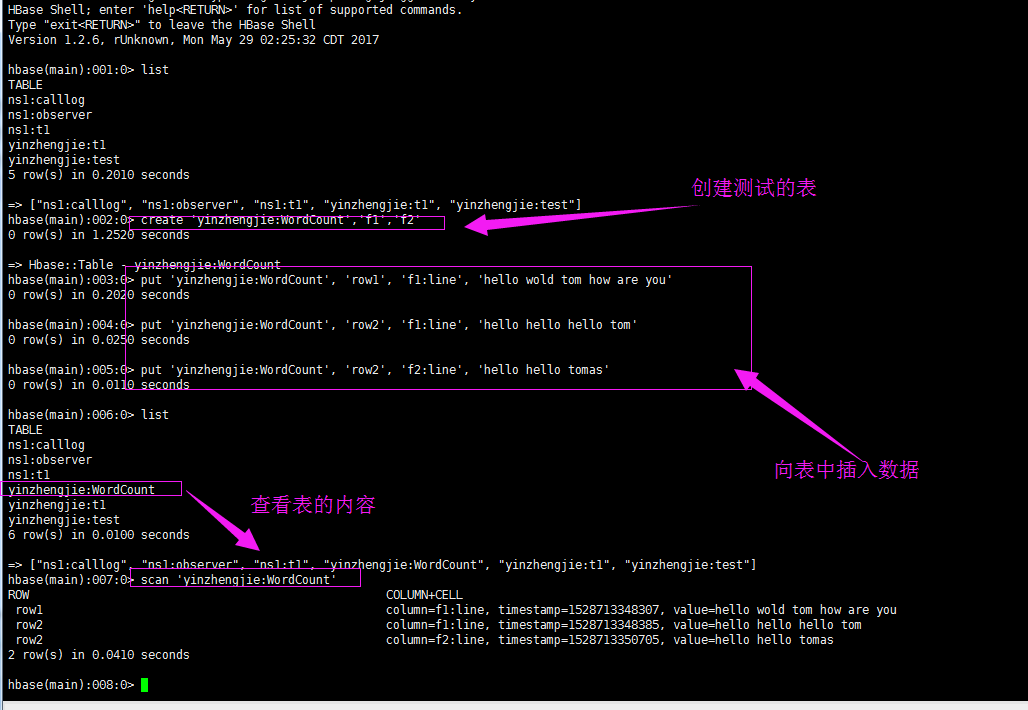
1>.准备环境
create_namespace 'yinzhengjie'

create 'yinzhengjie:WordCount','f1','f2'

put 'yinzhengjie:WordCount', 'row1', 'f1:line', 'hello wold tom how are you'

put 'yinzhengjie:WordCount', 'row2', 'f1:line', 'hello hello hello tom'

put 'yinzhengjie:WordCount', 'row2', 'f2:line', 'hello hello tomas'

scan 'yinzhengjie:WordCount'
2>.编写Map端代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E7%94%9F%E6%80%81%E5%9C%88/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.hbase.tableinput;

 import org.apache.hadoop.hbase.Cell;

 import org.apache.hadoop.hbase.CellUtil;

 import org.apache.hadoop.hbase.client.Result;

 import org.apache.hadoop.hbase.io.ImmutableBytesWritable;

 import org.apache.hadoop.hbase.util.Bytes;

 import org.apache.hadoop.io.IntWritable;

 import org.apache.hadoop.io.Text;

 import org.apache.hadoop.mapreduce.Mapper;

 import java.io.IOException;

 import java.util.List;

 /**

  * 使用hbase表做wordcount

  */

 public class TableInputMapper extends Mapper<ImmutableBytesWritable,Result, Text,IntWritable> {

     /**

      *

      * @param key           : 可以理解为HBase中的rowkey

      * @param value         :  输入端的结果集

      * @param context       : 和reduce端进行数据传输的上下文

      */

     @Override

     protected void map(ImmutableBytesWritable key, Result value, Context context) throws IOException, InterruptedException {

         //将输入端的结果集编程一个集合

         List<Cell> cells = value.listCells();

         //遍历集合,拿到每个元素的值,然后在按照空格进行切分,并将处理的结果传给reduce端

         for (Cell cell : cells) {

             String line = Bytes.toString(CellUtil.cloneValue(cell));

             String[] arr = line.split(" ");

             for(String word : arr){

                 context.write(new Text(word), new IntWritable(1));

             }

         }

     }

 }
3>.编写Reducer端代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E7%94%9F%E6%80%81%E5%9C%88/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.hbase.tableinput;

 import org.apache.hadoop.io.IntWritable;

 import org.apache.hadoop.io.Text;

 import org.apache.hadoop.mapreduce.Reducer;

 import java.io.IOException;

 public class TableInputReducer extends Reducer<Text,IntWritable,Text,IntWritable> {

     @Override

     protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {

         int sum = 0;

         for (IntWritable value : values) {

             sum += value.get();

         }

         context.write(key,new IntWritable(sum));

     }

 }
4>.编写主程序代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E7%94%9F%E6%80%81%E5%9C%88/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.hbase.tableinput;

 import org.apache.hadoop.conf.Configuration;

 import org.apache.hadoop.fs.Path;

 import org.apache.hadoop.hbase.HBaseConfiguration;

 import org.apache.hadoop.hbase.mapreduce.TableInputFormat;

 import org.apache.hadoop.io.IntWritable;

 import org.apache.hadoop.io.Text;

 import org.apache.hadoop.mapreduce.Job;

 import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

 import static org.apache.hadoop.hbase.mapreduce.TableInputFormat.INPUT_TABLE;

 import static org.apache.hadoop.hbase.mapreduce.TableInputFormat.SCAN_COLUMN_FAMILY;

 public class App {

     public static void main(String[] args) throws Exception {

         //创建一个conf对象

         Configuration conf = HBaseConfiguration.create();

         //设置输入表,即指定源数据来自HBase的那个表

         conf.set(INPUT_TABLE,"yinzhengjie:WordCount");

         //设置扫描列族

         conf.set(SCAN_COLUMN_FAMILY,"f1");

         //创建一个任务对象job,别忘记把conf传进去哟!

         Job job = Job.getInstance(conf);

         //给任务起个名字

         job.setJobName("Table WC");

         //指定main函数所在的类,也就是当前所在的类名

         job.setJarByClass(App.class);

         //设置自定义的Map程序和Reduce程序

         job.setMapperClass(TableInputMapper.class);

         job.setReducerClass(TableInputReducer.class);

         //设置输入格式

         job.setInputFormatClass(TableInputFormat.class);

         //设置输出路径

         FileOutputFormat.setOutputPath(job,new Path("file:///D:\\BigData\\yinzhengjieData\\out"));

         //设置输出k-v

         job.setOutputKeyClass(Text.class);

         job.setOutputValueClass(IntWritable.class);

         //等待任务执行结束

         job.waitForCompletion(true);

     }

 }
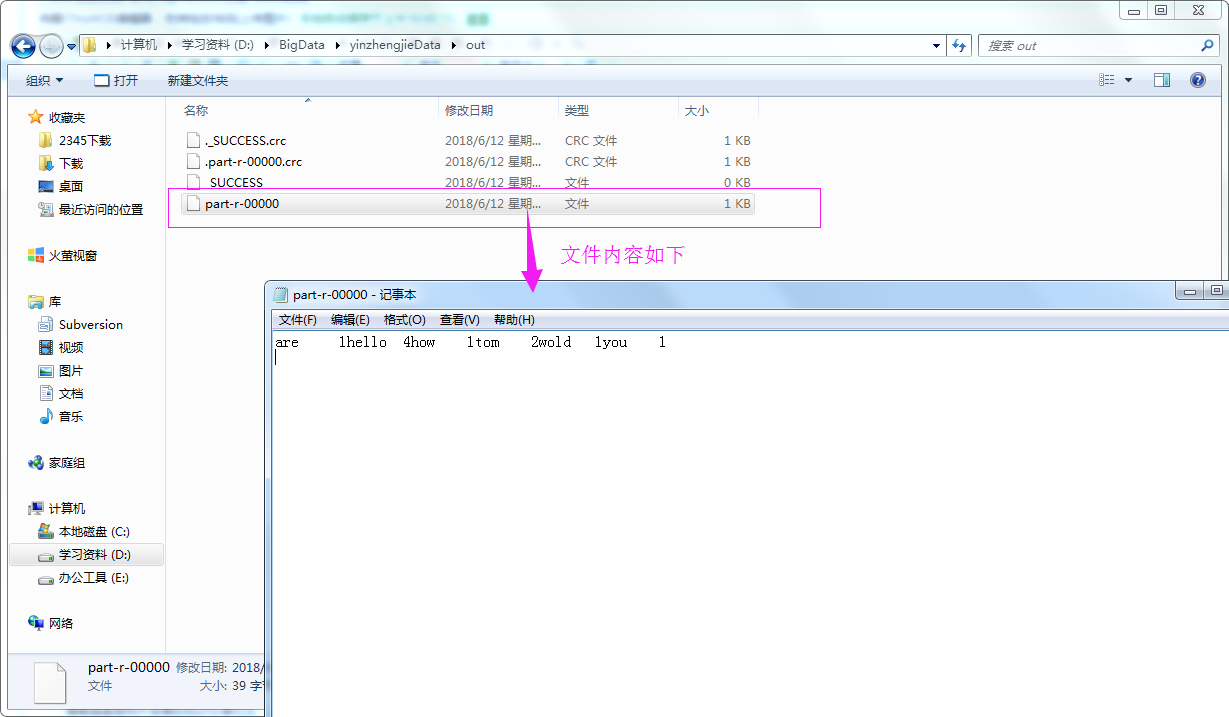
5>.查看测试结果
二.将本地文件进行单词统计的结果输出到HBase中(TableOutputFormat)
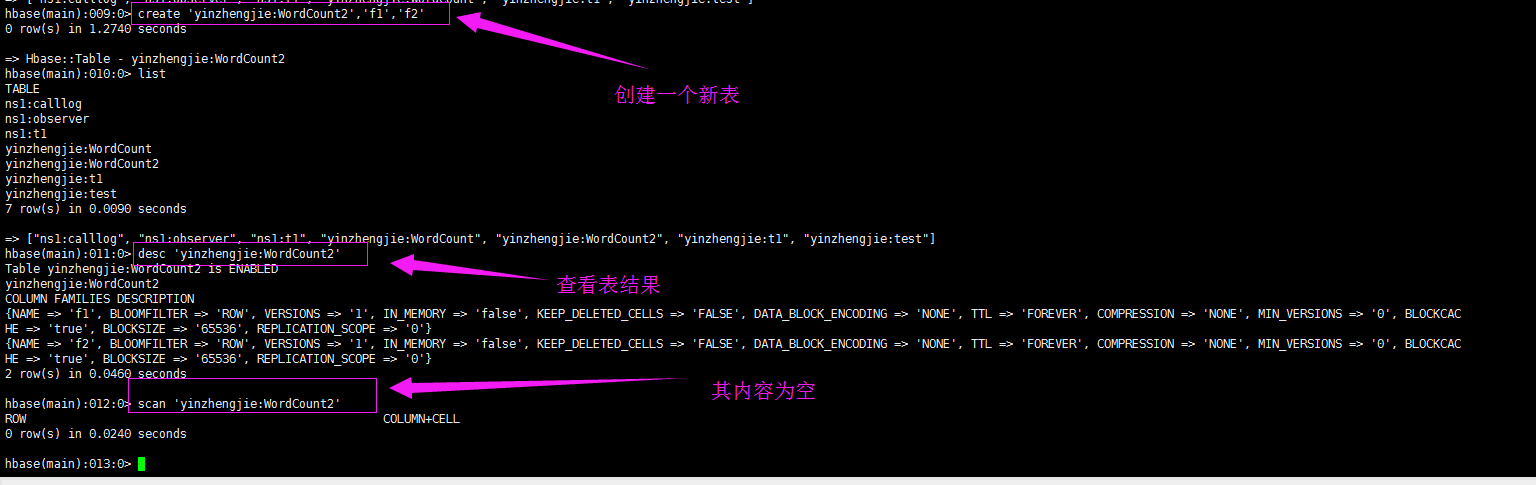
1>.准备环境
list

create 'yinzhengjie:WordCount2','f1','f2'

list

desc 'yinzhengjie:WordCount2'

scan 'yinzhengjie:WordCount2'
2>.编写Map端代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E7%94%9F%E6%80%81%E5%9C%88/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.hbase.tableoutput;

 import org.apache.hadoop.io.IntWritable;

 import org.apache.hadoop.io.LongWritable;

 import org.apache.hadoop.io.Text;

 import org.apache.hadoop.mapreduce.Mapper;

 import java.io.IOException;

 public class TableOutputMapper extends Mapper<LongWritable, Text, Text, IntWritable> {

     @Override

     protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

         //得到一行数据

         String line = value.toString();

         //按空格进行切分

         String[] arr = line.split(" ");

         //遍历切分后的数据,并将每个单词数的赋初始值为1

         for (String word : arr){

             context.write(new Text(word),new IntWritable(1));

         }

     }

 }
3>.编写Reducer端代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E7%94%9F%E6%80%81%E5%9C%88/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.hbase.tableoutput;

 import org.apache.hadoop.hbase.client.Put;

 import org.apache.hadoop.hbase.util.Bytes;

 import org.apache.hadoop.io.IntWritable;

 import org.apache.hadoop.io.NullWritable;

 import org.apache.hadoop.io.Text;

 import org.apache.hadoop.mapreduce.Reducer;

 import java.io.IOException;

 public class TableOutputReducer extends Reducer<Text,IntWritable,NullWritable,Put> {

     @Override

     protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {

         //对同一个key的出现的次数进行相加操作,算出一个单词出现的次数

         int sum = 0;

         for (IntWritable value : values) {

             sum += value.get();

         }

         /**

          *      注意,“key.toString().length() > 0”的目的是排除空串,所谓空转就是两个连续的空格链接在一起,

          * 比如“hello  world”,有两个空格,如果以空格切分的话,由于有两个空格,因此hello和world之间会被切割

          * 两次,这也就意味着会出现三个对象,即"hello","","world"。由于这个空串("")的长度为0,因此,如果我

          * 们指向统计单词的个数,只需要让长度大于0,就可以轻松过滤出“hello”和“world”两个参数啦!

          */

         if(key.toString().length() > 0){

             Put put = new Put(Bytes.toBytes(key.toString()));

             //添加每列的数据

             put.addColumn(Bytes.toBytes("f1"),Bytes.toBytes("count"),Bytes.toBytes(sum+""));

             context.write(NullWritable.get(),put);

         }

     }

 }
4>.编写主程序代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E7%94%9F%E6%80%81%E5%9C%88/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.hbase.tableoutput;

 import org.apache.hadoop.conf.Configuration;

 import org.apache.hadoop.fs.Path;

 import org.apache.hadoop.hbase.HBaseConfiguration;

 import org.apache.hadoop.hbase.client.Put;

 import org.apache.hadoop.hbase.mapreduce.TableOutputFormat;

 import org.apache.hadoop.io.IntWritable;

 import org.apache.hadoop.io.NullWritable;

 import org.apache.hadoop.io.Text;

 import org.apache.hadoop.mapreduce.Job;

 import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

 public class App {

     public static void main(String[] args) throws Exception {

         //创建一个conf对象

         Configuration conf = HBaseConfiguration.create();

         //设置输出表,即指定将数据存储在哪个HBase表

         conf.set(TableOutputFormat.OUTPUT_TABLE,"yinzhengjie:WordCount2");

         //创建一个任务对象job,别忘记把conf传进去哟!

         Job job = Job.getInstance(conf);

         //给任务起个名字

         job.setJobName("Table WordCount2");

         //指定main函数所在的类,也就是当前所在的类名

         job.setJarByClass(App.class);

         //设置自定义的Map程序和Reduce程序

         job.setMapperClass(TableOutputMapper.class);

         job.setReducerClass(TableOutputReducer.class);

         //设置输出格式

         job.setOutputFormatClass(TableOutputFormat.class);

         //设置输入路径

         FileInputFormat.addInputPath(job,new Path("file:///D:\\BigData\\yinzhengjieData\\word.txt"));

         //设置输出k-v

         job.setOutputKeyClass(NullWritable.class);

         job.setOutputValueClass(Put.class);

         //设置map端输出k-v

         job.setMapOutputKeyClass(Text.class);

         job.setMapOutputValueClass(IntWritable.class);

         //等待任务执行结束

         job.waitForCompletion(true);

     }

 }
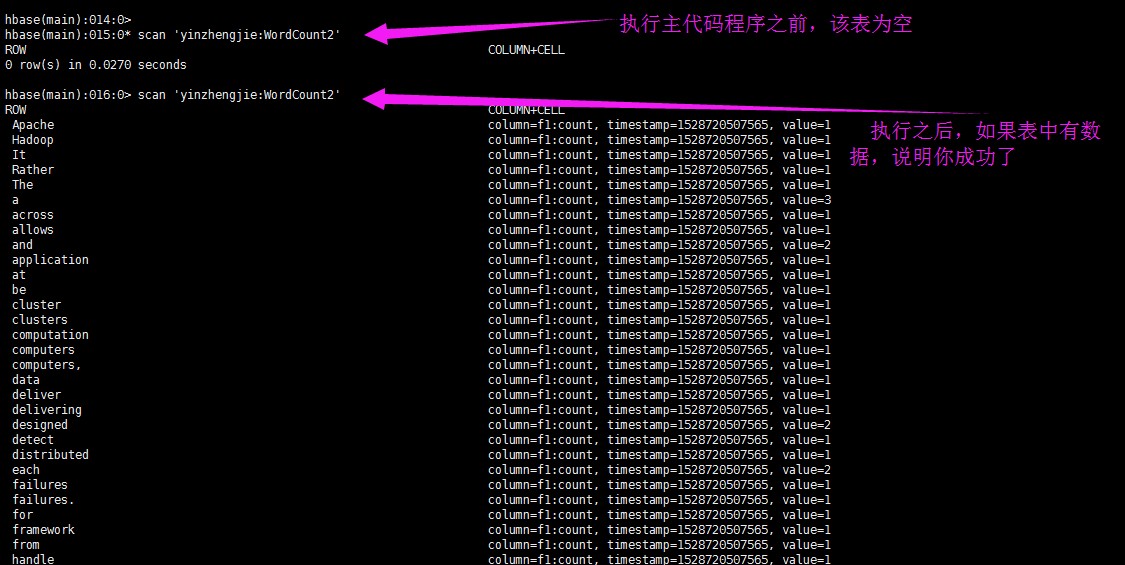
5>.查看测试结果(需要执行主代码程序)
hbase(main)::* scan 'yinzhengjie:WordCount2'

ROW                                                                  COLUMN+CELL

 row(s) in 0.0270 seconds

hbase(main)::> scan 'yinzhengjie:WordCount2'

ROW                                                                  COLUMN+CELL

 Apache                                                              column=f1:count, timestamp=, value=

 Hadoop                                                              column=f1:count, timestamp=, value=

 It                                                                  column=f1:count, timestamp=, value=

 Rather                                                              column=f1:count, timestamp=, value=

 The                                                                 column=f1:count, timestamp=, value=

 a                                                                   column=f1:count, timestamp=, value=

 across                                                              column=f1:count, timestamp=, value=

 allows                                                              column=f1:count, timestamp=, value=

 and                                                                 column=f1:count, timestamp=, value=

 application                                                         column=f1:count, timestamp=, value=

 at                                                                  column=f1:count, timestamp=, value=

 be                                                                  column=f1:count, timestamp=, value=

 cluster                                                             column=f1:count, timestamp=, value=

 clusters                                                            column=f1:count, timestamp=, value=

 computation                                                         column=f1:count, timestamp=, value=

 computers                                                           column=f1:count, timestamp=, value=

 computers,                                                          column=f1:count, timestamp=, value=

 data                                                                column=f1:count, timestamp=, value=

 deliver                                                             column=f1:count, timestamp=, value=

 delivering                                                          column=f1:count, timestamp=, value=

 designed                                                            column=f1:count, timestamp=, value=

 detect                                                              column=f1:count, timestamp=, value=

 distributed                                                         column=f1:count, timestamp=, value=

 each                                                                column=f1:count, timestamp=, value=

 failures                                                            column=f1:count, timestamp=, value=

 failures.                                                           column=f1:count, timestamp=, value=

 for                                                                 column=f1:count, timestamp=, value=

 framework                                                           column=f1:count, timestamp=, value=

 from                                                                column=f1:count, timestamp=, value=

 handle                                                              column=f1:count, timestamp=, value=

 hardware                                                            column=f1:count, timestamp=, value=

 high-availability,                                                  column=f1:count, timestamp=, value=

 highly-available                                                    column=f1:count, timestamp=, value=

 is                                                                  column=f1:count, timestamp=, value=

 itself                                                              column=f1:count, timestamp=, value=

 large                                                               column=f1:count, timestamp=, value=

 layer,                                                              column=f1:count, timestamp=, value=

 library                                                             column=f1:count, timestamp=, value=

 local                                                               column=f1:count, timestamp=, value=

 machines,                                                           column=f1:count, timestamp=, value=

 may                                                                 column=f1:count, timestamp=, value=

 models.                                                             column=f1:count, timestamp=, value=

 of                                                                  column=f1:count, timestamp=, value=

 offering                                                            column=f1:count, timestamp=, value=

 on                                                                  column=f1:count, timestamp=, value=

 processing                                                          column=f1:count, timestamp=, value=

 programming                                                         column=f1:count, timestamp=, value=

 prone                                                               column=f1:count, timestamp=, value=

 rely                                                                column=f1:count, timestamp=, value=

 scale                                                               column=f1:count, timestamp=, value=

 servers                                                             column=f1:count, timestamp=, value=

 service                                                             column=f1:count, timestamp=, value=

 sets                                                                column=f1:count, timestamp=, value=

 simple                                                              column=f1:count, timestamp=, value=

 single                                                              column=f1:count, timestamp=, value=

 so                                                                  column=f1:count, timestamp=, value=

 software                                                            column=f1:count, timestamp=, value=

 storage.                                                            column=f1:count, timestamp=, value=

 than                                                                column=f1:count, timestamp=, value=

 that                                                                column=f1:count, timestamp=, value=

 the                                                                 column=f1:count, timestamp=, value=

 thousands                                                           column=f1:count, timestamp=, value=

 to                                                                  column=f1:count, timestamp=, value=

 top                                                                 column=f1:count, timestamp=, value=

 up                                                                  column=f1:count, timestamp=, value=

 using                                                               column=f1:count, timestamp=, value=

 which                                                               column=f1:count, timestamp=, value=

 row(s) in 0.1600 seconds

hbase(main)::>
hbase(main):016:0> scan 'yinzhengjie:WordCount2'
Hadoop生态圈-使用MapReduce处理HBase数据的更多相关文章
- Hadoop 中利用 mapreduce 读写 mysql 数据
Hadoop 中利用 mapreduce 读写 mysql 数据 有时候我们在项目中会遇到输入结果集很大,但是输出结果很小,比如一些 pv.uv 数据,然后为了实时查询的需求,或者一些 OLAP ...
- 使用MapReduce读取HBase数据存储到MySQL
Mapper读取HBase数据 package MapReduce; import org.apache.hadoop.hbase.Cell; import org.apache.hadoop.hba ...
- hadoop2的mapreduce操作hbase数据
1.从hbase中取数据,再把计算结果插入hbase中 package com.yeliang; import java.io.IOException; import org.apache.hadoo ...
- 大数据和Hadoop生态圈
大数据和Hadoop生态圈 一.前言: 非常感谢Hadoop专业解决方案群:313702010,兄弟们的大力支持,在此说一声辛苦了,经过两周的努力,已经有啦初步的成果,目前第1章 大数据和Hadoop ...
- Hadoop专业解决方案-第1章 大数据和Hadoop生态圈
一.前言: 非常感谢Hadoop专业解决方案群:313702010,兄弟们的大力支持,在此说一声辛苦了,经过两周的努力,已经有啦初步的成果,目前第1章 大数据和Hadoop生态圈小组已经翻译完成,在此 ...
- 脱离JVM? Hadoop生态圈的挣扎与演化
本文由知乎<大数据应用与实践>专栏 李呈祥授权发布,版权所有归作者,转载请联系作者! 新世纪以来,互联网及个人终端的普及,传统行业的信息化及物联网的发展等产业变化产生了大量的数据,远远超出 ...
- Hadoop生态圈介绍及入门(转)
本帖最后由 howtodown 于 2015-4-2 23:15 编辑 问题导读 1.Hadoop生态圈介绍了哪些组件,分别都是什么? 2.大数据与Hadoop是什么关系? 本章主要内容: 理解大数据 ...
- Hbase框架原理及相关的知识点理解、Hbase访问MapReduce、Hbase访问Java API、Hbase shell及Hbase性能优化总结
转自:http://blog.csdn.net/zhongwen7710/article/details/39577431 本blog的内容包含: 第一部分:Hbase框架原理理解 第二部分:Hbas ...
- 大数据技术Hadoop入门理论系列之一----hadoop生态圈介绍
Technorati 标记: hadoop,生态圈,ecosystem,yarn,spark,入门 1. hadoop 生态概况 Hadoop是一个由Apache基金会所开发的分布式系统基础架构. 用 ...
随机推荐
- Linux基础入门--04
目录结构及文件基本操作 实验介绍: 1.Linux 的文件组织目录结构. 2.相对路径和绝对路径. 3.对文件的移动.复制.重命名.编辑等操作. 一.Linux 目录结构 在讲 Linux 目录结构之 ...
- Java实验五(客户端)
一. 实验内容 1. 运行教材上TCP代码,结对进行,一人服务器,一人客户端: 2. 利用加解密代码包,编译运行代码,客户端加密,服务器解密: 3. 客户端加密明文后将密文通过 ...
- 20172329 2018-2019《Java程序设计与数据结构》课程总结
作者:lalalouye(20172329王文彬) 2018-2019年大二Java程序设计与数据结构课程总目录:第一周 第二周 第三周 第四周 第五周 第六周 第七周 第八周 第九周 实验一 实验二 ...
- spring冲刺计划
会议召开时间表 日期 时间 内容 05/09 21:00-22:00 讨论题目(未果) 05/10 21:00-21:30 确定题目(网络助手) 05/13 21:00-21:45 讨论软件页面设计 ...
- php----函数大全
字符串函数 数组函数 数学函数
- 增加ubuntu的内存——设置Swap增加内存
1.查看一下当前Swap分区的状态: $cat /proc/meminfo SwapTotal: 0 kB SwapFree: 0 kB 如果上面二项目都为0,说明没有Swap分区:如果不为0,则说明 ...
- Calculator项目的过程及感受
1.将Calculator项目传到Github上的链接地址:https://github.com/sonnypp/object-oriented/tree/master/Calculator 2.本次 ...
- Thinking in Java & 内部类
静态内部类可以直接创建对象new B.C(); 如果内部类不是静态的,那就得这样 B b = new B(); B.C c = b.new C(); //要想直接创建内部类的对象,不能按照想象的方式, ...
- 约跑APP测试
项目名:约跑APP 用户需求规格说明书URL:http://www.cnblogs.com/liquan/p/6071804.html 组长博客URL:http://www.cnblogs.com/l ...
- PAT 1054 求平均值
https://pintia.cn/problem-sets/994805260223102976/problems/994805272659214336 本题的基本要求非常简单:给定N个实数,计算它 ...