
K相邻算法
刚开始学习机器学习,先跟这《机器学习实战》学一些基本的算法
----------------------------------分割线--------------------------------------------
该算法是用来判定一个点的分类,首先先找到离该点最近的k个点,然后找出这k个点的哪种分类出现次数最多,就把该点设为那个分类
距离公式选用欧式距离公式:
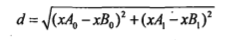
下面给出例子(来自《机器学习实战》)
1.约会对象喜欢程度的判定:
现需要一个约会对象喜欢程度的分类器
给定数据集,属性包含
每年获得的飞行常客里程数,玩视频游戏所耗时间百分比,每周消费的冰淇淋公升数,是否喜欢且喜欢程度(不喜欢,一般喜欢,特别喜欢),四个属性
分类器代码:
先获取整个数据集的约会对象个数t,然后把我们要分类的矩阵复制t次
然后减去原数据集,得到xA0-xB0和xA1-xB1,然后对矩阵每个元素平方,行内求和,开根号,得到所有点的距离
统计前k个数据类别出现次数,返回次数最多的类别
 def classify0(inX, dataSet, labels, k):
     dataSetSize = dataSet.shape[0]
     diffMat = tile(inX, (dataSetSize,1)) - dataSet
     sqDiffMat = diffMat**2
     sqDistances = sqDiffMat.sum(axis=1)
     distances = sqDistances**0.5
     sortedDistIndicies = distances.argsort()
     classCount={}
     for i in range(k):
         voteIlabel = labels[sortedDistIndicies[i]]
         classCount[voteIlabel] = classCount.get(voteIlabel,0) + 1
     sortedClassCount = sorted(classCount.iteritems(), key=operator.itemgetter(1), reverse=True)
     return sortedClassCount[0][0]
先从文件中分别读前三个属性和喜欢程度到矩阵
然后进行归一化,最后分类得到结果统计一下就好了
 def file2matrix(filename):
     fr = open(filename)
     numberOfLines = len(fr.readlines())         #get the number of lines in the file
     returnMat = zeros((numberOfLines,3))        #prepare matrix to return
     classLabelVector = []                       #prepare labels return
     fr = open(filename)
     index = 0
     for line in fr.readlines():
         line = line.strip()
         listFromLine = line.split('\t')
         returnMat[index,:] = listFromLine[0:3]
         classLabelVector.append(int(listFromLine[-1]))
         index += 1
     return returnMat,classLabelVector

 def autoNorm(dataSet):
     minVals = dataSet.min(0)
     maxVals = dataSet.max(0)
     ranges = maxVals - minVals
     normDataSet = zeros(shape(dataSet))
     m = dataSet.shape[0]
     normDataSet = dataSet - tile(minVals, (m,1))
     normDataSet = normDataSet/tile(ranges, (m,1))   #element wise divide
     return normDataSet, ranges, minVals

 def datingClassTest():
     hoRatio = 0.50      #hold out 10%
     datingDataMat,datingLabels = file2matrix('datingTestSet2.txt')       #load data setfrom file
     normMat, ranges, minVals = autoNorm(datingDataMat)
     m = normMat.shape[0]
     numTestVecs = int(m*hoRatio)
     errorCount = 0.0
     for i in range(numTestVecs):
         classifierResult = classify0(normMat[i,:],normMat[numTestVecs:m,:],datingLabels[numTestVecs:m],3)
         print "the classifier came back with: %d, the real answer is: %d" % (classifierResult, datingLabels[i])
         if (classifierResult != datingLabels[i]): errorCount += 1.0
     print "the total error rate is: %f" % (errorCount/float(numTestVecs))
     print errorCount
2.数字识别
给定训练集包含32*32的01字符串,然后判定测试集的数字
对于把32*32每个数字都看作一个属性,然后直接算距离分类...
 def img2vector(filename):
     returnVect = zeros((1,1024))
     fr = open(filename)
     for i in range(32):
         lineStr = fr.readline()
         for j in range(32):
             returnVect[0,32*i+j] = int(lineStr[j])
     return returnVect

 def handwritingClassTest():
     hwLabels = []
     trainingFileList = listdir('digits/trainingDigits')           #load the training set
     m = len(trainingFileList)
     trainingMat = zeros((m,1024))
     for i in range(m):
         fileNameStr = trainingFileList[i]
         fileStr = fileNameStr.split('.')[0]     #take off .txt
         classNumStr = int(fileStr.split('_')[0])
         hwLabels.append(classNumStr)
         trainingMat[i,:] = img2vector('digits/trainingDigits/%s' % fileNameStr)
     testFileList = listdir('digits/testDigits')        #iterate through the test set
     errorCount = 0.0
     mTest = len(testFileList)
     for i in range(mTest):
         fileNameStr = testFileList[i]
         fileStr = fileNameStr.split('.')[0]     #take off .txt
         classNumStr = int(fileStr.split('_')[0])
         vectorUnderTest = img2vector('digits/testDigits/%s' % fileNameStr)
         classifierResult = classify0(vectorUnderTest, trainingMat, hwLabels, 3)
         print "the classifier came back with: %d, the real answer is: %d" % (classifierResult, classNumStr)
         if (classifierResult != classNumStr): errorCount += 1.0
     print "\nthe total number of errors is: %d" % errorCount
     print "\nthe total error rate is: %f" % (errorCount/float(mTest))
K相邻算法的更多相关文章
- 从K近邻算法谈到KD树、SIFT+BBF算法
转自 http://blog.csdn.net/v_july_v/article/details/8203674 ,感谢july的辛勤劳动 前言 前两日,在微博上说:“到今天为止,我至少亏欠了3篇文章 ...
- 机器学习(Machine Learning)算法总结-K临近算法
一.算法详解 1.什么是K临近算法 Cover 和 Hart在1968年提出了最初的临近算法 属于分类(classification)算法 邻近算法,或者说K最近邻(kNN,k-NearestNeig ...
- 分类算法----k近邻算法
K最近邻(k-Nearest Neighbor,KNN)分类算法,是一个理论上比较成熟的方法,也是最简单的机器学习算法之一.该方法的思路是:如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的 ...
- 用Python从零开始实现K近邻算法
KNN算法的定义: KNN通过测量不同样本的特征值之间的距离进行分类.它的思路是:如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别.K通 ...
- R语言学习笔记—K近邻算法
K近邻算法(KNN)是指一个样本如果在特征空间中的K个最相邻的样本中的大多数属于某一个类别,则该样本也属于这个类别,并具有这个类别上样本的特性.即每个样本都可以用它最接近的k个邻居来代表.KNN算法适 ...
- Python3入门机器学习 - k近邻算法
邻近算法,或者说K最近邻(kNN,k-NearestNeighbor)分类算法是数据挖掘分类技术中最简单的方法之一.所谓K最近邻,就是k个最近的邻居的意思,说的是每个样本都可以用它最接近的k个邻居来代 ...
- 从K近邻算法、距离度量谈到KD树、SIFT+BBF算法
转载自:http://blog.csdn.net/v_july_v/article/details/8203674/ 从K近邻算法.距离度量谈到KD树.SIFT+BBF算法 前言 前两日,在微博上说: ...
- 一看就懂的K近邻算法(KNN),K-D树,并实现手写数字识别!
1. 什么是KNN 1.1 KNN的通俗解释 何谓K近邻算法,即K-Nearest Neighbor algorithm,简称KNN算法,单从名字来猜想,可以简单粗暴的认为是:K个最近的邻居,当K=1 ...
- 机器学习算法之K近邻算法
0x00 概述 K近邻算法是机器学习中非常重要的分类算法.可利用K近邻基于不同的特征提取方式来检测异常操作,比如使用K近邻检测Rootkit,使用K近邻检测webshell等. 0x01 原理 ...
随机推荐
- Web.py 框架学习笔记 - URL处理
最近由于工作需要开始学习基于python的web应用框架web.py.为了方便学习,将学习心得逐日记下以便日后复习. URL 模板: web.py提供了一套url处理的模板,在python工程中,只需 ...
- positio:absolute与position:relative的区别
absolute 能让元素 inline-block 化:例如一个div标签默认宽度是100%显示的,但是一旦被absolute属性缠上,则100%默认宽度就会变成自适应内部元素的宽度. float ...
- selenium chromedriver与谷歌浏览器版本映射表 (更新至v2.32)
----------ChromeDriver v2.32 (2017-08-30)---------- Supports Chrome v59-61最新的ChromeDriver 2.32 支持谷歌浏 ...
- JTemplates 的使用
注意事项:一定要放在Jquery的页面加载完成事件内 : $(function{}); <script src="~/Js/jquery-2.1.0.js">< ...
- nginx小问题
配置nginx与ftp图片服务器:安装后,要在/usr/local/nginx/conf/nginx.conf里面的server中(带有localhost的那一块)修改为location \ {roo ...
- 从Object和Function说说JS的原型链
ECMAScript规定了两个特殊的内置对象:Object和Function.他们的特殊性在于,他们本身既是对象又是函数,而他们同时也是对象和函数的构造器.这种自己生自己的逻辑显然违反人性,如果还停留 ...
- CCIE-MPLS VPN-实验手册(下卷)
10:跨域的MPLS VPN (Option A) 10.1 实验拓扑 10.1 实验需求 a. R1 R2 R3 组成P-NETWORK R1 R2 R3 位于AS 1,底层协议采用EI ...
- 201521123082《Java程序设计》第2周学习总结
201521123082<Java程序设计>第2周学习总结 标签(空格分隔): Java 1.本周学习总结 巩固了类型转换的相关细节 初步认识了类和对象,使用Java撰写程序几乎都在使用对 ...
- 201521123070 《JAVA程序设计》第4周学习总结
1. 本章学习总结 1.1 尝试使用思维导图总结有关继承的知识点. http://naotu.baidu.com/file/4de6f42e4f4f6cce0531dd9997b04e60?token ...
- 201521145048 《Java程序设计》第3周学习总结
1. 本章学习总结 学会了对于一个基本类的创建,需要有属性(private public protected),方法( 静态方法 非静态方法),构造函数,main函数,在定义属性时一般使用privat ...