
数据存入hive数据表之前对.csv(数据集)文件的预处理以及数据的上传
对于数据集文件,在将其中的数据存入hive之前,需要将数据进行预处理。
1.删除文件第一行记录,即字段名称
sed -i '1d' raw_user //1d表示删除第1行,同理,3d表示删除第3行,nd表示删除第n行
2.对字段进行预处理
主要是通过sh文件对csv文件进行字段的逐行处理,然后将处理后的数据储存在文本文档中:
下面举例sh文件的代码(sh文件需要与需要处理的csv文件放在同一目录下):
#!/bin/bash

#下面设置输入文件,把用户执行pre_deal.sh命令时提供的第一个参数作为输入文件名称

infile=$1

#下面设置输出文件,把用户执行pre_deal.sh命令时提供的第二个参数作为输出文件名称

outfile=$2

#注意!!最后的$infile > $outfile必须跟在}’这两个字符的后面

awk -F "," 'BEGIN{

        srand();

        id=0;

        Province[0]="山东";Province[1]="山西";Province[2]="河南";Province[3]="河北";Province[4]="陕西";Province[5]="内蒙古";Province[6]="上海市";

        Province[7]="北京市";Province[8]="重庆市";Province[9]="天津市";Province[10]="福建";Province[11]="广东";Province[12]="广西";Province[13]="云南";

        Province[14]="浙江";Province[15]="贵州";Province[16]="新疆";Province[17]="西藏";Province[18]="江西";Province[19]="湖南";Province[20]="湖北";

        Province[21]="黑龙江";Province[22]="吉林";Province[23]="辽宁"; Province[24]="江苏";Province[25]="甘肃";Province[26]="青海";Province[27]="四川";

        Province[28]="安徽"; Province[29]="宁夏";Province[30]="海南";Province[31]="香港";Province[32]="澳门";Province[33]="台湾";

    }

    {

        id=id+1;

        value=int(rand()*34);

        print id"\t"$1"\t"$2"\t"$3"\t"$5"\t"substr($6,1,10)"\t"Province[value]

    }' $infile > $outfile
代码讲解:
使用awk可以逐行读取输入文件,并对逐行进行相应操作。其中,-F参数用于指出每行记录的不同字段之间用什么字符进行分割,这里是用逗号进行分割。处理逻辑代码需要用两个英文单引号引起来。 $infile是输入文件的名称,我们这里会输入raw_user.csv,$outfile表示处理结束后输出的文件名称,我们后面会使用user_table.txt作为输出文件名称。
在上面的pre_deal.sh代码的处理逻辑部分,srand()用于生成随机数的种子,id是我们为数据集新增的一个字段,它是一个自增类型,每条记录增加1,这样可以保证每条记录具有唯一性。我们会为数据集新增一个省份字段,用来进行后面的数据可视化分析,为了给每条记录增加一个省份字段的值,这里,我们首先用Province[]数组用来保存全国各个省份信息,然后,在遍历数据集raw_user.csv的时候,每当遍历到其中一条记录,使用value=int(rand()*34)语句随机生成一个0-33的整数,作为Province省份值,然后从Province[]数组当中获取省份名称,增加到该条记录中。
substr($6,1,10)这个语句是为了截取时间字段time的年月日,方便后续存储为date格式。awk每次遍历到一条记录时,每条记录包含了6个字段,其中,第6个字段是时间字段,substr($6,1,10)语句就表示获取第6个字段的值,截取前10个字符,第6个字段是类似”2014-12-08 18″这样的字符串(也就是表示2014年12月8日18时),substr($6,1,10)截取后,就丢弃了小时,只保留了年月日。
另外,在print id”\t”$1″\t”$2″\t”$3″\t”$5″\t”substr($6,1,10)”\t”Province[value]这行语句中,我们丢弃了每行记录的第4个字段,所以,没有出现$4。我们生成后的文件是“\t”进行分割,这样,后续我们去查看数据的时候,效果让人看上去更舒服,每个字段在排版的时候会对齐显示,如果用逗号分隔,显示效果就比较乱。
然后用shell命令执行sh文件,参数包括输入文件名称即sh文件名称以及输出文件名称即文本文档名称。
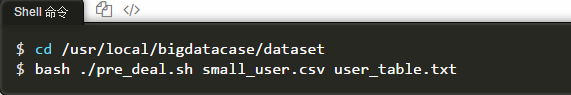
最后将新生成的user_table.txt文件上传到HDFS中,在hive中建表并通过HDFS路径上传数据。
数据存入hive数据表之前对.csv(数据集)文件的预处理以及数据的上传的更多相关文章
- c#自带压缩类实现数据库表导出到CSV压缩文件
c#自带压缩类实现数据库表导出到CSV压缩文件的方法 在导出大量CSV数据的时候,常常体积较大,采用C#自带的压缩类,可以方便的实现该功能,并且压缩比例很高,该方法在我的开源工具DataPie中已经经 ...
- 代码实现将键盘录入的数据拷贝到当前项目下的text.txt文件中,键盘录入数据当遇到quit时就退出
package com.looaderman.test; import java.io.FileNotFoundException; import java.io.FileOutputStream; ...
- c#自带压缩类实现数据库表导出到CSV压缩文件的方法
在导出大量CSV数据的时候,常常体积较大,采用C#自带的压缩类,可以方便的实现该功能,并且压缩比例很高,该方法在我的开源工具DataPie中已经经过实践检验.我的上一篇博客<功能齐全.效率一流的 ...
- Sqoop-将MySQL数据导入到hive orc表
sqoop创建并导入数据到hive orc表 sqoop import \ --connect jdbc:mysql://localhost:3306/spider \ --username root ...
- 【原创】大叔问题定位分享(16)spark写数据到hive外部表报错ClassCastException: org.apache.hadoop.hive.hbase.HiveHBaseTableOutputFormat cannot be cast to org.apache.hadoop.hive.ql.io.HiveOutputFormat
spark 2.1.1 spark在写数据到hive外部表(底层数据在hbase中)时会报错 Caused by: java.lang.ClassCastException: org.apache.h ...
- hdfs数据到hive中,以及hdfs数据隐身理解
hdfs数据到hive中: 假设hdfs中已存在好了数据,路径是hdfs:/localhost:9000/user/user_w/hive_g2park/user_center_enterprise_ ...
- 【大数据】Hive学习笔记
第1章 Hive基本概念 1.1 什么是Hive Hive:由Facebook开源用于解决海量结构化日志的数据统计. Hive是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张表, ...
- 解析xml数据存入bean映射到数据库的 需求解决过程
解析xml数据存入bean映射到数据库的 需求解决过程2017年12月19日 15:18:57 守望dfdfdf 阅读数:419 标签: xmlbean 更多个人分类: 工作 问题编辑版权声明:本文为 ...
- hive 之 将excel数据导入hive中 : excel 转 txt
一.需求: 1.客户每月上传固定格式的excel文件到指定目录.每月上传的文件名只有结尾月份不同,如: 10月文件名: zhongdiangedan202010.xlsx , 11月文件名: zh ...
随机推荐
- react native 之 Android studio
https\://services.gradle.org/distributions/gradle-4.4-all.zip 下载失败 https://blog.csdn.net/u013132758/ ...
- C语言获取当前时间
#include <stdio.h> #include <time.h> void main () { time_t rawtime; struct tm * timeinfo ...
- Excption与Error包结构。OOM你遇到过哪些情况,SOF你遇到过哪些情况
Java语言把异常当做对象来处理,并定义了一个基类(java.util.Throwable)作为所有异常的父类.异常分为Error和Exception两大类. Error 不可恢复的异常. 程序中不推 ...
- Matlab中利用null函数解齐次线性方程组
摘自:http://blog.csdn.net/masibuaa/article/details/8119032 有齐次线性方程AX=0,且rank(A)=r<n时,该方程有无穷多个解, 可以用 ...
- php str_split()函数 语法
php str_split()函数 语法 str_split()函数怎么用 php str_split()函数用于把字符串分割到数组中,语法是str_split(string,length),将字符串 ...
- 【HDOJ6595】Everything Is Generated In Equal Probability(期望DP)
题意:给定一个N,随机从[1,N]里产生一个n, 然后随机产生一个n个数的全排列,求出n的逆序数对的数量并累加ans, 然后随机地取出这个全排列中的一个子序列,重复这个过程,直到为空,求ans在模99 ...
- BZOJ 4484: [Jsoi2015]最小表示(拓扑排序+bitset)
传送门 解题思路 \(bitset\)维护连通性,给每个点开个\(bitset\),第\(i\)位为\(1\)则表示与第\(i\)位联通.算答案时显然要枚举每条边,而枚举边的顺序需要贪心,一个点先到达 ...
- HTTP的FormData和Payload的传输格式
FormData和Payload是浏览器传输给接口的两种格式,这两种方式浏览器是通过Content-Type来进行区分的(了解Content-Type),如果是 application/x-www-f ...
- NOIp 数据结构专题总结 (2):分块、树状数组、线段树
系列索引: NOIp 数据结构专题总结 (1) NOIp 数据结构专题总结 (2) 分块 阅:<「分块」数列分块入门 1-9 by hzwer> 树状数组 Binary Indexed T ...
- Win7、Win10、Linux局域网文件共享
目录 1.WIN7系统局域网文件共享 2.WIN10系统局域网文件共享 3.Linux 局域网文件共享 WIN7系统局域网文件共享 步骤一: 打开网络和共享中心----更改高级共享设置 步骤二: 选择 ...