
爬虫之scrapy工作流程
Scrapy是什么?
scrapy 是一个为了爬取网站数据,提取结构性数据而编写的应用框架,我们只需要实现少量代码,就能够快速的抓取到数据内容。Scrapy 使用了 Twisted['twɪstɪd](其主要对手是Tornado)异步网络框架来处理网络通讯,可以加快我们的下载速度,不用自己去实现异步框架,并且包含了各种中间件接口,可以灵活的完成各种需求。
异步与非阻塞的区别:异步:调用在发出之后,这个调用就直接返回,不管有无结果。
非阻塞:关注的是程序在等待调用结果(消息,返回值)时的状态,指在不能立刻得到结果之前,该调用不会阻塞当前线程。

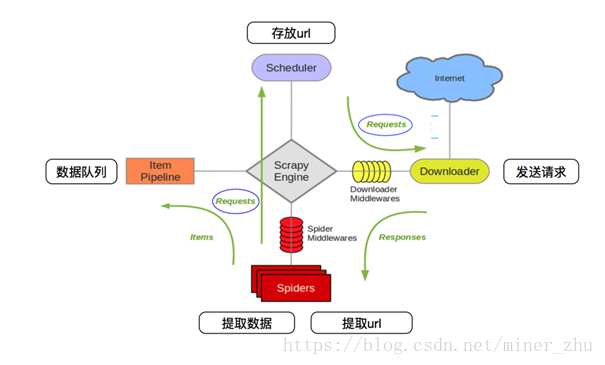
scrapy详细工作流程:
1.首先Spiders(爬虫)将需要发送请求的url(requests)经ScrapyEngine(引擎)交给Scheduler(调度器)。
2.Scheduler(排序,入队)处理后,经ScrapyEngine,DownloaderMiddlewares(可选,主要有User_Agent, Proxy代理)交给Downloader。
3.Downloader向互联网发送请求,并接收下载响应(response)。将响应(response)经ScrapyEngine,SpiderMiddlewares(可选)交给Spiders。
4.Spiders处理response,提取数据并将数据经ScrapyEngine交给ItemPipeline保存(可以是本地,可以是数据库)。
5.提取url重新经ScrapyEngine交给Scheduler进行下一个循环。直到无Url请求程序停止结束。
Scrapy主要包括了以下组件:
- 引擎(Scrapy): 用来处理整个系统的数据流处理, 触发事务(框架核心)
- 调度器(Scheduler): 用来接受引擎发过来的请求, 压入队列中, 并在引擎再次请求的时候返回. 可以想像成一个URL(抓取网页的网址或者说是链接)的优先队列, 由它来决定下一个要抓取的网址是什么, 同时去除重复的网址
- 下载器(Downloader): 用于下载网页内容, 并将网页内容返回给蜘蛛(Scrapy下载器是建立在twisted这个高效的异步模型上的)
- 爬虫(Spiders): 爬虫是主要干活的, 用于从特定的网页中提取自己需要的信息, 即所谓的实体(Item)。用户也可以从中提取出链接,让Scrapy继续抓取下一个页面
- 项目管道(Pipeline): 负责处理爬虫从网页中抽取的实体,主要的功能是持久化实体、验证实体的有效性、清除不需要的信息。当页面被爬虫解析后,将被发送到项目管道,并经过几个特定的次序处理数据。
- 下载器中间件(Downloader Middlewares): 位于Scrapy引擎和下载器之间的框架,主要是处理Scrapy引擎与下载器之间的请求及响应。
- 爬虫中间件(Spider Middlewares): 介于Scrapy引擎和爬虫之间的框架,主要工作是处理蜘蛛的响应输入和请求输出。
- 调度中间件(Scheduler Middewares): 介于Scrapy引擎和调度之间的中间件,从Scrapy引擎发送到调度的请求和响应。
爬虫之scrapy工作流程的更多相关文章
- scrapy 工作流程
Scrapy的整个数据处理流程由Scrapy引擎进行控制,其主要的运行方式为: 引擎打开一个域名,蜘蛛处理这个域名,然后获取第一个待爬取的URL. 引擎从蜘蛛那获取第一个需要爬取的URL,然后作为请求 ...
- scrapy工作流程
整个scrapy流程,我们可以用去超市取货的过程来比喻一下 两个采购员小王和小李开着采购车,来到一个大型商场采购公司月饼.到了商场之后,小李(spider)来到商场前台,找到服务台小花(引擎)并对她说 ...
- Scrapy项目结构分析和工作流程
新建的空Scrapy项目: spiders目录: 负责存放继承自scrapy的爬虫类.里面主要是用于分析response并提取返回的item或者是下一个URL信息,每个Spider负责处理特定的网站或 ...
- Linux企业级项目实践之网络爬虫(2)——网络爬虫的结构与工作流程
网络爬虫是捜索引擎抓取系统的重要组成部分.爬虫的主要目的是将互联网上的网页下载到本地形成一个或联网内容的镜像备份. 一个通用的网络爬虫的框架如图所示:
- Python 爬虫之 Scrapy 分布式原理以及部署
Scrapy分布式原理 关于Scrapy工作流程 Scrapy单机架构 上图的架构其实就是一种单机架构,只在本机维护一个爬取队列,Scheduler进行调度,而要实现多态服务器共同爬取数据关键就是共享 ...
- scrapy核心组件工作流程和post请求
一 . 五大核心组件的工作流程 引擎(Scrapy)用来处理整个系统的数据流处理, 触发事务(框架核心) 调度器(Scheduler)用来接受引擎发过来的请求, 压入队列中, 并在引擎再次请求的时候返 ...
- Scrapy中的核心工作流程以及POST请求
五大核心组件工作流程 post请求发送 递归爬取 五大核心组件工作流程 引擎(Scrapy)用来处理整个系统的数据流处理, 触发事务(框架核心) 调度器(Scheduler)用来接受引擎发过来的请求, ...
- 一篇文章教会你理解Scrapy网络爬虫框架的工作原理和数据采集过程
今天小编给大家详细的讲解一下Scrapy爬虫框架,希望对大家的学习有帮助. 1.Scrapy爬虫框架 Scrapy是一个使用Python编程语言编写的爬虫框架,任何人都可以根据自己的需求进行修改,并且 ...
- Scrapy五大核心组件工作流程
一.Scrapy五大核心组件工作流程 1.核心组件 # 引擎(Scrapy) 对整个系统的数据流进行处理, 触发事务(框架核心). # 调度器(Scheduler) 用来接受引擎发过来的请求. 由过滤 ...
随机推荐
- Nginx托管.Net Core应用程序
Nginx托管.Net Core应用程序 一.安装.Net Core 参考官方文档:https://www.microsoft.com/net/core#linuxcentos 1.添加dotnet产 ...
- 《javascript设计模式》笔记之第八章:桥接模式
个人理解:桥接模式就是更进一步地封装已有api,通过这个封装连接你的输入和底层api(初步理解,以后加深理解有不同体会之后可能要修改) 一:示例:事件监听器 下面这个示例就演示了通过一座桥(也就是一个 ...
- Linq Enumerable.Distinct方法去重
Enumerable.Distinct 方法 是常用的LINQ扩展方法,属于System.Linq的Enumerable方法,可用于去除数组.集合中的重复元素,还可以自定义去重的规则. 有两个重载方法 ...
- 执行ng build --prod --aot命令报错
D:\git\**\src\main\iui>ng build --prod --aotHash: 257ab60feca43633b6f7Time: 25358mschunk {0} poly ...
- SQL函数TIMEDIFF在Java程序中使用报错的问题分析
需求背景 (读者可略过)司机每天从早到晚都会去到不同的自动售货机上补货,而且补货次数和路线等也是因人而异,补货依据是由系统优化并指派.但是目前系统还无法实施有效指挥和优良的补货策略,司机的补货活动因此 ...
- SlickEdit 18.0 版本发布 同时更新破解文件
18.0版本没有太大的惊喜 多了如下功能 Multiple Document Group Interface Repository Log Browser History Diff Support f ...
- Linux 系统挂载阿里云数据盘
适用系统:Linux(Redhat , CentOS,Debian,Ubuntu) * Linux的云服务器数据盘未做分区和格式化,可以根据以下步骤进行分区以及格式化操作. 下面的操作将会把数据盘划 ...
- javase基础-Helloword
public class HelloWorld {//创建一个类 :1.类名首字母需要大写:2.类名必须和文件名一致 public static void main(String[] ...
- BZOJ 1806: [Ioi2007]Miners 矿工配餐
ime Limit: 10 Sec Memory Limit: 64 MBSubmit: 910 Solved: 559[Submit][Status][Discuss] Description ...
- Unity中的各种寻找GameObject方法归纳
1.GameObject.Find():寻找Hierarchy面板中的activie 不为false的游戏对象: 路径如官方事例写法: public class ExampleClass : Mono ...