
爬虫技术(四)-- 简单爬虫抓取示例(附c#代码)
这是我的第一个爬虫代码。。。算是一份测试版的代码。大牛大神别喷。。。
通过给定一个初始的地址startPiont然后对网页进行捕捉,然后通过正则表达式对网址进行匹配。
List<string> todo :进行抓取的网址的集合
List<string> visited :已经访问过的网址的集合
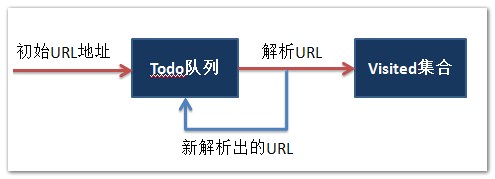
下面实现的是,给定一个初始地址,然后进行爬虫,输出正在访问的网址和已经访问的网页的个数。
需要注意的是,下面代码实现的链接匹配页面的内容如图一、图二所示:
- 图一:
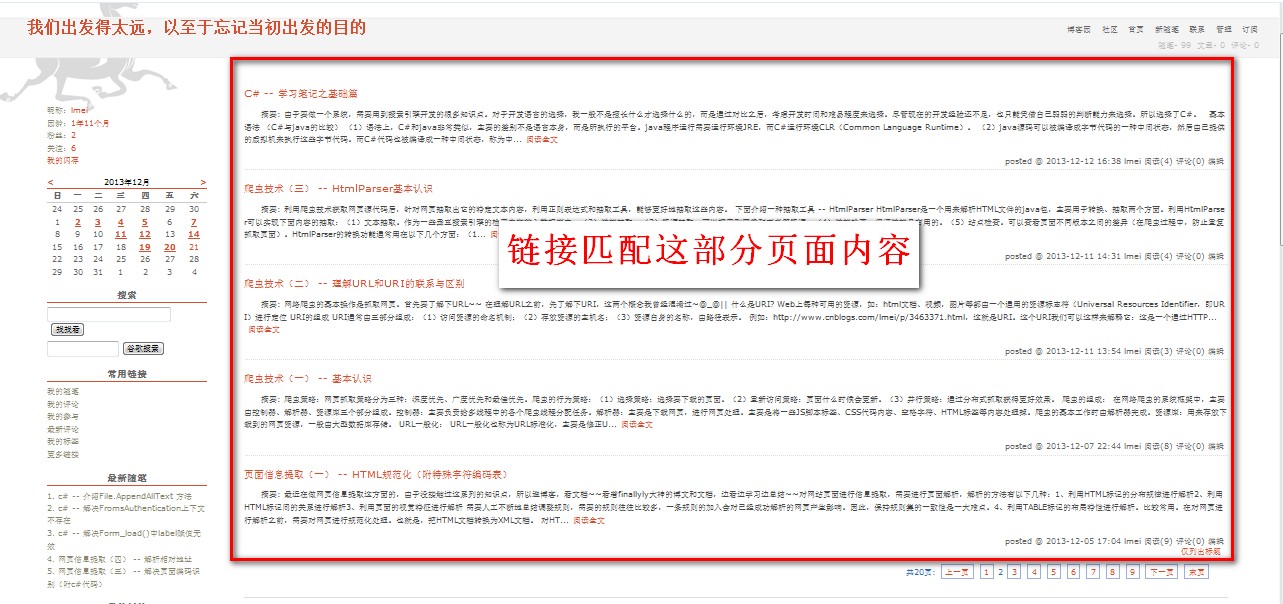
- 图二:

简单代码示范如下:(测试版)

using System;

using System.Collections.Generic;

using System.ComponentModel;

using System.Data;

using System.Drawing;

using System.Linq;

using System.Text;

using System.Windows.Forms;

using System.Web.Security;

using System.IO;

using System.Net;

using System.Text.RegularExpressions;

using System.Web;

namespace Demo1

{

    public partial class Form1 : Form

    {

        public Form1()

        {

            InitializeComponent();

         }

        private void button1_Click(object sender, EventArgs e)

        {

            Test1 a = new Test1();

            a.getCurrentURL();

        }

        public class Test1

        {

            List<string> todo = new List<string>();

            List<string> visited = new List<string>();

            string startPoint = "http://www.cnblogs.com/lmei/";


            public void getCurrentURL()

            {

                RequestSite(startPoint);

                while (todo.Count > 0)
                {

                    string currentURL = todo[0];

                    RequestSite(currentURL);

                    if (visited.Contains(currentURL))  //注释1

                    {

                        Console.WriteLine("已经访问过了" + currentURL);

                        todo.Remove((currentURL));

                    }

                    else

                    {

                        Console.WriteLine("现在正在访问:===>   " + currentURL);

                        visited.Add(currentURL);

                        Console.WriteLine("目前已经访问了:===>   " + visited.Count + "个网页" );

                        todo.Remove((currentURL));

                    }

                }

            }

            public void RequestSite(string url)

            {

                WebRequest req = WebRequest.Create(url);

                HttpWebResponse res;

                try{

                      res = (HttpWebResponse)(req.GetResponse());

                }

                catch (WebException ex) { res = (HttpWebResponse)ex.Response; }

                Stream st = res.GetResponseStream();

                StreamReader rdr = new StreamReader(st);

                string s = rdr.ReadToEnd();

                todo.AddRange(GetLink(s));

            }

            List<string> GetLink(string htmlPage)

            {

                Regex regx =

                    new Regex("http://www\\.cnblogs\\.com\\/lmei\\/p\\/[0-9a-zA-Z]+\\.html*" ,RegexOptions.IgnoreCase);

                MatchCollection matches = regx.Matches(htmlPage);

                List<string> results = new List<string>();

                foreach (Match match in matches)

                {

                    if (!visited.Contains(match.Value)) //注释2

                    {

                        results.Add(match.Value);

                    }

                }

                return results;

            }

        }

    }

}
注释1 :是将已经访问过的网址排除。
注释2 :是将已经访问过的网址排除,但是可能由于同个网页中包含的两个(或两个以上)相同的链接,而且都没被访问过的,这样使得todo队列中会有相同的网址,所以需要注释1那部分进行再次过滤排除。其实也可以将注释2那部分删去,直接让注释1过滤就行。
接下来会进一步补充爬虫抓取的内容。。。
爬虫技术(四)-- 简单爬虫抓取示例(附c#代码)的更多相关文章
- 【Python3 爬虫】01_简单页面抓取
运行平台:Winodows 10 Python版本:Python 3.4.2 IDE:Sublime text3 网络爬虫 网络爬虫,也叫网络蜘蛛(Web Spider),如果把互联网比喻成一个蜘蛛网 ...
- python爬虫构建代理ip池抓取数据库的示例代码
爬虫的小伙伴,肯定经常遇到ip被封的情况,而现在网络上的代理ip免费的已经很难找了,那么现在就用python的requests库从爬取代理ip,创建一个ip代理池,以备使用. 本代码包括ip的爬取,检 ...
- iOS—网络实用技术OC篇&网络爬虫-使用java语言抓取网络数据
网络爬虫-使用java语言抓取网络数据 前提:熟悉java语法(能看懂就行) 准备阶段:从网页中获取html代码 实战阶段:将对应的html代码使用java语言解析出来,最后保存到plist文件 上一 ...
- iOS开发——网络实用技术OC篇&网络爬虫-使用java语言抓取网络数据
网络爬虫-使用java语言抓取网络数据 前提:熟悉java语法(能看懂就行) 准备阶段:从网页中获取html代码 实战阶段:将对应的html代码使用java语言解析出来,最后保存到plist文件 上一 ...
- 爬虫学习一系列:urllib2抓取网页内容
爬虫学习一系列:urllib2抓取网页内容 所谓网页抓取,就是把URL地址中指定的网络资源从网络中读取出来,保存到本地.我们平时在浏览器中通过网址浏览网页,只不过我们看到的是解析过的页面效果,而通过程 ...
- python爬虫之分析Ajax请求抓取抓取今日头条街拍美图(七)
python爬虫之分析Ajax请求抓取抓取今日头条街拍美图 一.分析网站 1.进入浏览器,搜索今日头条,在搜索栏搜索街拍,然后选择图集这一栏. 2.按F12打开开发者工具,刷新网页,这时网页回弹到综合 ...
- Python网络爬虫(Get、Post抓取方式)
简单的抓取网页 import urllib.request url="http://google.cn/" response=urllib.request.urlopen(url) ...
- arpspoof+driftnet+ ARP欺骗简单图片抓取
arpspoof+driftnet+ ARP欺骗简单图片抓取 driftnet是一款简单而使用的图片捕获工具,可以很方便的在网络数据包中抓取图片.该工具可以实时和离线捕获指定数据包中是图片 环境 受害 ...
- [python应用]python简单图片抓取
前言 emmmm python简单图片抓取 1 import requests 2 import threading 3 import queue 4 from subprocess import P ...
- 抓取oschina上面的代码分享python块区下的 标题和对应URL
# -*- coding=utf-8 -*- import requests,re from lxml import etree import sys reload(sys) sys.setdefau ...
随机推荐
- Science:给青年科研工作者的忠告
- mysql5日期类型datetime查询范围值
1.DATE_FORMAT函数 SELECT a.create_time FROM account_log a WHERE a.create_time >= DATE_FORMAT('2014- ...
- http status 汇总
http status 汇总 常见HTTP状态码 200 OK 301 Moved Permanently 302 Found 304 Not Modified 307 Temporary Redir ...
- ZOJ2923 Calculate Roads(SPFA上的dp)
算是学了图dp后的第一次应用吧.题目其实真的是非常不严谨,什么都没说,基本靠猜,而且严格来说数据应该会有爆int的,不过不管那么多啦,思路对了就好- -0 #include<iostream&g ...
- POJ 2000
#include<iostream> #include<cstdio> #define MAXN 10009 using namespace std; ]; int main( ...
- ARM系列产品
ARM7系列 ARM9系列 ARM9E系列 ARM10E系列 SecurCore系列 Intel的StrongARM ARM11系列 Intel的Xscale 其中,ARM7.ARM9.ARM9E和A ...
- 转载——有感于三个50岁的美国程序员的生活状态与IT职业杂想
明天就是国庆节了,今天也不想干活干的太累了!写一篇以前去美国出差的杂想,对比于美国50多岁的程序员和大多数50多岁国内父母的生活状态有感而发. 前几年正好有一个项目的机会出差去了一次美国,地点是美国中 ...
- poj 2449(A*求第K短路)
题目链接:http://poj.org/problem?id=2449 思路:我们可以定义g[x]为源点到当前点的距离,h[x]为当前点到目标节点的最短距离,显然有h[x]<=h*[x](h*[ ...
- java如何追加写入txt文件
java中,对文件进行追加内容操作的三种方法 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 import java.io.BufferedWriter; import ...
- 545D. Queue
http://codeforces.com/problemset/problem/545/D 题意:n个数的服务请求数组,求在其服务时间内,最大的可满足服务的请求数量 首先对服务请求数组按照从小到大排 ...