
hadoop部署安装(三)zookeeper+yarn
1. 配置zookeeper
3.1 解压存放指定目录
[root@bogon src]# tar xf zookeeper-3.4.10.tar.gz
[root@bogon src]# mv zookeeper-3.4.10 /usr/local/zookeeper
3.2 创建zoo.cfg文件
[root@master ~]# vim /usr/local/zookeeper/conf/zoo.cfg
添加:
tickTime=2000
dataDir=/opt/zookeeper
clientPort=2181
initLimit=5
syncLimit=2
server.1=master:2888:3888
server.2=slave1:2888:3888
server.3=slave2:2888:3888
设置三台zookeeper集群,作为投票,必须是单数,才能保证投出leader节点
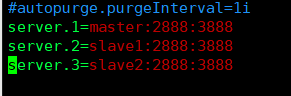
创建zoo.cfg指定的zookeepr节点的dataDir目录
[root@master ~]# mkdir /opt/zookeeper
[root@slave1 ~]# mkdir /opt/zookeeper
[root@slave2 ~]# mkdir /opt/zookeeper
3.2 配置myid
[root@master ~]# echo 1 >/opt/zookeeper/myid
[root@slave1 ~]# echo 2 >/opt/zookeeper/myid
[root@slave2 ~]# echo 3 >/opt/zookeeper/myid
设置每个zookeeper节点的id标识
3.3 拷贝zookeeper文件
[root@master ~]# scp -rp /usr/local/zookeeper/ slave1:/usr/local/
[root@master ~]# scp -rp /usr/local/zookeeper slave2:/usr/local/
将zookeeper文件拷贝到其他两个zookeeper节点上
3.4 配置各台zookeeper节点的环境变量
[root@master ~]# vim /etc/profile
修改:
#zookeeper
export PATH=$PATH:/usr/local/zookeeper/bin
将zookeeper的bin目录加入到环境中去

[root@master ~]# scp -rp /etc/profile slave1:/etc/
[root@master ~]# scp -rp /etc/profile slave2:/etc/
将环境变量文件同步到其他zookeeper节点中去

[root@master ~]# source /etc/profile
[root@slave1 ~]# source /etc/profile
[root@slave2 ~]# source /etc/profile
3.5 启动zookeeper
[root@master ~]# zkServer.sh start
[root@slave1 ~]# zkServer.sh start
[root@slave2 ~]# zkServer.sh start
在三台zookeeper节点同时启动zookeeper服务,并在启动时的当前路径下产生zookeeper日志文件zookeeper.out
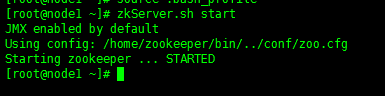
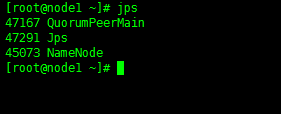
查看zookeeper进程是否存在
[root@master ~]# jps
[root@slave1 ~]# jps
[root@slave2 ~]# jps
3.6 连接内存实时库
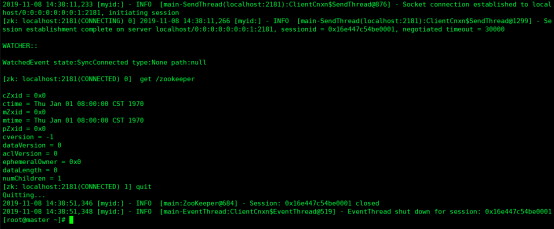
[root@master ~]# zkCli.sh
[zk: localhost:2181(CONNECTED) 2] get /zookeeper
[zk: localhost:2181(CONNECTED) 3] quit
解释:
Zookeeper正常启动会启动它的内存库,可以查看是否存在/zookeeper文件,表示zookeeper安装是否有问题
3.7 配置hadoop资源管理
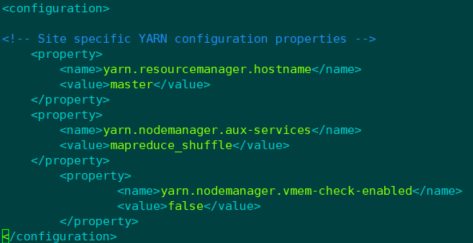
3.7.1 编辑yarn-site.xml文件
<configuration>
<property>
<name>yarn.resourcemanager.hostname</name>
<value>master</value>
</property>
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
<property>
<name>yarn.nodemanager.vmem-check-enabled</name>
<value>false</value>
</property>
</configuration>
3.7.2 创建mapperd-site.xml文件
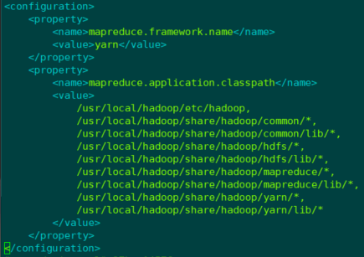
<configuration>
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
<property>
<name>mapreduce.application.classpath</name>
<value>
/usr/local/hadoop/etc/hadoop,
/usr/local/hadoop/share/hadoop/common/*,
/usr/local/hadoop/share/hadoop/common/lib/*,
/usr/local/hadoop/share/hadoop/hdfs/*,
/usr/local/hadoop/share/hadoop/hdfs/lib/*,
/usr/local/hadoop/share/hadoop/mapreduce/*,
/usr/local/hadoop/share/hadoop/mapreduce/lib/*,
/usr/local/hadoop/share/hadoop/yarn/*,
/usr/local/hadoop/share/hadoop/yarn/lib/*
</value>
</property>
</configuration>
3.7.3 同步配置文件
[root@master hadoop]# scp yarn-site.xml slave1:/usr/local/hadoop/etc/hadoop/
[root@master hadoop]# scp yarn-site.xml slave2:/usr/local/hadoop/etc/hadoop/
[root@master hadoop]# scp mapred-site.xml slave1:/usr/local/hadoop/etc/hadoop/
[root@master hadoop]# scp mapred-site.xml slave2:/usr/local/hadoop/etc/hadoop/
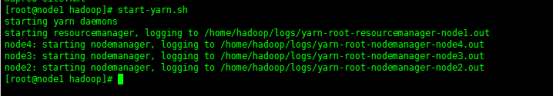
3.7.4启动yarn服务及验证
[root@master hadoop]# start-yarn.sh
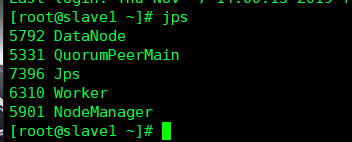
3.7.5 jps正常状态
master节点
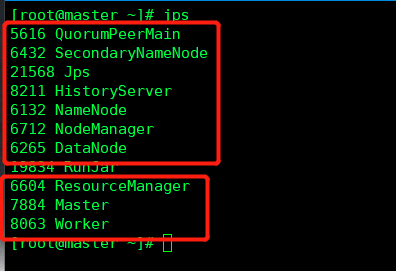
Slave节点
hadoop部署安装(三)zookeeper+yarn的更多相关文章
- kafka单机模式部署安装,zookeeper启动
在root的用户下 1):前提 安装JDK环境,设置JAVA环境变量 2):下载kafka,命令:wget http://mirrors.shuosc.org/apache/kafka/0.10.2 ...
- Hadoop 部署之 Hadoop (三)
目录 一.Hadoop 介绍 1.HDFS 介绍 2.HDFS 组成 3.MapReduce 介绍 4.MapReduce 架构 JobTracker TaskTracker 二.Hadoop的安装 ...
- hadoop 2.7.2 + zookeeper 高可用集群部署
一.环境说明 虚拟机:vmware 11 操作系统:Ubuntu 16.04 Hadoop版本:2.7.2 Zookeeper版本:3.4.9 二.节点部署说明 三.Hosts增加配置 sudo ge ...
- Apache Hadoop 2.9.2 的YARN High Available 模式部署
Apache Hadoop 2.9.2 的YARN High Available 模式部署 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.环境准备 1>.官方文档(htt ...
- Hadoop教程(五)Hadoop分布式集群部署安装
Hadoop教程(五)Hadoop分布式集群部署安装 1 Hadoop分布式集群部署安装 在hadoop2.0中通常由两个NameNode组成,一个处于active状态,还有一个处于standby状态 ...
- 基于Docker搭建大数据集群(三)Hadoop部署
主要内容 Hadoop安装 前提 zookeeper正常使用 JAVA_HOME环境变量 安装包 微云下载 | tar包目录下 Hadoop 2.7.7 角色划分 角色分配 NN DN SNN clu ...
- hadoop的安装和配置(三)完全分布式模式
博主会用三篇文章为大家详细说明hadoop的三种模式: 本地模式 伪分布模式 完全分布模式 完全分布式模式: 前面已经说了本地模式和伪分布模式,这两种在hadoop的应用中并不用于实际,因为几乎没人会 ...
- hbase、zookeeper及hadoop部署
一 机器192.168.0.203 hd203: hadoop namenode & hbase HMaster192.168.0.204 hd204: hadoop datanode &am ...
- Hadoop集群搭建-02安装配置Zookeeper
Hadoop集群搭建-05安装配置YARN Hadoop集群搭建-04安装配置HDFS Hadoop集群搭建-03编译安装hadoop Hadoop集群搭建-02安装配置Zookeeper Hado ...
- hadoop 简单安装部署
hadoop第一课:虚拟机搭建和安装hadoop及启动 hadoop第二课:hdfs集群集中管理和hadoop文件操作 hadoop第三课:java开发hdfs hadoop第四课:Yarn和Map/ ...
随机推荐
- 硬件设计:POE--POE基础
参考资料:POE供电基础知识:PSE PD检测过程详解 POE供电简介 以太网供电 一.POE相关介绍 POE(Power Over Ethernet)是指在现有的以太网Cat.5布线基础架构上不做任 ...
- Irwin-Hall 分布/CF1477F 题解
Irwin-Hall 分布 对于 \(n\) 个均匀分布于 \([0,1]\) 的连续随机变量 \(X_1,X_2,\dots,X_n\),其和的随机变量 \(X\) 满足: \[P(X\le x)= ...
- 5分钟搞定!用比扬云SD-WAN远程访问飞牛NAS全攻略
作为一个NAS重度用户,我最近遇到了一个头疼的问题:如何在外部安全地访问家里的飞牛NAS?经过一番摸索,我发现比扬云SD-WAN是个不错的解决方案,今天就来分享我的实战经验. 一.为什么选择比扬云SD ...
- 别再为文本提取抓狂!一站式文本提取神器Kreuzberg 助你解决PDF、图片、文档等多格式文件的文本提取难题
大家好,我是六哥,相信很多朋友肯定都有过从各种文档里提取文本的经历,那过程可太让人头疼了!今天就给大家分享一款超实用的现代Python库--Kreuzberg,帮你轻松解决文本提取的难题. 一.Kre ...
- oh-my-bash在git大仓库下的卡顿问题解决方案
使用oh-my-bash的同学都知道,在cd进入一些git大仓库的时候,oh-my-bash会贴心的帮你扫描一遍 然后你就卡那(nei)了... (风中凌乱.jpg) 本文告诉大家一种关闭git扫描的 ...
- Ansible 数百台批量操作前期准备工作
Ansible 数百台批量操作前期准备工作 背景: 当前有100台服务器在同一个内网,需要统一部署业务程序并且对主机修改主机名,只提供了一个文档host_user.txt,内容 " IP 用 ...
- Ansible - [05] 配置文件详解
主配置文件 ansible.cfg 修改sudo相关配置,在实际工作中,可能使用ansible时,所使用的用户并不是root用户,而是管理员给的一个普通用户,所以需要考虑ansible相关配置文件需要 ...
- Hadoop - [01] 概述
Hadoop官网:https://hadoop.apache.org/ Hadoop下载:https://archive.apache.org/dist/hadoop/common/ 一.Hadoop ...
- 他来了,为大模型量身定制的响应式编程范式(1) —— 从接入 DeepSeek 开始吧
哒哒哒,他来了! 今天我们要介绍一种新型的 Java 响应式大模型编程范式 -- FEL.你可能听说过 langchain,那么你暂且可以把 FEL 看作是 Java 版本的 langchain. 话 ...
- 在Linux系统中下载`gcc-linaro-7.2.1-2017.11-x86_64_aarch64-linux-gnu`工具链
要在Linux系统中下载gcc-linaro-7.2.1-2017.11-x86_64_aarch64-linux-gnu工具链,你可以按照以下步骤进行操作: 点击查看代码 1. **打开终端**:你 ...