
重磅发布!DeepSeek 微调秘籍揭秘,一键解锁升级版全家桶,AI 玩家必备神器!
DeepSeek V3/R1 火爆全网,基于原始模型的解决方案和 API 服务已随处可见,陷入低价和免费内卷。
如何站在巨人肩膀上,通过后训练(post-training)结合专业领域数据,低成本打造高质量私有模型,提升业务竞争力与价值?
已收获近 4 万 GitHub Star 的 Colossal-AI,发布开源大模型后训练工具箱,包含:
- DeepSeek V3/R1 满血 671B LoRA 低成本 SFT 微调
- 完整的强化学习工具链 PPO、GRPO、DPO、SimPO 等
- 无缝适配 DeepSeek 系列蒸馏模型在内的 HuggingFace 开源模型
- 兼容支持英伟达 GPU、华为昇腾 NPU 等多种硬件
- 支持混合精度训练、gradient checkpoint 等训练加速降低成本
- 灵活的训练配置接口,支持自定义奖励函数、损失函数等
- 提供灵活的并行策略配置接口,包括数据并行、模型并行、专家并行、ZeRO 和 Offload 等,以适应不同硬件规模
低成本监督微调满血版 DeepSeek V3/R1 671B
DeepSeek V3/R1 满血版参数高达 6710 亿,如何低成本进行低成本微调呢? 仅需以下几个步骤,即可快速完成。
数据集准备
该脚本接收 JSONL(JSON Lines)格式的文件作为输入数据集,例如 https://github.com/hpcaitech/ColossalAI/blob/main/applications/ColossalChat/examples/training_scripts/lora_sft_data.jsonl 数据集的每一行应为一个聊天对话列表。例如:
[{"role": "user", "content": "你好,最近怎么样?"}, {"role": "assistant", "content": "我很好。今天有什么可以帮你的吗?"}]

[{"role": "user", "content": "火烧赤壁 曹操为何不拨打119求救?"}, {"role": "assistant", "content": "因为在三国时期,还没有电话和现代的消防系统,所以曹操无法拨打119求救。"}]
该数据格式,兼容 Huggingface chat template,支持自定义 system prompt,因此可灵活按需配置。
模型权重准备
为保证更好的微调效果,使用 BF16 权重进行微调。
如果已下载了 FP8 的 DeepSeek V3/R1 权重,可以使用 DeepSeek 官方脚本(https://github.com/deepseek-ai/DeepSeek-V3/blob/main/inference/fp8_cast_bf16.py)通过 GPU 将权重转换为 BF16。
对于使用国产华为昇腾算力,可以下载 https://gitee.com/ascend/ModelZoo-PyTorch/blob/master/MindIE/LLM/DeepSeek/DeepSeek-V2/NPU_inference/fp8_cast_bf16.py 脚本转换权重。
使用方法
在准备好数据集和模型权重后,可使用 Colossal-AI 提供的一键启动脚本 https://github.com/hpcaitech/ColossalAI/blob/main/applications/ColossalChat/examples/training_scripts/lora_finetune.py
该脚本与常见 SFT 脚本类似,且完全兼容 HuggingFace PEFT,启动命令:
colossalai run --hostfile path-to-host-file --nproc_per_node 8 lora_finetune.py --pretrained path-to-DeepSeek-R1-bf16 --dataset path-to-dataset.jsonl --plugin moe --lr 2e-5 --max_length 256 -g --ep 8 --pp 3 --batch_size 24 --lora_rank 8 --lora_alpha 16 --num_epochs 2 --warmup_steps 8 --tensorboard_dir logs --save_dir DeepSeek-R1-bf16-lora
有关每个参数的更多详细信息,可以运行 python lora_finetune.py --help 查看。该脚本可通过 tensorboard 记录学习率、loss、grad norm 信息,方便对训练进行监控。
使用 LoRA 优化硬件资源消耗
通过使用 LoRA 等优化,示例命令已将 SFT DeepSeek V3/R1 671B 最低硬件要求降低近 10 倍,可使用 32 个 Ascend 910B NPU 64GB(使用 ep=8,pp=4)或 24 个 H100/H800 GPU(使用 ep=8,pp=3)。如果你通过 --zero_cpu_offload 启用 CPU offload,硬件要求可以进一步降低,但会损失一定的训练速度。
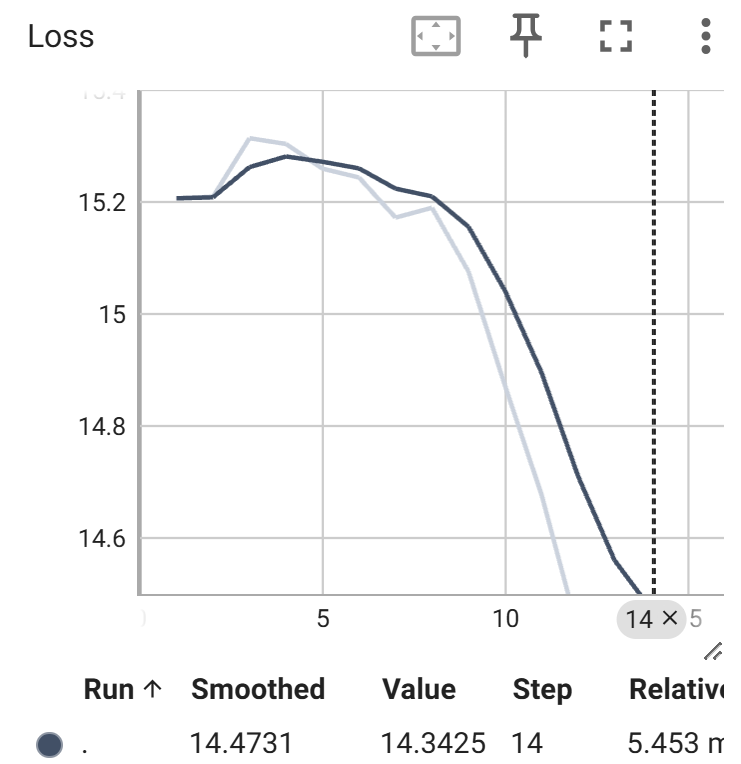
如下图验证,在 SFT DeepSeek V3/R1 671B 时,Loss 可以顺利降低。
对于资金充裕的开发团队,也可以使用上述脚本,将并行度高效扩展至数百及数千卡,快速完成 DeepSeek V3/R1 671B 全参微调或并行加速。
对于预算有限,又想借助强化学习构建自己的类 DeepSeek R1 模型,Colossal-AI 也提供了解决方案,并利用小模型对算法进行了验证。
通过强化学习微调蒸馏版 DeepSeek
Colossal-AI 团队验证并实现了 DeepSeek 论文中的 GRPO 算法及 verifiable reward,使用 Qwen2.5-3B-Base 模型进行了实验。其中,奖励的设计如下:
- 奖励 = 0,如果格式是正确的;
- 奖励 = 1, 如果格式是正确的但是结果是错误的;
- 奖励 = 10,如果格式与结果都是正确的;
Colossal-AI 团队以 Qwen2.5-3B-Base 模型为例,提供了用于验证 GRPO 的对话模板及设定(https://github.com/hpcaitech/ColossalAI/blob/main/applications/ColossalChat/conversation_template/Qwen_Qwen2.5-3B.json),通过配置以下 bash 文件,即可一键启动:
https://github.com/hpcaitech/ColossalAI/blob/main/applications/ColossalChat/examples/training_scripts/train_grpo.sh
同时,在 GRPO 章节,Colossal-AI 团队还提供了验证过程中的部分发现及各种参数的详细描述,可供参考。
代码中设计了可灵活配置奖励函数的模板,因此,用户可根据自己的具体情况设计自己的奖励函数体系。
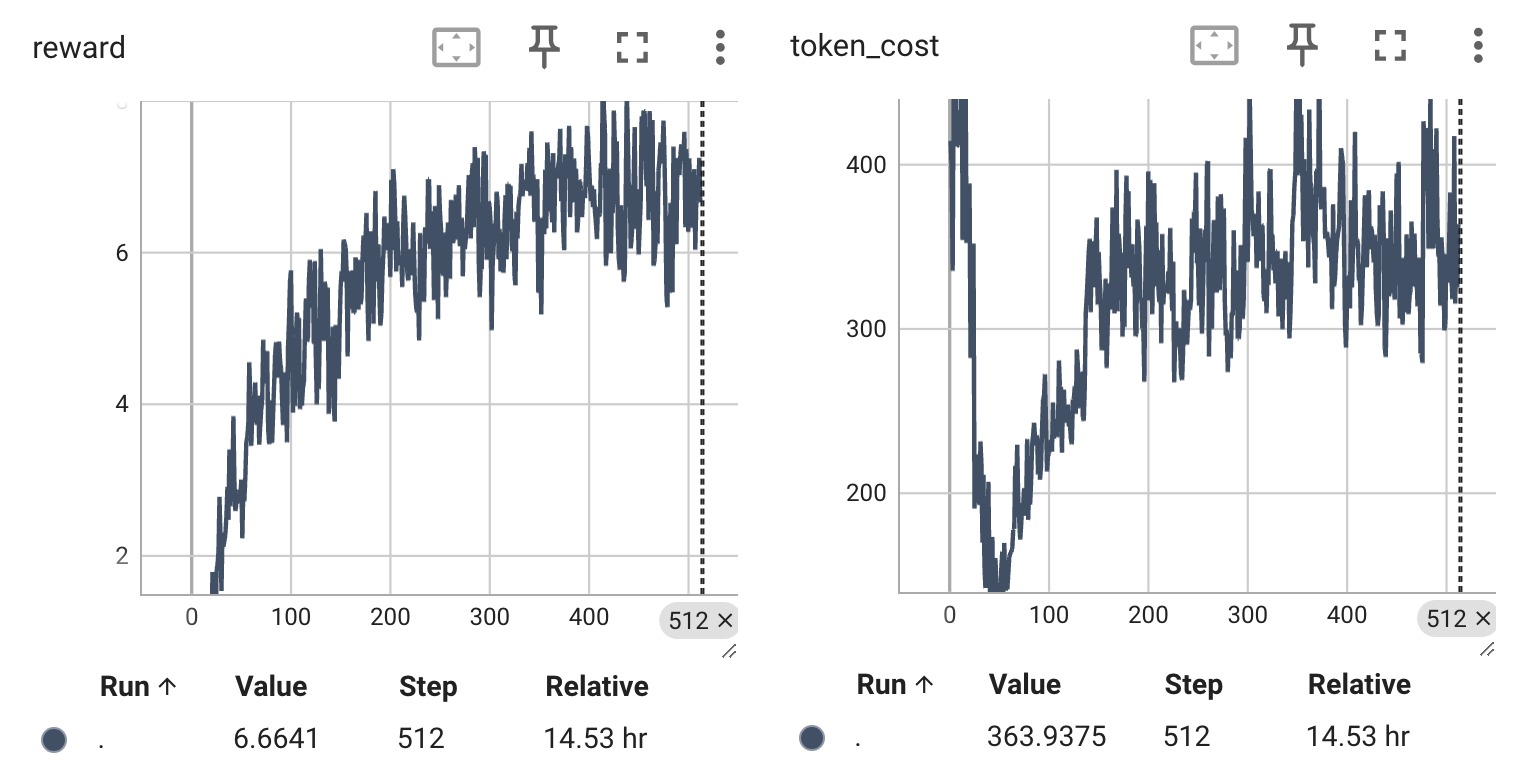
由下图可以看到,即使是 3B 的模型,平均奖励与模型回复长度随着时间逐步增长。
随着训练的进行,我们可以看到一些有意思的例子。例如随着训练迭代,模型开始了自我纠正:

Colossal-AI:最佳后训练工具箱
Colossal-AI 在深耕大模型预训练降本增效的基础上,致力于进一步成为开发者开箱即用的最佳后训练工具,帮助用户基于开源模型,低成本快速构建私有模型。
重磅发布!DeepSeek 微调秘籍揭秘,一键解锁升级版全家桶,AI 玩家必备神器!的更多相关文章
- MTSC2019大会日程重磅发布,腾讯WeTest独家Topic大揭秘!
WeTest 导读 中国移动互联网测试开发大会 Mobile Testing Summit China(简称 MTSC)是由国内最大的移动测试技术社区 TesterHome 发起的软件测试行业技术会议 ...
- 云数据库 MySQL 8.0 重磅发布,更适合企业使用场景的RDS数据库
点击订阅新品发布会! 新产品.新版本.新技术.新功能.价格调整,评论在下方,下期更新!关注更多内容,了解更多 最新发布 云数据库MySQL 8.0 升级发布会 2019年5月29日15时,阿里云云数据 ...
- 重磅发布:《阿里巴巴Android开发手册(规约)》
1.前言 阿里巴巴于近日为广大程序员再送上重磅开春好礼:<阿里巴巴Android开发手册(规约)>.该开发规范在阿里内部经过了长期的修缮,现已总结成册,向所有移动开发者.技术爱好者开放,希 ...
- 云cassandra 重磅发布dynamodb特性
云cassandra全新发布dynamodb特性 nosql主力数据库再上新台阶 9月阿里云cassandra产品发布,具体参考阿里云全球首发云Cassandra服务.迄今为止,已有上百大B客户开通了 ...
- HTC T329手机如何删除系统自带的软件?HTC一键解锁、获取ROOT权限、豌豆荚删除系统软件
手头一部HTC T329T手机,机上默认装载的软件实在太多了,居然占用了4页.用360手机卫士并不能删除系统软件(不能获取ROOT权限).查网上查询,总结要删除系统软件步骤如下(本人不刷机,只是想删除 ...
- julia,集Python、C++、R为一体!Julia 1.0重磅发布, MIT发布史上最强科学计算编程语言?创始人独家解答11个问题
这个编程语言的新版本之所以受到整个人工智能界的关注,最主要的原因正是其将 C 语言的速度.Ruby 的灵活.Python 的通用性前所未有地结合在一起,支持并行处理,易于学习和使用,尤其适合科学和工程 ...
- 【AI】【计算机】【中国人工智能学会通讯】【学会通讯2019年第01期】中国人工智能学会重磅发布 《2018 人工智能产业创新评估白皮书》
封面: 中国人工智能学会重磅发布 <2018 人工智能产业创新评估白皮书> < 2018 人工智能产业创新评估白皮书>由中国人工智能学会.国家工信安全中心.华夏幸福产业研究院. ...
- 重磅发布!阿里云推PostgreSQL 10 高可用版
摘要: 近日,阿里云重磅发布PostgreSQL 10 高可用本地SSD盘版,相比原 9.4 版本又新增了JSONB.BRIN索引.GROUPING SETS/CUBE/ROLLUP.UPSERT等多 ...
- OSS跨同城3AZ重磅发布,构造全面数据保护体系
点击订阅新品发布会! 新产品.新版本.新技术.新功能.价格调整,评论在下方,下期更新!关注更多内容,了解更多 最新发布 OSS跨同城3AZ重磅发布 2019年7月3日15时,OSS跨同城3AZ重磅发布 ...
- Dataphin公共云重磅发布,提供一站式智能数据构建与管理能
点击订阅新品发布会! 新产品.新版本.新技术.新功能.价格调整,评论在下方,下期更新!关注更多内容,了解更多 最新发布 Dataphin公共云重磅发布 2019年6月26日15时,阿里云Dataphi ...
随机推荐
- 题解:AT_abc382_c [ABC382C] Kaiten Sushi
题目传送门 思路 首先看一下数据范围. \(1 \leq N, M \leq 2 \times 10^5\) \(1 \leq A_i, B_i \leq 2 \times 10^5\) 这么大的数据 ...
- java 死锁问题排查
排查过程 1.识别死锁现象 通常,死锁会表现为应用程序挂起,不响应用户请求或 cpu 使用率下降. 2.收集线程转储 当应用出现不响应时,可以使用以下方法收集线程转储: jstack -l 进程ID ...
- Echrtas 实时渲染
1.实时曲线图 业务场景:每个时间节点产生一个数据,且时间节点间隔不固定 坐标轴配置:X轴类型设定为time,Y轴类型设定为value 数据格式:每个节点的数据都是一个数组,第一个数组为时间,第二个元 ...
- 重磅推出 Sdcb Chats:一个全新的开源大语言模型前端
重磅推出 Sdcb Chats:一个全新的开源大语言模型前端 在当前大语言模型(LLM)蓬勃发展的时代,各类 LLM 前端层出不穷.那么,为什么我们还需要另一个 LLM 前端呢? 最初的原因在于质感的 ...
- YashanDB演讲实录|别彬彬:金融科技对智能化创新系统的机遇与路径
本文为"2024国产数据库创新生态大会"深算院采石矶.钓鱼城系统技术总监别彬彬的演讲实录分享,主题为 <金融科技对智能化创新系统的机遇与路径>,欢迎阅读. 各位领导.嘉 ...
- oracle中id自增长(转)
首先,你要有一张表! CREATE TABLE example( ID Number(4) NOT NULL PRIMARY KEY, NAME VARCHAR(25), PHONE VARCHAR( ...
- 一比一还原axios源码(七)—— 取消功能
按照惯例,我们先来看下官方的例子: 你可以通过axios的CancelToken工厂函数,生成一个source,然后把这个对象作为参数传递给axios,最后,需要取消的时候调用source的cance ...
- TS 原理详细解读(6)--语法增量解析
呃....4年前开了一个坑,准备写一套完整介绍TS 原理的文章.坑很大,要慢慢填,今天就来填一个把. 本节主要介绍语法增量解析. 什么是增量解析 增量解析的意思是,如果我们直接从源码解析成语法树,叫做 ...
- 基于Three.js的大屏3D地图(一)
依赖安装 yarn add three yarn add @types/three yarn add d3-geo three库安装后在node_modules下其还包含核心three/src和插件t ...
- Qt音视频开发39-海康sdk回调拿到数据GPU绘制的实现
一.前言 采用海康的sdk做开发,最简单最容易的方式就是传入句柄(windows和linux都支持/很多人以为只有windows才支持)即可,这种方式不用自己处理绘制,全部交给了sdk去处理,所以cp ...