
Flink学习(四) Flink Table & SQL 实现wordcount Java版本
Flink Table & SQL WordCount
Flink SQL 是 Flink 实时计算为简化计算模型,降低用户使用实时计算门槛而设计的一套符合标准 SQL 语义的开发语言。
一个完整的 Flink SQL 编写的程序包括如下三部分。
Source Operator:是对外部数据源的抽象, 目前 Apache Flink 内置了很多常用的数据源实现,比如 MySQL、Kafka 等。
Transformation Operators:算子操作主要完成比如查询、聚合操作等,目前 Flink SQL 支持了 Union、Join、Projection、Difference、Intersection 及 window 等大多数传统数据库支持的操作。
Sink Operator:是对外结果表的抽象,目前 Apache Flink 也内置了很多常用的结果表的抽象,比如 Kafka Sink 等。
我们也是通过用一个最经典的 WordCount 程序作为入门,上面已经通过 DataSet/DataStream API 开发,那么实现同样的 WordCount 功能, Flink Table & SQL 核心只需要一行代码:
//省略掉初始化环境等公共代码

SELECT word, COUNT(word) FROM table GROUP BY word;
首先,整个工程中我们 pom 中的依赖如下图所示:
<dependency>

         <groupId>org.apache.flink</groupId>

         <artifactId>flink-java</artifactId>

         <version>1.10.0</version>

     </dependency>

<dependency>

         <groupId>org.apache.flink</groupId>

         <artifactId>flink-streaming-java_2.11

         <version>1.10.0</version>

</dependency>

<dependency>

         <groupId>org.apache.flink</groupId>

         <artifactId>flink-table-api-java-bridge_2.11</artifactId>

         <version>1.10.0</version>

</dependency>

<dependency>

         <groupId>org.apache.flink</groupId>

         <artifactId>flink-table-planner-blink_2.11</artifactId>

         <version>1.10.0</version>

</dependency>

<dependency>

         <groupId>org.apache.flink</groupId>

         <artifactId>flink-table-planner_2.11</artifactId>

         <version>1.10.0</version>

</dependency>

     <dependency>

         <groupId>org.apache.flink</groupId>

         <artifactId>flink-table-api-scala-bridge_2.11</artifactId>

         <version>1.10.0</version>

</dependency>
第一步,创建上下文环境:
ExecutionEnvironment fbEnv = ExecutionEnvironment.getExecutionEnvironment();

BatchTableEnvironment fbTableEnv = BatchTableEnvironment.create(fbEnv);
第二步,读取一行模拟数据作为输入:
String words = "hello flink hello lagou";

String[] split = words.split("\\W+");

ArrayList<WC> list = new ArrayList<>();

for(String word : split){

    WC wc = new WC(word,1);

    list.add(wc);

}

DataSet<WC> input = fbEnv.fromCollection(list);
第三步,注册成表,执行 SQL,然后输出:
//DataSet 转sql, 指定字段名

Table table = fbTableEnv.fromDataSet(input, "word,frequency");

table.printSchema();

//注册为一个表

fbTableEnv.createTemporaryView("WordCount", table);

Table table02 = fbTableEnv.sqlQuery("select word as word, sum(frequency) as frequency from WordCount GROUP BY word");

//将表转换DataSet

DataSet<WC> ds3  = fbTableEnv.toDataSet(table02, WC.class);

ds3.printToErr();
整体代码结构如下:
package wyh.tableApi;

import org.apache.flink.api.java.DataSet;
import org.apache.flink.api.java.ExecutionEnvironment;
import org.apache.flink.api.java.operators.DataSource;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.java.BatchTableEnvironment;

import java.util.ArrayList;

public class WCTableApi {
    public static void main(String[] args) {
        ExecutionEnvironment fbEnv = ExecutionEnvironment.getExecutionEnvironment();

        BatchTableEnvironment fbTableEnv = BatchTableEnvironment.create(fbEnv);

        String words="hello flink hello shujia";
        String[] split = words.split("\\W+");

        ArrayList<WC> list = new ArrayList<>();

        for (String word : split) {
            WC wc = new WC(word, 1L);
            list.add(wc);
        }

//        DataSet<WC> input = fbEnv.fromCollection(list);
        DataSource<WC> input = fbEnv.fromCollection(list);

        Table table = fbTableEnv.fromDataSet(input, "word,frequency");
        table.printSchema();

        fbTableEnv.createTemporaryView("wordcount",table);

        Table table1 = fbTableEnv.sqlQuery("select word,sum(frequency) as frequency from wordcount group by word");

        DataSet<WC> ds3 = fbTableEnv.toDataSet(table1, WC.class);

        try {
            ds3.printToErr();
        } catch (Exception e) {
            e.printStackTrace();
        }

    }

    public static class WC{
        public String word;
        public Long frequency;

        public WC() {
        }

        public WC(String word, Long frequency) {
            this.word = word;
            this.frequency = frequency;
        }

        @Override
        public String toString() {
            return "WC{" +
                    "word='" + word + '\'' +
                    ", frequency=" + frequency +
                    '}';
        }
    }
}
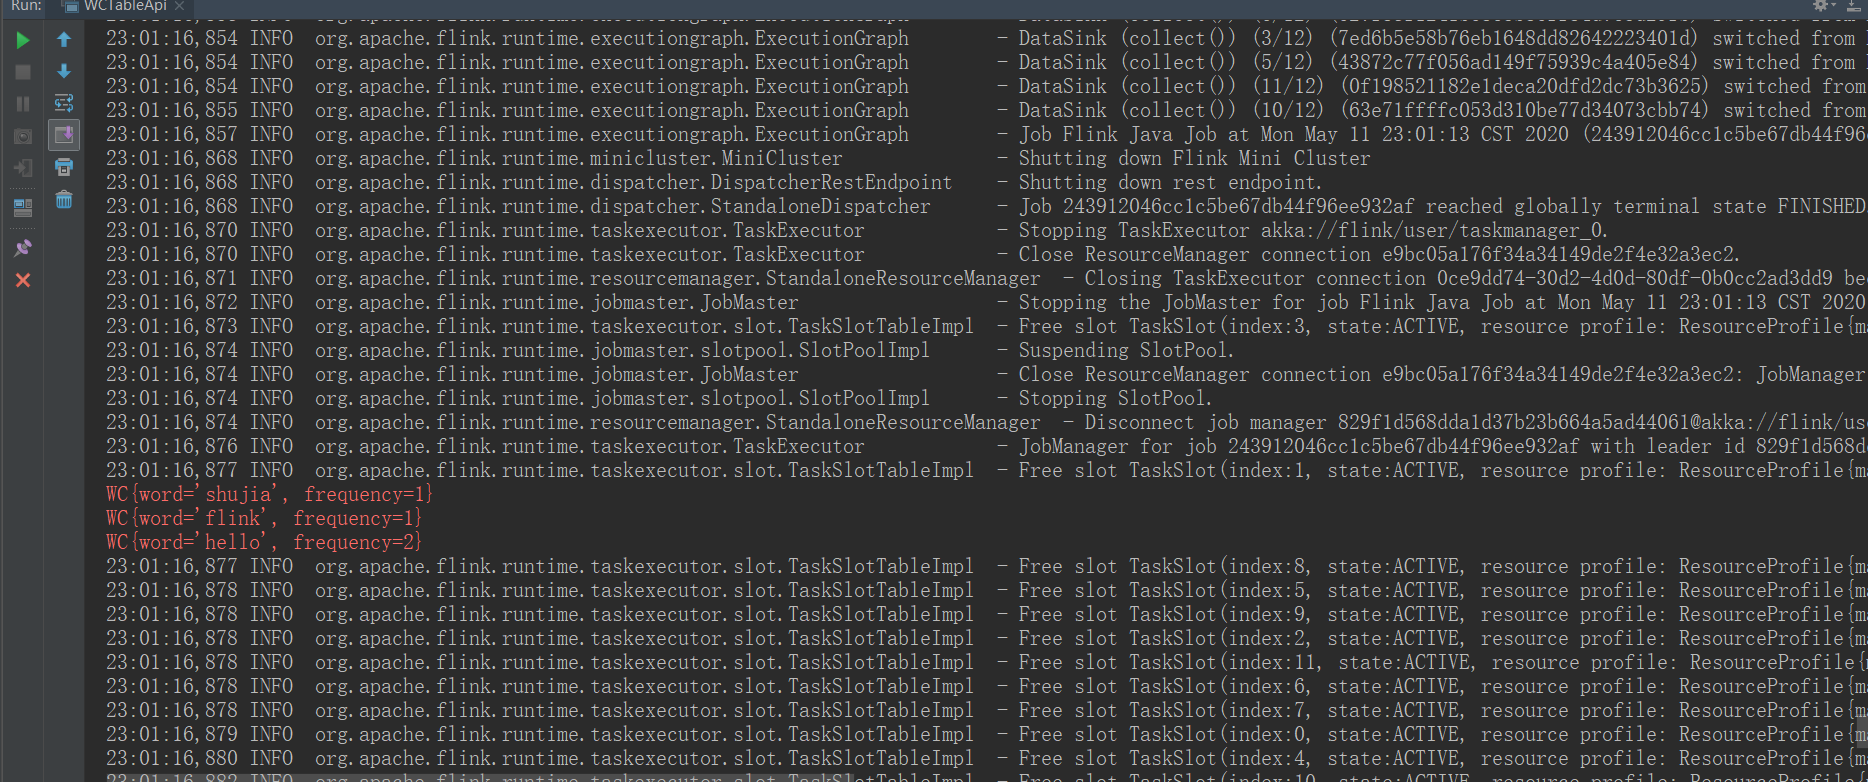
我们直接运行该程序,在控制台可以看到输出结果:
Flink学习(四) Flink Table & SQL 实现wordcount Java版本的更多相关文章
- Flink学习笔记:Flink开发环境搭建
本文为<Flink大数据项目实战>学习笔记,想通过视频系统学习Flink这个最火爆的大数据计算框架的同学,推荐学习课程: Flink大数据项目实战:http://t.cn/EJtKhaz ...
- flink学习笔记-flink实战
说明:本文为<Flink大数据项目实战>学习笔记,想通过视频系统学习Flink这个最火爆的大数据计算框架的同学,推荐学习课程: Flink大数据项目实战:http://t.cn/EJtKh ...
- Flink table&Sql中使用Calcite
Apache Calcite是什么东东 Apache Calcite面向Hadoop新的sql引擎,它提供了标准的SQL语言.多种查询优化和连接各种数据源的能力.除此之外,Calcite还提供了OLA ...
- 使用flink Table &Sql api来构建批量和流式应用(1)Table的基本概念
从flink的官方文档,我们知道flink的编程模型分为四层,sql层是最高层的api,Table api是中间层,DataStream/DataSet Api 是核心,stateful Stream ...
- 使用flink Table &Sql api来构建批量和流式应用(2)Table API概述
从flink的官方文档,我们知道flink的编程模型分为四层,sql层是最高层的api,Table api是中间层,DataStream/DataSet Api 是核心,stateful Stream ...
- 使用flink Table &Sql api来构建批量和流式应用(3)Flink Sql 使用
从flink的官方文档,我们知道flink的编程模型分为四层,sql层是最高层的api,Table api是中间层,DataStream/DataSet Api 是核心,stateful Stream ...
- flink学习笔记-快速生成Flink项目
说明:本文为<Flink大数据项目实战>学习笔记,想通过视频系统学习Flink这个最火爆的大数据计算框架的同学,推荐学习课程: Flink大数据项目实战:http://t.cn/EJtKh ...
- Flink学习笔记-新一代Flink计算引擎
说明:本文为<Flink大数据项目实战>学习笔记,想通过视频系统学习Flink这个最火爆的大数据计算框架的同学,推荐学习课程: Flink大数据项目实战:http://t.cn/EJtKh ...
- flink学习笔记-各种Time
说明:本文为<Flink大数据项目实战>学习笔记,想通过视频系统学习Flink这个最火爆的大数据计算框架的同学,推荐学习课程: Flink大数据项目实战:http://t.cn/EJtKh ...
- 《从0到1学习Flink》—— Apache Flink 介绍
前言 Flink 是一种流式计算框架,为什么我会接触到 Flink 呢?因为我目前在负责的是监控平台的告警部分,负责采集到的监控数据会直接往 kafka 里塞,然后告警这边需要从 kafka topi ...
随机推荐
- docker安装配置redis
安装redis docker pull redis 配置数据路径 mkdir -p /home/redis/data docker启动 docker run -d -v /home/redis/d ...
- Java8使用Stream实现List中对象属性的合并(去重并求和)
前言 在需求开发中,我们需要对一个List中的对象进行唯一值属性去重,属性求和,对象假设为Pool,有name.value两个属性,其中name表示唯一值,需要value进行求和,并最后保持一份对象. ...
- GraphQL Part V: 字段,参数和变量
字段 我们对字段已经有了好的起点,我们在 HelloWorldQuery 中有两个字段:hello 和 world.他们都是单值字段. 现在我们可以扩展应用来支持复杂类型.例如,我们想象一下,我们在创 ...
- Anaconda功能、优点、安装步骤(安装视频)
目录 介绍 功能(包和环境的管理器) 优点(省时省心) 下载地址 安装教程 要点 conda 的常见命令 查询完整帮助文件 管理conda和anaconda 管理环境 包管理 其他 介绍 Anac ...
- 【转载】理解分布式id生成算法SnowFlake
分布式id生成算法的有很多种,Twitter的SnowFlake就是其中经典的一种. https://segmentfault.com/a/1190000011282426 概述 SnowFlake算 ...
- mac上遇到的错误sed command a expects followed by text
上简单的替换操作 sed -i 's/apple/mac/g' full-path-file 执行后报错,"sed: 1: command a expects \ followed by t ...
- C#使用Tesseract C++ API过程记录
Tesseract Tesseract 是一个开源的光学字符识别(OCR)引擎,最初由 Hewlett-Packard(惠普)实验室开发,后来由 Google 收购并继续维护和开源贡献.Tessera ...
- 在线标定新思路!SST-Calib:最新Camera-Lidar时空同步标定算法(ITSC 2022)
在线标定新思路!SST-Calib:最新Camera-Lidar时空同步标定算法(ITSC 2022) 论文链接: 链接:https://pan.baidu.com/s/1qsfml4THs26Y7b ...
- 安装OpenCV时提示缺少boostdesc_bgm.i文件的问题解决方案
安装OpenCV时,会遇到下面的错误 /home/zhang/slam/opencv-3.4.5/opencv_contrib/modules/xfeatures2d/src/boostdesc.cp ...
- springboot的yml文件中如何配置redis?
springboot的yml文件中如何配置redis? 解决方法: spring: #redis配置 redis: database: 0 timeout: 0 # Redis服务器地址 host: ...