
Hive 学习之路(七)—— Hive 常用DML操作
一、加载文件数据到表
1.1 语法
LOAD DATA [LOCAL] INPATH 'filepath' [OVERWRITE]
INTO TABLE tablename [PARTITION (partcol1=val1, partcol2=val2 ...)]
LOCAL关键字代表从本地文件系统加载文件,省略则代表从HDFS上加载文件:从本地文件系统加载文件时,
filepath可以是绝对路径也可以是相对路径(建议使用绝对路径);从HDFS加载文件时候,
filepath为文件完整的URL地址:如hdfs://namenode:port/user/hive/project/ data1filepath可以是文件路径(在这种情况下Hive会将文件移动到表中),也可以目录路径(在这种情况下,Hive会将该目录中的所有文件移动到表中);如果使用OVERWRITE关键字,则将删除目标表(或分区)的内容,使用新的数据填充;不使用此关键字,则数据以追加的方式加入;
加载的目标可以是表或分区。如果是分区表,则必须指定加载数据的分区;
加载文件的格式必须与建表时使用
STORED AS指定的存储格式相同。
使用建议:
不论是本地路径还是URL都建议使用完整的。虽然可以使用不完整的URL地址,此时Hive将使用hadoop中的fs.default.name配置来推断地址,但是为避免不必要的错误,建议使用完整的本地路径或URL地址;
加载对象是分区表时建议显示指定分区。在Hive 3.0之后,内部将加载(LOAD)重写为INSERT AS SELECT,此时如果不指定分区,INSERT AS SELECT将假设最后一组列是分区列,如果该列不是表定义的分区,它将抛出错误。为避免错误,还是建议显示指定分区。
1.2 示例
新建分区表:
  CREATE TABLE emp_ptn(
    empno INT,
    ename STRING,
    job STRING,
    mgr INT,
    hiredate TIMESTAMP,
    sal DECIMAL(7,2),
    comm DECIMAL(7,2)
    )
    PARTITIONED BY (deptno INT)   -- 按照部门编号进行分区
    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t";
从HDFS上加载数据到分区表:
LOAD DATA INPATH "hdfs://hadoop001:8020/mydir/emp.txt" OVERWRITE INTO TABLE emp_ptn PARTITION (deptno=20);
emp.txt文件可在本仓库的resources目录中下载
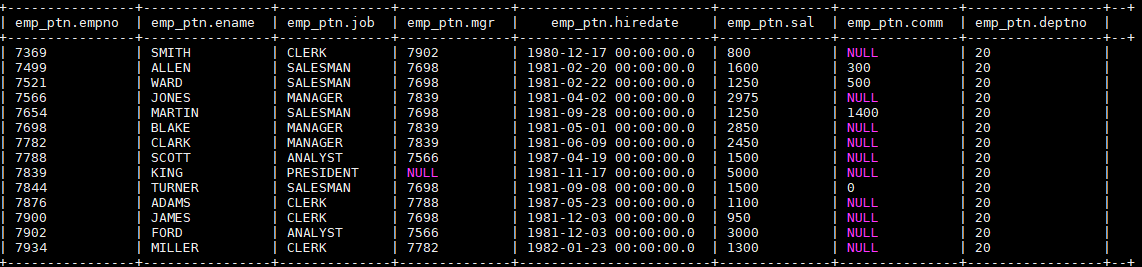
加载后表中数据如下,分区列deptno全部赋值成20:
二、查询结果插入到表
2.1 语法
INSERT OVERWRITE TABLE tablename1 [PARTITION (partcol1=val1, partcol2=val2 ...) [IF NOT EXISTS]]
select_statement1 FROM from_statement;

INSERT INTO TABLE tablename1 [PARTITION (partcol1=val1, partcol2=val2 ...)]
select_statement1 FROM from_statement;
Hive 0.13.0开始,建表时可以通过使用TBLPROPERTIES(“immutable”=“true”)来创建不可变表(immutable table) ,如果不可以变表中存在数据,则INSERT INTO失败。(注:INSERT OVERWRITE的语句不受
immutable属性的影响);可以对表或分区执行插入操作。如果表已分区,则必须通过指定所有分区列的值来指定表的特定分区;
从Hive 1.1.0开始,TABLE关键字是可选的;
从Hive 1.2.0开始 ,可以采用INSERT INTO tablename(z,x,c1)指明插入列;
可以将SELECT语句的查询结果插入多个表(或分区),称为多表插入。语法如下:
FROM from_statement
INSERT OVERWRITE TABLE tablename1
[PARTITION (partcol1=val1, partcol2=val2 ...) [IF NOT EXISTS]] select_statement1
[INSERT OVERWRITE TABLE tablename2 [PARTITION ... [IF NOT EXISTS]] select_statement2]
[INSERT INTO TABLE tablename2 [PARTITION ...] select_statement2] ...;
2.2 动态插入分区
INSERT OVERWRITE TABLE tablename PARTITION (partcol1[=val1], partcol2[=val2] ...)
select_statement FROM from_statement;

INSERT INTO TABLE tablename PARTITION (partcol1[=val1], partcol2[=val2] ...)
select_statement FROM from_statement;
在向分区表插入数据时候,分区列名是必须的,但是列值是可选的。如果给出了分区列值,我们将其称为静态分区,否则它是动态分区。动态分区列必须在SELECT语句的列中最后指定,并且与它们在PARTITION()子句中出现的顺序相同。
注意:Hive 0.9.0之前的版本动态分区插入是默认禁用的,而0.9.0之后的版本则默认启用。以下是动态分区的相关配置:
| 配置 | 默认值 | 说明 |
|---|---|---|
hive.exec.dynamic.partition |
true |
需要设置为true才能启用动态分区插入 |
hive.exec.dynamic.partition.mode |
strict |
在严格模式(strict)下,用户必须至少指定一个静态分区,以防用户意外覆盖所有分区,在非严格模式下,允许所有分区都是动态的 |
hive.exec.max.dynamic.partitions.pernode |
100 | 允许在每个mapper/reducer节点中创建的最大动态分区数 |
hive.exec.max.dynamic.partitions |
1000 | 允许总共创建的最大动态分区数 |
hive.exec.max.created.files |
100000 | 作业中所有mapper/reducer创建的HDFS文件的最大数量 |
hive.error.on.empty.partition |
false |
如果动态分区插入生成空结果,是否抛出异常 |
2.3 示例
- 新建emp表,作为查询对象表
CREATE TABLE emp(
    empno INT,
    ename STRING,
    job STRING,
    mgr INT,
    hiredate TIMESTAMP,
    sal DECIMAL(7,2),
    comm DECIMAL(7,2),
    deptno INT)
    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t";

 -- 加载数据到emp表中 这里直接从本地加载
load data local inpath "/usr/file/emp.txt" into table emp;
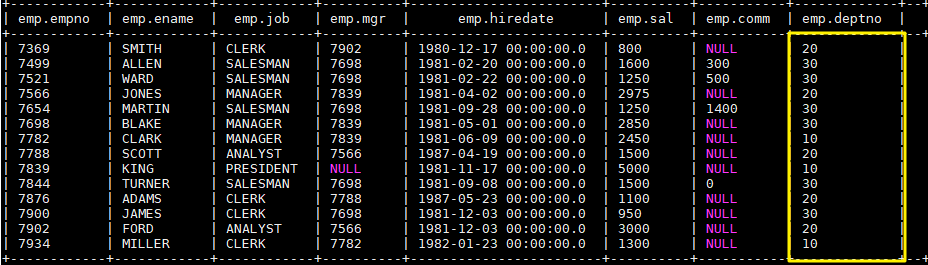
完成后emp表中数据如下:
- 为清晰演示,先清空
emp_ptn表中加载的数据:
TRUNCATE TABLE emp_ptn;
- 静态分区演示:从
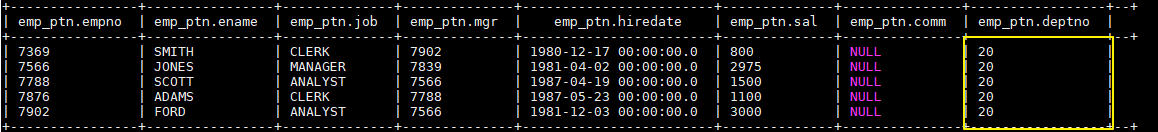
emp表中查询部门编号为20的员工数据,并插入emp_ptn表中,语句如下:
INSERT OVERWRITE TABLE emp_ptn PARTITION (deptno=20)
SELECT empno,ename,job,mgr,hiredate,sal,comm FROM emp WHERE deptno=20;
完成后emp_ptn表中数据如下:
- 接着演示动态分区:
-- 由于我们只有一个分区,且还是动态分区,所以需要关闭严格默认。因为在严格模式下,用户必须至少指定一个静态分区
set hive.exec.dynamic.partition.mode=nonstrict;

-- 动态分区   此时查询语句的最后一列为动态分区列,即deptno
INSERT OVERWRITE TABLE emp_ptn PARTITION (deptno)
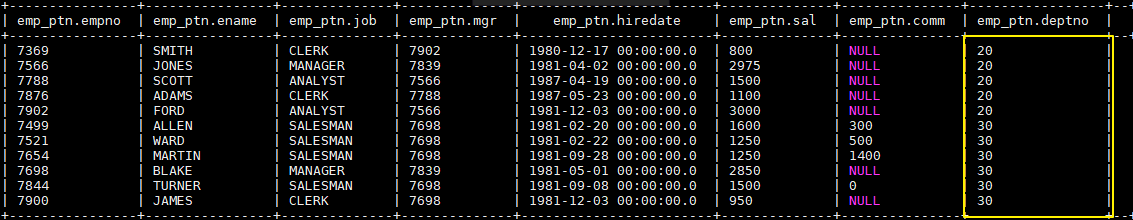
SELECT empno,ename,job,mgr,hiredate,sal,comm,deptno FROM emp WHERE deptno=30;
完成后emp_ptn表中数据如下:
三、使用SQL语句插入值
INSERT INTO TABLE tablename [PARTITION (partcol1[=val1], partcol2[=val2] ...)]
VALUES ( value [, value ...] )
- 使用时必须为表中的每个列都提供值。不支持只向部分列插入值(可以为缺省值的列提供空值来消除这个弊端);
- 如果目标表表支持ACID及其事务管理器,则插入后自动提交;
- 不支持支持复杂类型(array, map, struct, union)的插入。
四、更新和删除数据
4.1 语法
更新和删除的语法比较简单,和关系型数据库一致。需要注意的是这两个操作都只能在支持ACID的表,也就是事务表上才能执行。
-- 更新
UPDATE tablename SET column = value [, column = value ...] [WHERE expression]

--删除
DELETE FROM tablename [WHERE expression]
4.2 示例
1. 修改配置
首先需要更改hive-site.xml,添加如下配置,开启事务支持,配置完成后需要重启Hive服务。
<property>
    <name>hive.support.concurrency</name>
    <value>true</value>
</property>
<property>
    <name>hive.enforce.bucketing</name>
    <value>true</value>
</property>
<property>
    <name>hive.exec.dynamic.partition.mode</name>
    <value>nonstrict</value>
</property>
<property>
    <name>hive.txn.manager</name>
    <value>org.apache.hadoop.hive.ql.lockmgr.DbTxnManager</value>
</property>
<property>
    <name>hive.compactor.initiator.on</name>
    <value>true</value>
</property>
<property>
    <name>hive.in.test</name>
    <value>true</value>
</property>
2. 创建测试表
创建用于测试的事务表,建表时候指定属性transactional = true则代表该表是事务表。需要注意的是,按照官方文档的说明,目前Hive中的事务表有以下限制:
- 必须是buckets Table;
- 仅支持ORC文件格式;
- 不支持LOAD DATA …语句。
CREATE TABLE emp_ts(
  empno int,
  ename String
)
CLUSTERED BY (empno) INTO 2 BUCKETS STORED AS ORC
TBLPROPERTIES ("transactional"="true");
3. 插入测试数据
INSERT INTO TABLE emp_ts VALUES (1,"ming"),(2,"hong");
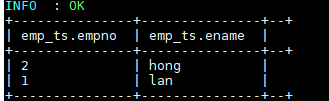
插入数据依靠的是MapReduce作业,执行成功后数据如下:
4. 测试更新和删除
--更新数据
UPDATE emp_ts SET ename = "lan"  WHERE  empno=1;

--删除数据
DELETE FROM emp_ts WHERE empno=2;
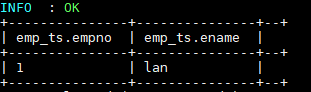
更新和删除数据依靠的也是MapReduce作业,执行成功后数据如下:
五、查询结果写出到文件系统
5.1 语法
INSERT OVERWRITE [LOCAL] DIRECTORY directory1
  [ROW FORMAT row_format] [STORED AS file_format]
  SELECT ... FROM ...
OVERWRITE关键字表示输出文件存在时,先删除后再重新写入;
和Load语句一样,建议无论是本地路径还是URL地址都使用完整的;
写入文件系统的数据被序列化为文本,其中列默认由^A分隔,行由换行符分隔。如果列不是基本类型,则将其序列化为JSON格式。其中行分隔符不允许自定义,但列分隔符可以自定义,如下:
-- 定义列分隔符为'\t'
insert overwrite local directory './test-04'
row format delimited
FIELDS TERMINATED BY '\t'
COLLECTION ITEMS TERMINATED BY ','
MAP KEYS TERMINATED BY ':'
select * from src;
5.2 示例
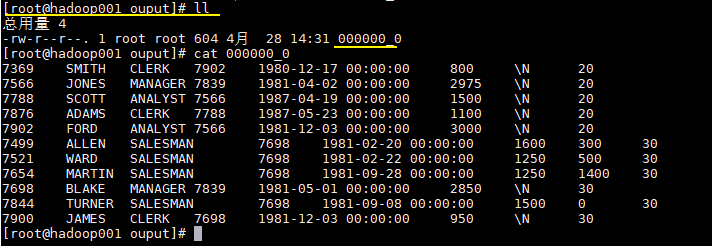
这里我们将上面创建的emp_ptn表导出到本地文件系统,语句如下:
INSERT OVERWRITE LOCAL DIRECTORY '/usr/file/ouput'
ROW FORMAT DELIMITED
FIELDS TERMINATED BY '\t'
SELECT * FROM emp_ptn;
导出结果如下:
参考资料
更多大数据系列文章可以参见个人 GitHub 开源项目: 程序员大数据入门指南
Hive 学习之路(七)—— Hive 常用DML操作的更多相关文章
- Object-c学习之路七(oc字符串操作)
// // main.m // NSString // // Created by WildCat on 13-7-25. // Copyright (c) 2013年 wildcat. All ri ...
- [转帖]Hive学习之路 (一)Hive初识
Hive学习之路 (一)Hive初识 https://www.cnblogs.com/qingyunzong/p/8707885.html 讨论QQ:1586558083 目录 Hive 简介 什么是 ...
- 入门大数据---Hive常用DML操作
Hive 常用DML操作 一.加载文件数据到表 1.1 语法 LOAD DATA [LOCAL] INPATH 'filepath' [OVERWRITE] INTO TABLE tablename ...
- [Python学习笔记][第七章Python文件操作]
2016/1/30学习内容 第七章 Python文件操作 文本文件 文本文件存储的是常规字符串,通常每行以换行符'\n'结尾. 二进制文件 二进制文件把对象内容以字节串(bytes)进行存储,无法用笔 ...
- Git学习之路(6)- 分支操作
▓▓▓▓▓▓ 大致介绍 几乎所有的版本控制系统都会支持分支操作,分支可以让你在不影响开发主线的情况下,随心所欲的实现你的想法,但是在大多数的版本控制系统中,这个过程的效率是非常低的.就比如我在没有学习 ...
- Hive 学习之路(四)—— Hive 常用DDL操作
一.Database 1.1 查看数据列表 show databases; 1.2 使用数据库 USE database_name; 1.3 新建数据库 语法: CREATE (DATABASE|SC ...
- Hive 系列(七)—— Hive 常用 DML 操作
一.加载文件数据到表 1.1 语法 LOAD DATA [LOCAL] INPATH 'filepath' [OVERWRITE] INTO TABLE tablename [PARTITION (p ...
- Hive学习之路 (一)Hive初识
Hive 简介 什么是Hive 1.Hive 由 Facebook 实现并开源 2.是基于 Hadoop 的一个数据仓库工具 3.可以将结构化的数据映射为一张数据库表 4.并提供 HQL(Hive S ...
- Hive学习之路 (二十一)Hive 优化策略
一.Hadoop 框架计算特性 1.数据量大不是问题,数据倾斜是个问题 2.jobs 数比较多的作业运行效率相对比较低,比如即使有几百行的表,如果多次关联多次 汇总,产生十几个 jobs,耗时很长.原 ...
随机推荐
- 一些自成系统、完备的教程(链接、博客、github等)
0. Linus shell Advanced Bash-Scripting Guide 1. latex Some applicable LATEX's info 14 课的个人 CV 制作: 15 ...
- 算法(algorithm)、模型(model)与框架(framework)
模型对应的数学公式,公式中往往有待学习得到的参数,因此在进行训练或者学习时,首先初始化这部分参数(0 或标准正太分布): 学习之前的初始化:initial model: 学习完成之后的模型:final ...
- 使用Struts2的iterator标签遍历复杂Map种类
1.建一个Webproject.加入Struts2支持. 2.创建两个实体类: a). Mother(母亲)的Java类. package struts.map.entity; import java ...
- WPF自定义控件 使用阿里巴巴图标
原文:WPF自定义控件 使用阿里巴巴图标 上一篇介绍了 WPF自定义控件 按钮 的初步使用,在进一步介绍WPF自定义控件 按钮之前,先介绍一下如何在WPF项目中使用阿里巴巴图标,方便以后做示例. 1. ...
- Something write in FSE 2014
Now, I find a problem, I have become my personal CSDN into a personal electronic diary. Actually, th ...
- 合并 && 还原属性链
效果 原数据 { "id": 10, "text": { "title": "title", "content ...
- 如何自定义WPF项目的Main函数
原文:如何自定义WPF项目的Main函数 与Winform项目不同,WPF项目的Main函数在项目生成的时候,系统自动在后台为我们生成.根据项目生成方式的不同,其文件位于obj/Debug/App.g ...
- 基于 CSP 的设计思想和 OOP 设计思想的异同
LinkerLin Go语言推崇的CSP编程模型和设计思想,并没有引起很多Go开发者包括Go标准库作者的重视.标准库的很多设计保留了很浓的OOP的味道.本篇Blog想比较下从设计的角度看,CSP和OO ...
- Redis 一些高级用法
延迟消息队列 利用 expire keyspace notification Redis 过期时,会向特定的消息队列发送消息,监听该消息队列 在 redis.conf 修改 notify-keyspa ...
- JNDI(Java Naming and Directory Interface)
# 前言 内容基本拷贝,整理出来,方便以后回忆. # What The Java Naming and Directory Interface™ (JNDI) is an application pr ...