
使用Python爬虫整理小说网资源-自学
第一次接触python,原本C语言的习惯使得我还不是很适应python的语法风格。希望读者能够给出建议。
相关的入门指导来自以下的网址:https://blog.csdn.net/c406495762/article/details/78123502编者的文章很用心,好评。
下面是本次自学的详细说明:
----->确认目标:我选择一个不是很出名的小说网,之所以这么做,是因为一些大网站上一般都有一些反爬虫机制,作为一只弱鸡,还是选个容易上手的小网站。
->穿越小说网->《妖界之门》:http://www.15kxs.com/cbbook_22000/->这是章节汇总
点开第一章:http://www.15kxs.com/cbbook_22000/1.html 对比两个网址再多点开几个网页就很容易发现URL中的规律。但是这里为了更好的熟悉相关代码,我决定进行如下操作:
在章节汇总的网页上提取各个章节的网址并逐一请求,清洗网页源代码得到文章,并将文章汇总到本地的txt文件中。
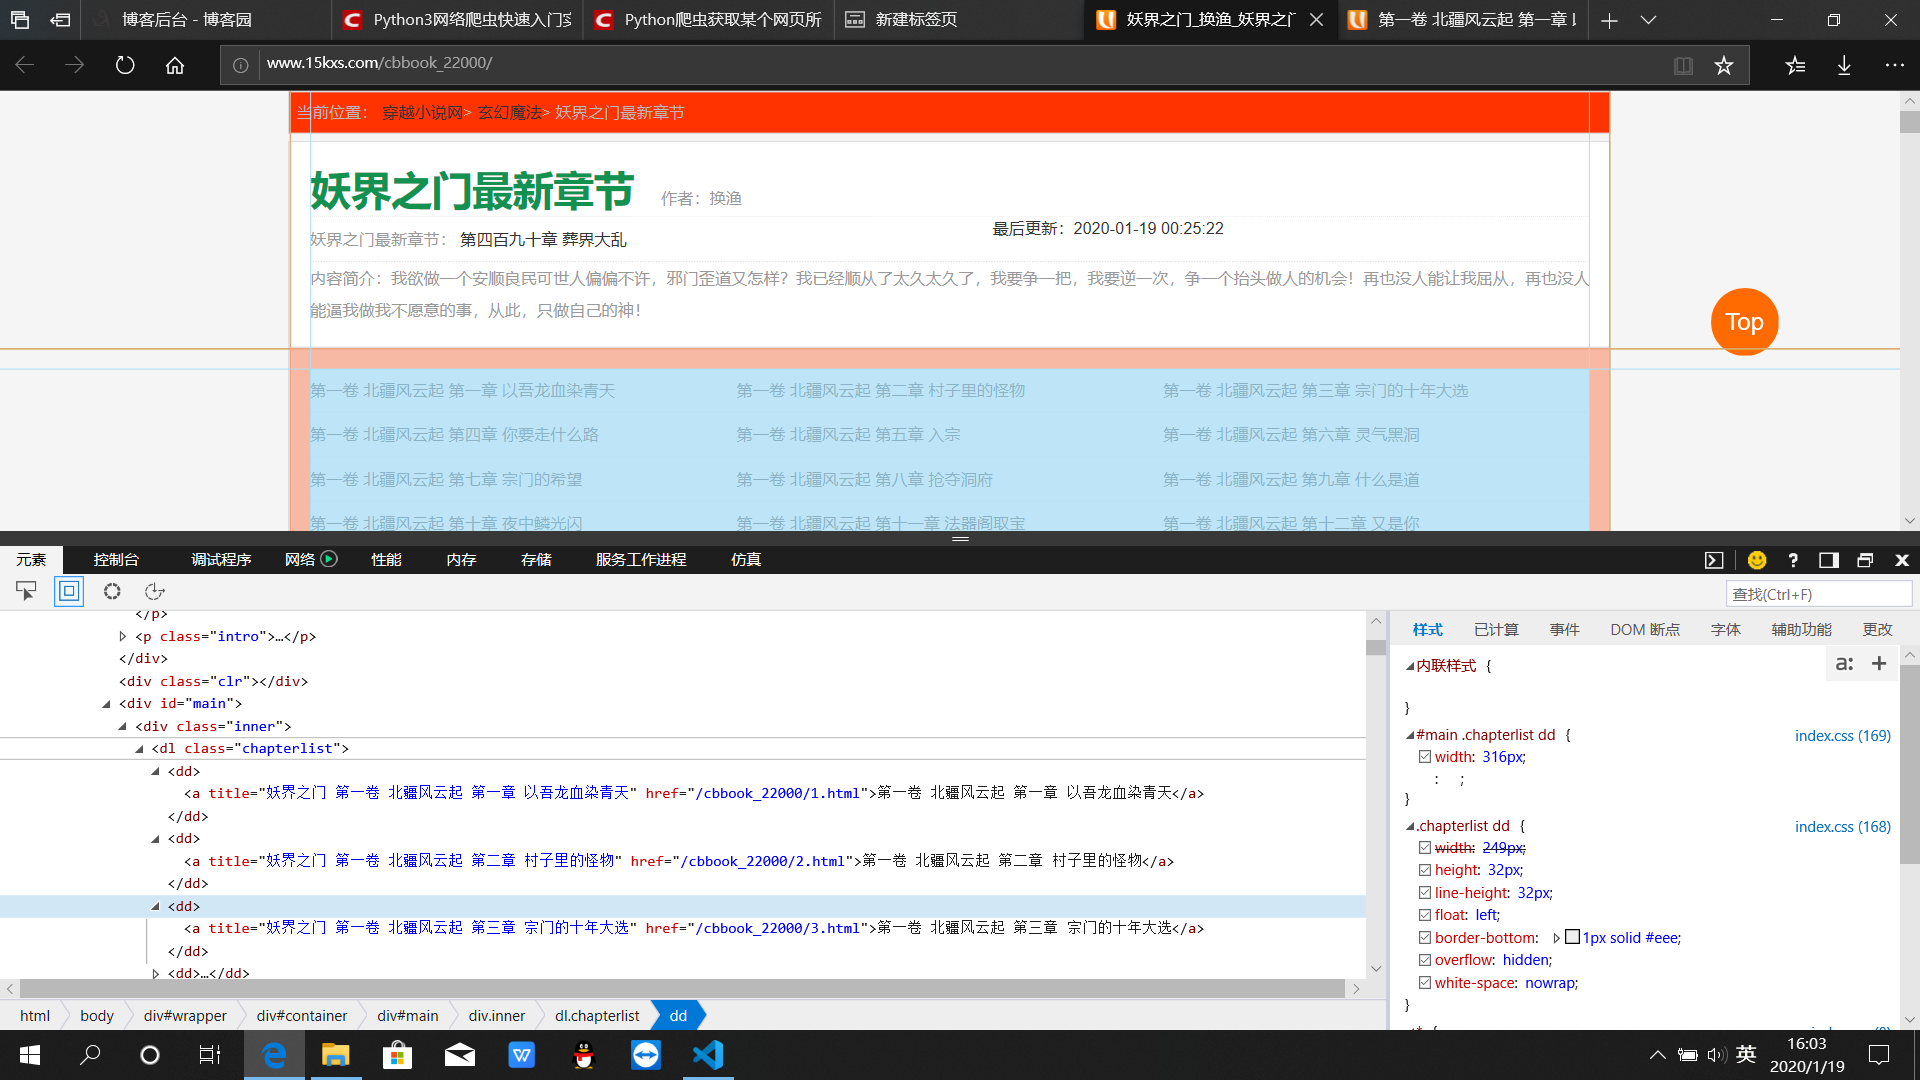
目标是提取<a>中的“href=”的地址
下面是Python代码
 # -*- coding:UTF-8 -*-

 from bs4 import BeautifulSoup

 import requests

 filename = 'novel.txt'

 if __name__ == "__main__":

     aim = "http://www.15kxs.com/cbbook_22000/"

     cyc = requests.get(aim)

     psd = cyc.text

     cnt = BeautifulSoup(psd,features="html.parser")

     clc = cnt.find_all('a')

     first = 0#在实验过程中发现章节网页中<a>的所有选项中提出的网址不仅仅包括着小说页面,对于其他页面进行筛选

     for haim in clc:

         link = haim.get('href')

         lenth = len(link)

         if first>2 and lenth!=0 and link[0]=='/':

             """拿到了每一个章节的链接尾地址"""

             urlaim="http://www.15kxs.com"+link

             request_get = requests.get(urlaim)

             html = request_get.text

             ctm = BeautifulSoup(html,features="html.parser")

             tex = ctm.find_all('div',id='BookText')

             result = tex[0].text.replace('\xa0','')#编码格式是一个难点,能够打印到屏幕上的字符不一定能写入文件

             with open(filename,'a',encoding='utf-8') as file_object:

                 file_object.write(result)

         first = first+1#用于计算数量

         print(str(first)+" is ok")

     print("all above is ok")
效果如下:
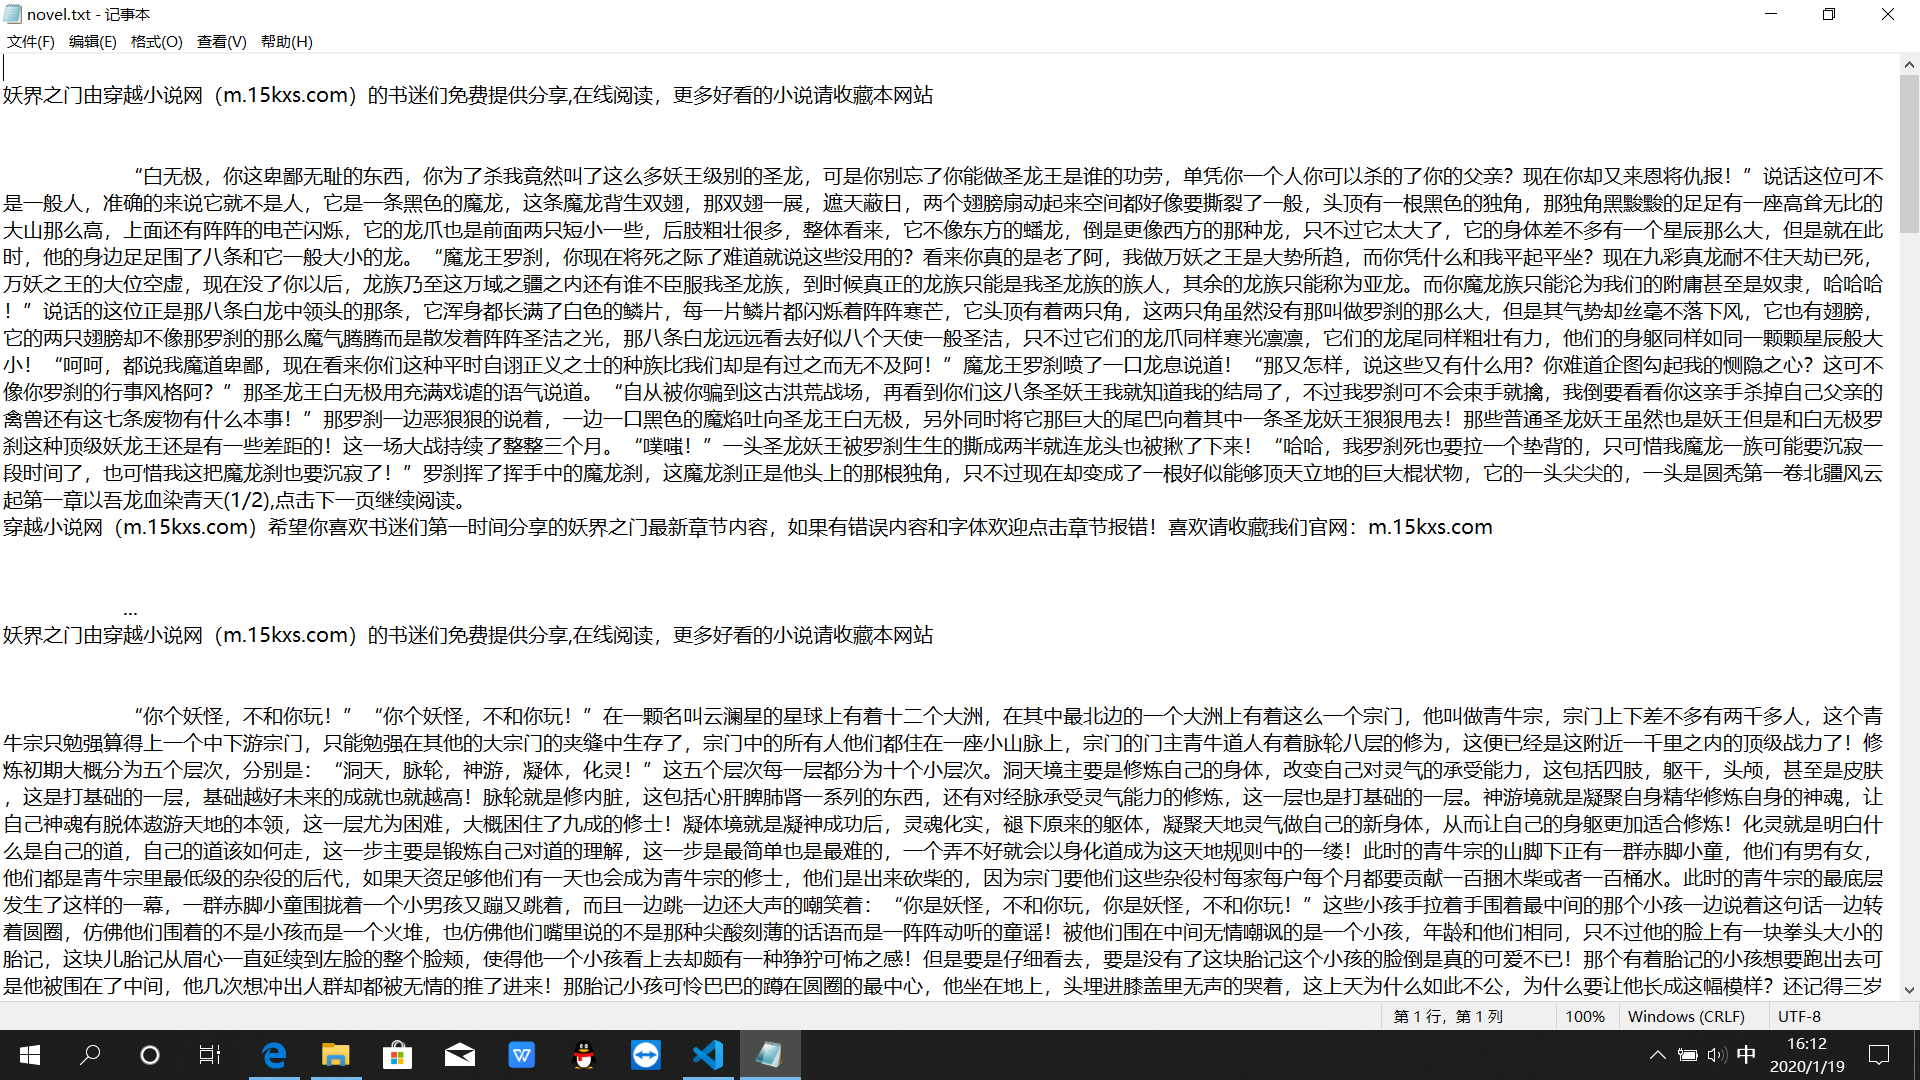
表示效果还可以
唯一不足的是:抽取速度有些慢,5分钟内只能整理110章节左右
使用Python爬虫整理小说网资源-自学的更多相关文章
- 【收藏】收集的各种Python爬虫、暗网爬虫、豆瓣爬虫、抖音爬虫 Github1万+星
收集的各种Python爬虫.暗网爬虫.豆瓣爬虫 Github 1万+星 磁力搜索网站2020/01/07更新 https://www.cnblogs.com/cilisousuo/p/1209954 ...
- python爬虫之小说网站--下载小说(正则表达式)
python爬虫之小说网站--下载小说(正则表达式) 思路: 1.找到要下载的小说首页,打开网页源代码进行分析(例:https://www.kanunu8.com/files/old/2011/244 ...
- python爬虫——《瓜子网》的广州二手车市场信息
由于多线程爬取数据比单线程的效率要高,尤其对于爬取数据量大的情况,效果更好,所以这次采用多线程进行爬取.具体代码和流程如下: import math import re from concurrent ...
- python 爬虫 scrapy1_官网教程
Python爬虫视频教程零基础小白到scrapy爬虫高手-轻松入门 https://item.taobao.com/item.htm?spm=a1z38n.10677092.0.0.482434a6E ...
- python爬虫爬小说网站涉及到(js加密,CSS加密)
我是对于xxxx小说网进行爬取只讲思路不展示代码请见谅 一.涉及到的反爬 js加密 css加密 请求头中的User-Agent以及 cookie 二.思路 1.对于js加密 对于有js加密信息,我们一 ...
- python|爬虫东宫小说
2k小说网爬取最近大火的<东宫>小说,借鉴之前看过的一段代码,修改之后,进行简单爬取. from urllib import requestfrom bs4 import Beautifu ...
- 利用Python爬虫实现百度网盘自动化添加资源
事情的起因是这样的,由于我想找几部经典电影欣赏欣赏,于是便向某老司机寻求资源(我备注了需要正规视频,绝对不是他想的那种资源),然后他丢给了我一个视频资源网站,说是比较有名的视频资源网站.我信以为真,便 ...
- 如何丧心病狂的使用python爬虫读小说
写在前边 其实一直想入门python很久了,慕课网啊,菜鸟教程啊python的基础的知识被我翻了很多遍了,但是一直没有什么实践.刚好,这两天被别人一直安利一本小说<我可能修的是假仙>,还在 ...
- Python爬虫-爬小说
用途 用来爬小说网站的小说默认是这本御天邪神,虽然我并没有看小说,但是丝毫不妨碍我用爬虫来爬小说啊. 如果下载不到txt,那不如自己把txt爬下来好了. 功能 将小说取回,去除HTML标签 记录已爬过 ...
随机推荐
- Kafka系列3:深入理解Kafka消费者
上面两篇聊了Kafka概况和Kafka生产者,包含了Kafka的基本概念.设计原理.设计核心以及生产者的核心原理.本篇单独聊聊Kafka的消费者,包括如下内容: 消费者和消费者组 如何创建消费者 如何 ...
- Qt 中QPainter 使用中出现的问题
这两天在使用QPainter的过程中出现了一些问题,记录一下. 测试程序很简单,写一个继承自QWidget的类,重载其paintEvent函数进行绘图. case1: 在paintEvent函数中使用 ...
- Python单引号、双引号、三个双引号的区别
单引号与双引号是作用是一样的,都是字符串定界符. 如果字符串里面包含的与边界一样的符号,需要转义符来将该符号转成普通字符,不然编译器会将字符串中的那个单引号或双引号当成字符串的边界. 例如: ‘I d ...
- [redis读书笔记] 第一部分 数据结构与对象 整数集合
typedef struct intset { // 编码方式 uint32_t encoding; // 集合包含的元素数量 uint32_t length; // 保存元素的数组 int8_t c ...
- pytorch之 Variable
import torch from torch.autograd import Variable # Variable in torch is to build a computational gra ...
- Mysql 命令 操作
1.user表 如果需要从其他机器连接 mysql 服务器报这个错“ERROR 1130: Host 'root' is not allowed to connect to this M ...
- [Redis-CentOS7]Redis发布订阅操作(七)
发布订阅 发布:打电话 订阅:接电话 订阅频道 127.0.0.1:6379> SUBSCRIBE msg Reading messages... (press Ctrl-C to quit) ...
- CVE-2020-0618 SQL Server远程代码执行
1.简介 SQL Server Reporting Services(SSRS)提供了一组本地工具和服务,用于创建,部署和管理移动报告和分页报告. SSRS Web应用程序中的功能允许低特权用户帐户通 ...
- 【Web性能权威指南】 PDF
Web性能权威指南.pdf 网盘:https://545c.com/file/24657411-424998805 获取码:276922
- 推荐一款疫情期间适合在家办公的远程工具,仅需IP和密码轻松实现远程管理
这段时间,受疫情影响,很多企业都开启了居家办公模式.但疫情突发,大多数人的办公资料没有拷贝打包,对于居家办公的人,尤其是运维人员来说,很难完成顺利完成工作. 像向日葵.teamviewer之类的远程软 ...