
xpath拉取链家二手房信息并保存到excel中
import os.path

import requests

from lxml import etree

import xlwt

import xlrd

def create_excel():

    if not os.path.exists('./lianjia_excel.xls'):

        book = xlwt.Workbook(encoding='utf-8', style_compression=0)

        sheet = book.add_sheet(f'{city}-链家二手房', cell_overwrite_ok=True)

        col = ('房源名称', '所在小区', '所在地区', '房源信息', '发布时间', '房源标签', '房源价格', '房源单价')

        # 创建列名

        for i in range(0, 8):

            sheet.write(0, i, col[i])

        savepath = './lianjia_excel.xls'

        book.save(savepath)

        return book

    book = xlrd.open_workbook('./lianjia_excel.xls')  # 得到文件

    return book

if __name__ == '__main__':

    city = input('请输入需要查询的城市数据:')

    # 创建一个excel

    book = xlwt.Workbook(encoding='utf-8', style_compression=0)

    sheet = book.add_sheet(f'{city}-链家二手房', cell_overwrite_ok=True)

    col = ('房源名称', '所在小区', '所在地区', '房源信息', '发布时间', '房源标签', '房源价格', '房源单价')

    # 创建列名

    for i in range(0, 8):

        sheet.write(0, i, col[i])

    url = 'https://cd.lianjia.com/ershoufang/'

    headers = {

        'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/106.0.0.0 Safari/537.36'

    }

    page = requests.get(url=url, headers=headers)

    page.encoding = 'utf-8'

    tree = etree.HTML(page.text)

    li_list = tree.xpath('//div[@class="content "]/div/ul[@class="sellListContent"]/li')

    data_list = []

    for li in li_list:

        li_div = li.xpath('./div[@class="info clear"]')

        if len(li_div) <= 0:

            continue

        li_div = li.xpath('./div[@class="info clear"]')[0]

        # 房源名称

        li_title = li_div.xpath('./div[@class="title"]/a/text()')[0]

        # 房源链接

        li_url = li_div.xpath('./div[@class="title"]/a/@href')[0]

        # 所在小区

        li_xiaoqu = li_div.xpath('./div[@class="flood"]/div/a[1]/text()')[0]

        # 所在小区URL

        li_xiaoqu_url = li_div.xpath('./div[@class="flood"]/div/a[1]/@href')[0]

        # 所在地区

        li_diqu = li_div.xpath('./div[@class="flood"]/div/a[2]/text()')[0]

        # 所在地区URL

        li_diqu_url = li_div.xpath('./div[@class="flood"]/div/a[2]/@href')[0]

        # 房源信息

        li_houseinfo = li_div.xpath('./div[@class="address"]/div/text()')[0]

        # 发布时间

        li_followinfo = li_div.xpath('./div[@class="followInfo"]//text()')

        # 房源标签

        li_tag = li_div.xpath('./div[@class="tag"]//text()')

        # 房源总价

        li_price = li_div.xpath('./div[@class="priceInfo"]/div[1]/span/text()')[0]

        li_price = li_price + '万'

        # 房源单价

        li_unitPrice = li_div.xpath('./div[@class="priceInfo"]/div[2]/span/text()')[0]

        data_list.append([li_title, li_xiaoqu, li_diqu, li_houseinfo, li_followinfo, li_tag, li_price, li_unitPrice])

    for data in data_list:

        for i in range(0, len(data_list)):

            data = data_list[i]

            for j in range(0, 8):

                sheet.write(i + 1, j, data[j])

    savepath = './lianjia_excel.xls'

    book.save(savepath)
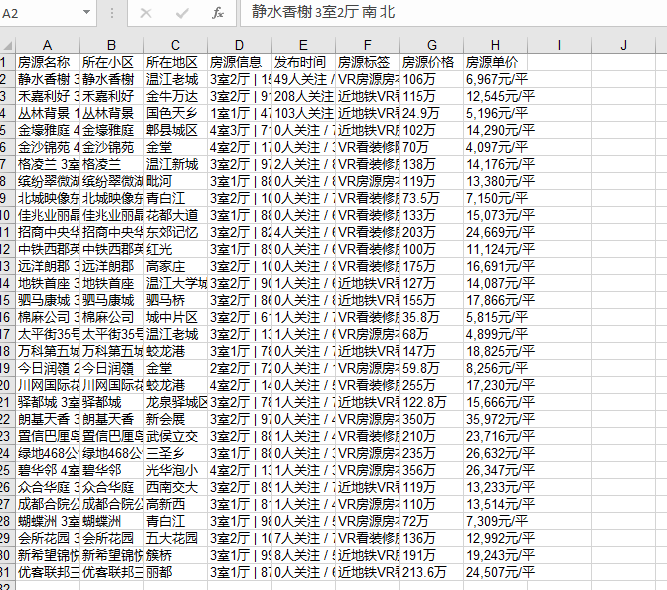
excel保存效果如图:
xpath拉取链家二手房信息并保存到excel中的更多相关文章
- 使用requests、BeautifulSoup、线程池爬取艺龙酒店信息并保存到Excel中
import requests import time, random, csv from fake_useragent import UserAgent from bs4 import Beauti ...
- 使用requests、re、BeautifulSoup、线程池爬取携程酒店信息并保存到Excel中
import requests import json import re import csv import threadpool import time, random from bs4 impo ...
- python爬取链家二手房信息,确认过眼神我是买不起的人
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,如有问题请及时联系我们以作处理. PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取 python免费学习资 ...
- 用python实现批量获取Linux主机简要信息并保存到Excel中 unstable 1.1
#!/usr/bin/env python3 # -*- coding: utf-8 -*- #filename get_linux_info.py #获取Linux主机的信息 # titles=[' ...
- 第三方模块的下载与使用、requests模块、爬取链家二手房数据、openpyxl模块、hashlib加密模块
目录 第三方模块的下载与使用 下载第三方模块可能会出现的问题 网络爬虫模块之requests模块 网络爬虫实战之爬取链家二手房数据 自动化办公领域之openpyxl模块 第三方模块的下载与使用 第三方 ...
- python抓取链家房源信息(二)
试着用scrapy将之前写的抓取链家网信息的重新写了写 然后先是用了第一页的网页作为测试,调试代码,然后发现总是抓取的时候遇见了 类似于这样的问题,并且抓取不到信息 2017-03-28 17:52: ...
- 【nodejs 爬虫】使用 puppeteer 爬取链家房价信息
使用 puppeteer 爬取链家房价信息 目录 使用 puppeteer 爬取链家房价信息 页面结构 爬虫库 pupeteer 库 实现 打开待爬页面 遍历区级页面 方法一 方法二 遍历街道页面 遍 ...
- python3 爬虫教学之爬取链家二手房(最下面源码) //以更新源码
前言 作为一只小白,刚进入Python爬虫领域,今天尝试一下爬取链家的二手房,之前已经爬取了房天下的了,看看链家有什么不同,马上开始. 一.分析观察爬取网站结构 这里以广州链家二手房为例:http:/ ...
- Python爬取链家二手房源信息
爬取链家网站二手房房源信息,第一次做,仅供参考,要用scrapy. import scrapy,pypinyin,requests import bs4 from ..items import L ...
- python抓取链家房源信息(三)
之前写过一个链家网北京二手房的数据抓取,然后本来今天想着要把所有的东西弄完,但是临时有事出去了一趟,耽搁了一下,然后现在是想着把北京的二手房的信息都进行抓取,并且存储在mongodb中, 首先是通过' ...
随机推荐
- 除了Navicat和DBeaver,还有没有免费又好用的数据库管理/SQL工具推荐
很多国内SQL学习者和开发者对Navicat.DBeaver等国外数据库管理工具已经很熟悉了.但是,有没有比他们更适合SQL开发者的数据库管理/SQL工具呢?这里,笔者结合自己的调研来聊一下. 笔者做 ...
- Java 进阶P-5.1+P-5.2
城堡游戏 一.城堡游戏介绍:1.这个程序的任务是通过玩家的输入的方向(纯文字)在虚构的城堡内移动(以纯文字作为移动后的返回结果).2.这个程序接受help.bye.go south.go north. ...
- JDK的下载与安装-环境变量的配置
JDK的下载与安装 环境变量的配置 配置环境变量作用 开发Java程序,需要使用JDK中提供的工具,工具在JDK9安装目录的 bin 目录下. 在DOS命令行下使用这些工具,就要先进入到JDK的bin ...
- 【随笔记】Tina 系统的 ADB、声卡、网卡、串口多路共存
全志 Tina 系统的 USB Gadget 配置方法,随笔记录,实测为 R311 平台,其它平台应该通用. 一.配置内核 二.编译驱动并加载 # UAC insmod usb_f_uac1.ko ...
- Loadrunner的函数收集
1.int web_url( const char *StepName, const char *url, <List of Attributes>, [EXTRARES, <Lis ...
- tomcat报错:java.io.IOException: No space left on device
1 简介 今天网站很多页面访问突然就404了,路径分明没有变,是正确的,就很奇怪 排查日志发现报错java.io.IOException: No space left on device 这个错误,是 ...
- vue+element 返回数组或json数据自定义某列显示的处理--两种方法
本文是作者开发一个业务需求时,将返回数据列表的其中一个数据长度很长的字段处理成数组,并将其作为子表显示的过程,具体样式如下(数据做了马赛克处理) 返回的过长字段数据处理(用分号分隔的一个长字段): t ...
- soucrce insight4 使用
1.快捷键 F8 高亮 ctrl + 左击 进入函数定义或变量声明处 Alt + , 后退 Alt + . 前进 ctrl + g 跳到固定行 shift + F3 选中一个单词按下后,可按F3,F4 ...
- 【多线程与高并发】- synchronized锁的认知
synchronized锁的认知 生命不息,写作不止 继续踏上学习之路,学之分享笔记 总有一天我也能像各位大佬一样 一个有梦有戏的人 @怒放吧德德 分享学习心得,欢迎指正,大家一起学习成长! 目录 s ...
- JavaScript是怎样实现继承的?
一.是什么 继承(inheritance)是面向对象软件技术当中的一个概念. 如果一个类别B"继承自"另一个类别A,就把这个B称为"A的子类",而把A称为&qu ...