
Mapreduce求气温值项目
Mapreduce前提工作
简单的来说map是大数据,reduce是计算<运行时如果数据量不大,但是却要分工做这就比较花时间了>
首先想要使用mapreduce,需要在linux中进行一些配置:
1.在notepad++里修改yarn-site.xml文件,新添加
<property>

<name>yarn.resourcemanager.hostname</name>

<value>192.168.64.141</value>

</property>

<property>

<name>yarn.nodemanager.aux-service</name>

<value>mapreduce_shuffle</value>

</property>

在notepad++里修改mapred-site.xml文件,新添加

<property>

<name>mapreduce.framework.name</name>

<value>yarn</value>

</property>
2.在xshell里将soft/soft/hadoop/etc/hadoop下的mapred-site.xml.template去掉后缀名

3.保证在start-dfs.sh、start-yarn.sh服务打开情况下
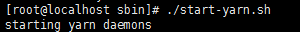
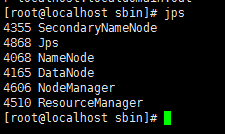
检测服务是否打开。输入Jps,显示namenod 和 datanod
4.到hadoop目录下新建一个有数据的txt
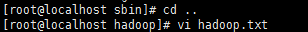
 (保存退出是 Esc 后输入:wq!)
5.确保文件存在之后,将其放在hadoop文件下(如果用可视化界面如XFTP比较难找目录,但是使用eclipse上的小蓝象还是挺方便的)
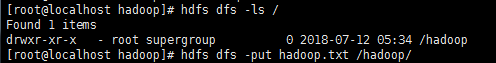
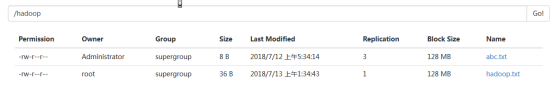
6.在我们的ip下查看,已经将hadoop.txt放进了hadoop下
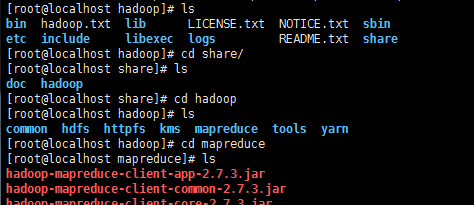
7.到hadoop下的mapreduce文件下
8.在hadoop下运行(这里hadoop-mapreduce-examples-2.7.3.jar是以及放在上面的架包工具)

可以看见数据在map和reduce之间传


9.也可以刷新eclipse里面的hadoop文件下的abc.txt查看结果
接下来我们自己来写一个mapreduce吧!
在mapreduce中,map和reduce是有个字不同的所以要单独写成两个类。
1.引入架包
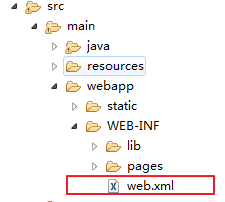
2.创建webapp下的WEB-INF文件下的web.xml
2.建类
Worldcount项目
Mapper代码:
package com.nenu.mprd.test;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

public class MyMap extends Mapper<LongWritable, Text, Text, IntWritable> {

    @Override

    protected void map(LongWritable key, Text value, Mapper<LongWritable, Text, Text, IntWritable>.Context context)

            throws IOException, InterruptedException {

        // TODO Auto-generated method stub

        String line=value.toString();

        String[] words=line.split(" ");

        for (String word : words) {

            context.write(new Text(word.trim()), new IntWritable(1));

        }

    }

}
Reduce代码:
package com.nenu.mprd.test;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

public class MyReduce extends Reducer<Text, IntWritable, Text, IntWritable> {

    @Override

    protected void reduce(Text key, Iterable<IntWritable> values,

            Reducer<Text, IntWritable, Text, IntWritable>.Context context) throws IOException, InterruptedException {

        // TODO Auto-generated method stub

        int sum=0;

        for (IntWritable intWritable : values) {

            sum+=intWritable.get();

        }

        context.write(key, new IntWritable(sum));

    }

}
Job代码:
package com.nenu.mprd.test;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.conf.Configured;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.util.Tool;

import org.apache.hadoop.util.ToolRunner;

public class MyJob extends Configured implements Tool{

    public static void main(String[] args) throws Exception {

        MyJob myJob=new MyJob();

        ToolRunner.run(myJob, null);

    }

    @Override

    public int run(String[] args) throws Exception {

        // TODO Auto-generated method stub

        Configuration conf=new Configuration();

        conf.set("fs.defaultFS", "hdfs://192.168.64.141:9000");

        Job job=Job.getInstance(conf);

        job.setJarByClass(MyJob.class);

        job.setMapperClass(MyMap.class);

        job.setReducerClass(MyReduce.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        FileInputFormat.addInputPath(job, new Path("/hadoop/hadoop.txt"));

        FileOutputFormat.setOutputPath(job, new Path("/hadoop/out"));

        job.waitForCompletion(true);

        return 0;

    }

}
Weather平均气温项目:
Mapper代码:
package com.nenu.weathermyreduce.test;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.InputSplit;

import org.apache.hadoop.mapreduce.lib.input.FileSplit;

//传入文件 输出拆分后的每个单词

public class MyMap extends Mapper<LongWritable, Text, Text, IntWritable> {

    @Override

    protected void map(LongWritable key, Text value, Mapper<LongWritable, Text, Text, IntWritable>.Context context)

            throws IOException, InterruptedException {

        // TODO Auto-generated method stub

        //获取文件目录下的每个文件的部分文件名

        FileSplit filesplit = (FileSplit)context.getInputSplit();

        String fileName =  filesplit.getPath().getName().substring(5,10).trim();

        //获取气温值

        //每次只处理一行  字符偏移量下一行第一个字符为上一行最后一个字符位+1

        //按行提取字符串

        String line=value.toString();

        //获取对应位置上的气温

        Integer val =Integer.parseInt(line.substring(13, 19).trim());//去掉空格

        //文件名作为输出key 获取的气温值作为value

        //相同的key会交给同一个reduce进行计算

        context.write(new Text(fileName), new IntWritable(val));

    }

}
Reduce代码:
package com.nenu.weathermyreduce.test;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

//输入单词 输出混洗、统计结果和

public class MyReduce extends Reducer<Text, IntWritable, Text, IntWritable> {

    @Override

    protected void reduce(Text key, Iterable<IntWritable> values,

            Reducer<Text, IntWritable, Text, IntWritable>.Context context) throws IOException, InterruptedException {

        // TODO Auto-generated method stub

        //求平均数

            //计数 一共有多少个数据

            int sum=0;//和

            int count=0;//计算

            for (IntWritable val : values) {

                count++;

                sum+=val.get();//转换为int类型

            }

            int average = sum/count;

            context.write(key, new IntWritable(average));

    }

}
Myjob代码:
package com.nenu.weathermyreduce.test;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.conf.Configured;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.util.Tool;

import org.apache.hadoop.util.ToolRunner;

public class MyJob extends Configured implements Tool{

    public static void main(String[] args) throws Exception {

        MyJob myJob=new MyJob();

        ToolRunner.run(myJob, null);

    }

    @Override

    public int run(String[] args) throws Exception {

        // TODO Auto-generated method stub

        Configuration conf=new Configuration();

        conf.set("fs.defaultFS", "hdfs://192.168.64.141:9000");

        Job job=Job.getInstance(conf);

        job.setJarByClass(MyJob.class);

        job.setMapperClass(MyMap.class);

        job.setReducerClass(MyReduce.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        FileInputFormat.addInputPath(job, new Path("/hadoop/weather"));

        FileOutputFormat.setOutputPath(job, new Path("/hadoop/weather/out"));

        job.waitForCompletion(true);

        return 0;

    }

}
3.开启服务,dfs+yarn。(所有mapreduce项目都需要开启yarn,yarn下管理资源和节点)
4.运行job类
Job的任务:
是mapreduce程序运行的主类。指定使用的是哪个mapper哪个reduce
指定mapper、reduce输入输出的key-value类型
以及输入、输出的数据位置
要说明的一点是,在我的程序中Job提交---一般是用waitforCompletion(true)可以看见运行过程(不用submit)
Mapreduce求气温值项目的更多相关文章
- Hadoop阅读笔记(二)——利用MapReduce求平均数和去重
前言:圣诞节来了,我怎么能虚度光阴呢?!依稀记得,那一年,大家互赠贺卡,短短几行字,字字融化在心里:那一年,大家在水果市场,寻找那些最能代表自己心意的苹果香蕉梨,摸着冰冷的水果外皮,内心早已滚烫.这一 ...
- ACM3 求最值
/*2*2014.11.18*求最值*描述:给定N个整数(1<=N<=100),求出这N个数中的最大值,最小值.*输入:多组数据,第一行为一个整数N,第二行为N个不超过100的正整数,用空 ...
- [NOI2005]维修数列 Splay tree 区间反转,修改,求和,求最值
题目链接:http://www.lydsy.com/JudgeOnline/problem.php?id=1500 Description Input 输入文件的第1行包含两个数N和M,N表示初始时数 ...
- hdu4521-小明系列问题——小明序列(线段树区间求最值)
题意:求最长上升序列的长度(LIS),但是要求相邻的两个数距离至少为d,数据范围较大,普通dp肯定TLE.线段树搞之就可以了,或者优化后的nlogn的dp. 代码为 线段树解法. #include ...
- javascript之求最值
求最值: var selections = $("#deliveryGridSalesOrGoods").datagrid('getRows'); var costPrice = ...
- poj3264(线段树区间求最值)
题目连接:http://poj.org/problem?id=3264 题意:给定Q(1<=Q<=200000)个数A1,A2,```,AQ,多次求任一区间Ai-Aj中最大数和最小数的差. ...
- Sql示例说明如何分组后求中间值--【叶子】
原文:Sql示例说明如何分组后求中间值--[叶子] 这里所谓的分组后求中间值是个什么概念呢? 我举个例子来说明一下: 假设我们现在有下面这样一个表: type name price -- ...
- hdu 1754 I Hate It(树状数组区间求最值)2007省赛集训队练习赛(6)_linle专场
题意: 输入一行数字,查询第i个数到第j个数之间的最大值.可以修改其中的某个数的值. 输入: 包含多组输入数据. 每组输入首行两个整数n,m.表示共有n个数,m次操作. 接下来一行包含n个整数. 接下 ...
- C语言 · 求arccos值
算法提高 7-2求arccos值 时间限制:10.0s 内存限制:256.0MB 问题描述 利用标准库中的cos(x)和fabs(x)函数实现arccos(x)函数,x取值范围是[- ...
随机推荐
- 自定义shiro实现权限验证方法isAccessAllowed
由于Shiro filterChainDefinitions中 roles默认是and, admin= user,roles[system,general] 比如:roles[system,gener ...
- 暑假第二弹:基于docker的hadoop分布式集群系统的搭建和测试
早在四月份的时候,就已经开了这篇文章.当时是参加数据挖掘的比赛,在计科院大佬的建议下用TensorFlow搞深度学习,而且要在自己的hadoop分布式集群系统下搞. 当时可把我们牛逼坏了,在没有基础的 ...
- mysql—常用查询语句总结
关于MySQL常用的查询语句 一查询数值型数据: ; 查询谓词:>,=,<,<>,!=,!>,!<,=>,=< 二查询字符串 SELECT * FROM ...
- UE4 行为树资料
Composites Select 选择 从左往右执行其子节点,直到一个达成,则 Select 达成并返回上层,否则失败并返回上层 Sequence 队列 从左往右执行其子节点,直到一个失败,则 Se ...
- 内网环境上部署k8s+docker集群:集群ftp的yum源配置
接触docker已经有一年了,想把做的时候的一些知识分享给大家. 因为公司机房是内网环境无法连接外网,所以这里所有的部署都是基于内网环境进行的. 首先,需要通过ftp服务制作本地的yum源,可以从ht ...
- 【尚学堂·Hadoop学习】MapReduce案例2--好友推荐
案例描述 根据好友列表,推荐好友的好友 数据集 tom hello hadoop cat world hadoop hello hive cat tom hive mr hive hello hive ...
- RocketMq发送消息出现com.alibaba.rocketmq.client.exception.MQBrokerException: CODE: 2 DESC: [TIMEOUT_CLEAN_QUEUE]broker busy, start flow control for a while, period in queue: 201ms, size of queue: 1
最近对系统进行压测,发现发送消息到消息队列的时候出现如下错误: com.alibaba.rocketmq.client.exception.MQBrokerException: CODE: 2 DE ...
- Mac安装SecureCRT
8.3.1版本 链接:https://pan.baidu.com/s/1ohHunH_OVewF4QuRUzmChQ 密码:mc77 下载解压后直接是.app 直接打开会提示文件损害 打开终端,输入如 ...
- 【easy】437. Path Sum III 二叉树任意起始区间和
/** * Definition for a binary tree node. * struct TreeNode { * int val; * TreeNode *left; * TreeNode ...
- Python爬虫基础之UrlError
一.urllib.error python的urllib.error模块主要是应对urllib.request在网络请求过程中出现的异常而定义的异常处理类.主要有URLError和HTTPError两 ...