
吴裕雄 python 机器学习-NBYS(1)
import numpy as np

def loadDataSet():

    postingList=[['my', 'dog', 'has', 'flea', 'problems', 'help', 'please'],

                 ['maybe', 'not', 'take', 'him', 'to', 'dog', 'park', 'stupid'],

                 ['my', 'dalmation', 'is', 'so', 'cute', 'I', 'love', 'him'],

                 ['stop', 'posting', 'stupid', 'worthless', 'garbage'],

                 ['mr', 'licks', 'ate', 'my', 'steak', 'how', 'to', 'stop', 'him'],

                 ['quit', 'buying', 'worthless', 'dog', 'food', 'stupid']]

    classVec = [0,1,0,1,0,1]

    return postingList,classVec

def createVocabList(dataSet):

    vocabSet = set([])

    for document in dataSet:

        vocabSet = vocabSet | set(document)

    return list(vocabSet)

def setOfWords2Vec(vocabList, inputSet):

    returnVec = [0]*len(vocabList)

    for word in inputSet:

        if word in vocabList:

            returnVec[vocabList.index(word)] = 1

        else:

            print("the word: %s is not in my Vocabulary!" % word)

    return returnVec

def trainNB0(trainMatrix,trainCategory):

    numTrainDocs = len(trainMatrix)

    numWords = len(trainMatrix[0])

    pAbusive = sum(trainCategory)/float(numTrainDocs)

    p0Num = np.ones(numWords)

    p1Num = np.ones(numWords)

    p0Denom = 2.0

    p1Denom = 2.0

    for i in range(numTrainDocs):

        if(trainCategory[i] == 1):

            p1Num += trainMatrix[i]

            p1Denom += sum(trainMatrix[i])

        else:

            p0Num += trainMatrix[i]

            p0Denom += sum(trainMatrix[i])

    p1Vect = np.log(p1Num/p1Denom)

    p0Vect = np.log(p0Num/p0Denom)

    return p0Vect,p1Vect,pAbusive

def classifyNB(vec2Classify, p0Vec, p1Vec, pClass1):

    p1 = sum(vec2Classify * p1Vec) + np.log(pClass1)

    p0 = sum(vec2Classify * p0Vec) + np.log(1.0 - pClass1)

    if p1 > p0:

        return 1

    else:

        return 0

def bagOfWords2VecMN(vocabList, inputSet):

    returnVec = [0]*len(vocabList)

    for word in inputSet:

        if(word in vocabList):

            returnVec[vocabList.index(word)] += 1

    return returnVec

def testingNB():

    listOPosts,listClasses = loadDataSet()

    myVocabList = createVocabList(listOPosts)

    trainMat=[]

    for postinDoc in listOPosts:

        trainMat.append(setOfWords2Vec(myVocabList, postinDoc))

    p0V,p1V,pAb = trainNB0(np.array(trainMat),np.array(listClasses))

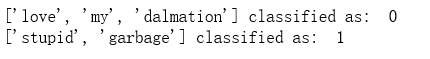
    testEntry = ['love', 'my', 'dalmation']

    thisDoc = np.array(setOfWords2Vec(myVocabList, testEntry))

    print(testEntry,'classified as: ',classifyNB(thisDoc,p0V,p1V,pAb))

    testEntry = ['stupid', 'garbage']

    thisDoc = np.array(setOfWords2Vec(myVocabList, testEntry))

    print(testEntry,'classified as: ',classifyNB(thisDoc,p0V,p1V,pAb))

testingNB()
import re

import numpy as np

def createVocabList(dataSet):

    vocabSet = set([])

    for document in dataSet:

        vocabSet = vocabSet | set(document)

    return list(vocabSet)

def bagOfWords2VecMN(vocabList, inputSet):

    returnVec = [0]*len(vocabList)

    for word in inputSet:

        if(word in vocabList):

            returnVec[vocabList.index(word)] += 1

    return returnVec

def trainNB0(trainMatrix,trainCategory):

    numTrainDocs = len(trainMatrix)

    numWords = len(trainMatrix[0])

    pAbusive = sum(trainCategory)/float(numTrainDocs)

    p0Num = np.ones(numWords)

    p1Num = np.ones(numWords)

    p0Denom = 2.0

    p1Denom = 2.0

    for i in range(numTrainDocs):

        if(trainCategory[i] == 1):

            p1Num += trainMatrix[i]

            p1Denom += sum(trainMatrix[i])

        else:

            p0Num += trainMatrix[i]

            p0Denom += sum(trainMatrix[i])

    p1Vect = np.log(p1Num/p1Denom)

    p0Vect = np.log(p0Num/p0Denom)

    return p0Vect,p1Vect,pAbusive

def textParse(bigString):

    listOfTokens = re.split(r'\W*', bigString)

    return [tok.lower() for tok in listOfTokens if len(tok) > 2]

def spamTest():

    docList=[]

    classList = []

    fullText =[]

    for i in range(1,26):

        wordList = textParse(open('D:\\LearningResource\\machinelearninginaction\\Ch04\\email\\spam\\%d.txt' % i).read())

        docList.append(wordList)

        fullText.extend(wordList)

        classList.append(1)

        wordList = textParse(open('D:\\LearningResource\\machinelearninginaction\\Ch04\\email\\ham\\%d.txt' % i).read())

        docList.append(wordList)

        fullText.extend(wordList)

        classList.append(0)

    vocabList = createVocabList(docList)

    trainingSet = list(np.arange(50))

    testSet=[]

    for i in range(10):

        randIndex = int(np.random.uniform(0,len(trainingSet)))

        testSet.append(trainingSet[randIndex])

        del(trainingSet[randIndex])

    trainMat=[]

    trainClasses = []

    for docIndex in trainingSet:

        trainMat.append(bagOfWords2VecMN(vocabList, docList[docIndex]))

        trainClasses.append(classList[docIndex])

    p0V,p1V,pSpam = trainNB0(np.array(trainMat),np.array(trainClasses))

    errorCount = 0

    for docIndex in testSet:

        wordVector = bagOfWords2VecMN(vocabList, docList[docIndex])

        if(classifyNB(np.array(wordVector),p0V,p1V,pSpam) != classList[docIndex]):

            errorCount += 1

            print("classification error",docList[docIndex])

    print('the error rate is: ',float(errorCount)/len(testSet))

spamTest()

吴裕雄 python 机器学习-NBYS(1)的更多相关文章
- 吴裕雄 python 机器学习-NBYS(2)
import matplotlib import numpy as np import matplotlib.pyplot as plt n = 1000 xcord0 = [] ycord0 = [ ...
- 吴裕雄 python 机器学习——分类决策树模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets from sklearn.model_s ...
- 吴裕雄 python 机器学习——回归决策树模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets from sklearn.model_s ...
- 吴裕雄 python 机器学习——线性判断分析LinearDiscriminantAnalysis
import numpy as np import matplotlib.pyplot as plt from matplotlib import cm from mpl_toolkits.mplot ...
- 吴裕雄 python 机器学习——逻辑回归
import numpy as np import matplotlib.pyplot as plt from matplotlib import cm from mpl_toolkits.mplot ...
- 吴裕雄 python 机器学习——ElasticNet回归
import numpy as np import matplotlib.pyplot as plt from matplotlib import cm from mpl_toolkits.mplot ...
- 吴裕雄 python 机器学习——Lasso回归
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets, linear_model from s ...
- 吴裕雄 python 机器学习——岭回归
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets, linear_model from s ...
- 吴裕雄 python 机器学习——线性回归模型
import numpy as np from sklearn import datasets,linear_model from sklearn.model_selection import tra ...
随机推荐
- JavaScript基础知识点学习记录
一.简介: JavaScript是一种基于对象和事件驱动并具有相对安全性的客户端脚本语言,同时也是一种广泛用于客户端Web开发的脚本语言,常用来给HTML网页添加动态功能,比如相应用户的各种操作. J ...
- 微信小程序笔记<七>视图层 —— wxml
微信小程序的视图层由 *.wxml 组成,wxml与html一样属于标签语言,但wxml与html的标签截然不一样. xwml特性 一.数据绑定 <!--wxml--> <view& ...
- 重识linux-SSH中的SFTP
重识linux-SSH中的SFTP 1 SFTP也是使用SSH的通道(port 22) 2 SFTP是linux系统自带的功能 3 连接上主流的ftp软件都支持sftp协议 比如flashfxp,fi ...
- SambaJava API
做一个 backup package net.jnas; import java.io.File; import java.io.FileInputStream; import java.io.Fil ...
- 转:ArcGIS中利用ArcMap将地理坐标系转换成投影坐标系(从WKID=4326到WKID=102100)
对于非地理专业的开发人员,对与这些生涩的概念,我们不一定都要了解,但是我们要理解,凡是以经纬度为单位的都是地理坐标系,因为它归根结底是一个椭球体,只不过各个国家为了反映该国家所在区域地球的真实形状,而 ...
- winform/timer控件/权限设置/三级联动
一.timer控件 组件--timer timer是一个线程,默认可以跨线程访问对象 属性:Enabled--可用性 Interval--间隔时间 Tick:间隔时间发生事件 二.三级联动 例: pu ...
- hive数据倾斜原因以及解决办法
何谓数据倾斜?数据倾斜指的是,并行处理的数据集 中,某一部分(如Spark的一个Partition)的数据显著多于其它部分,从而使得该部分的处理速度成为整个数据集处理的瓶颈. 表现为整体任务基本完成, ...
- flex学习笔记 显示数字步进
<?xml version="1.0" encoding="utf-8"?> <s:Application xmlns:fx="ht ...
- leetcode1004
class Solution: def getMax(self,B:'List[int]'): n = len(B) maxlen = 0 curlen = 0 for i in range (n): ...
- Mysql IN语句查询
语法: WHERE column IN (value1,value2,...) WHERE column NOT IN (value1,value2,...) 1.in 后面是记录集,如: selec ...