
《机器学习实战》AdaBoost算法(手稿+代码)
Adaboost:多个弱分类器组成一个强分类器,按照每个弱分类器的作用大小给予不同的权重 |
一.Adaboost理论部分
1.1 adaboost运行过程
注释:算法是利用指数函数降低误差,运行过程通过迭代进行。其中函数的算法怎么来的,你不用知道!当然你也可以尝试使用其它的函数代替指数函数,看看效果如何。
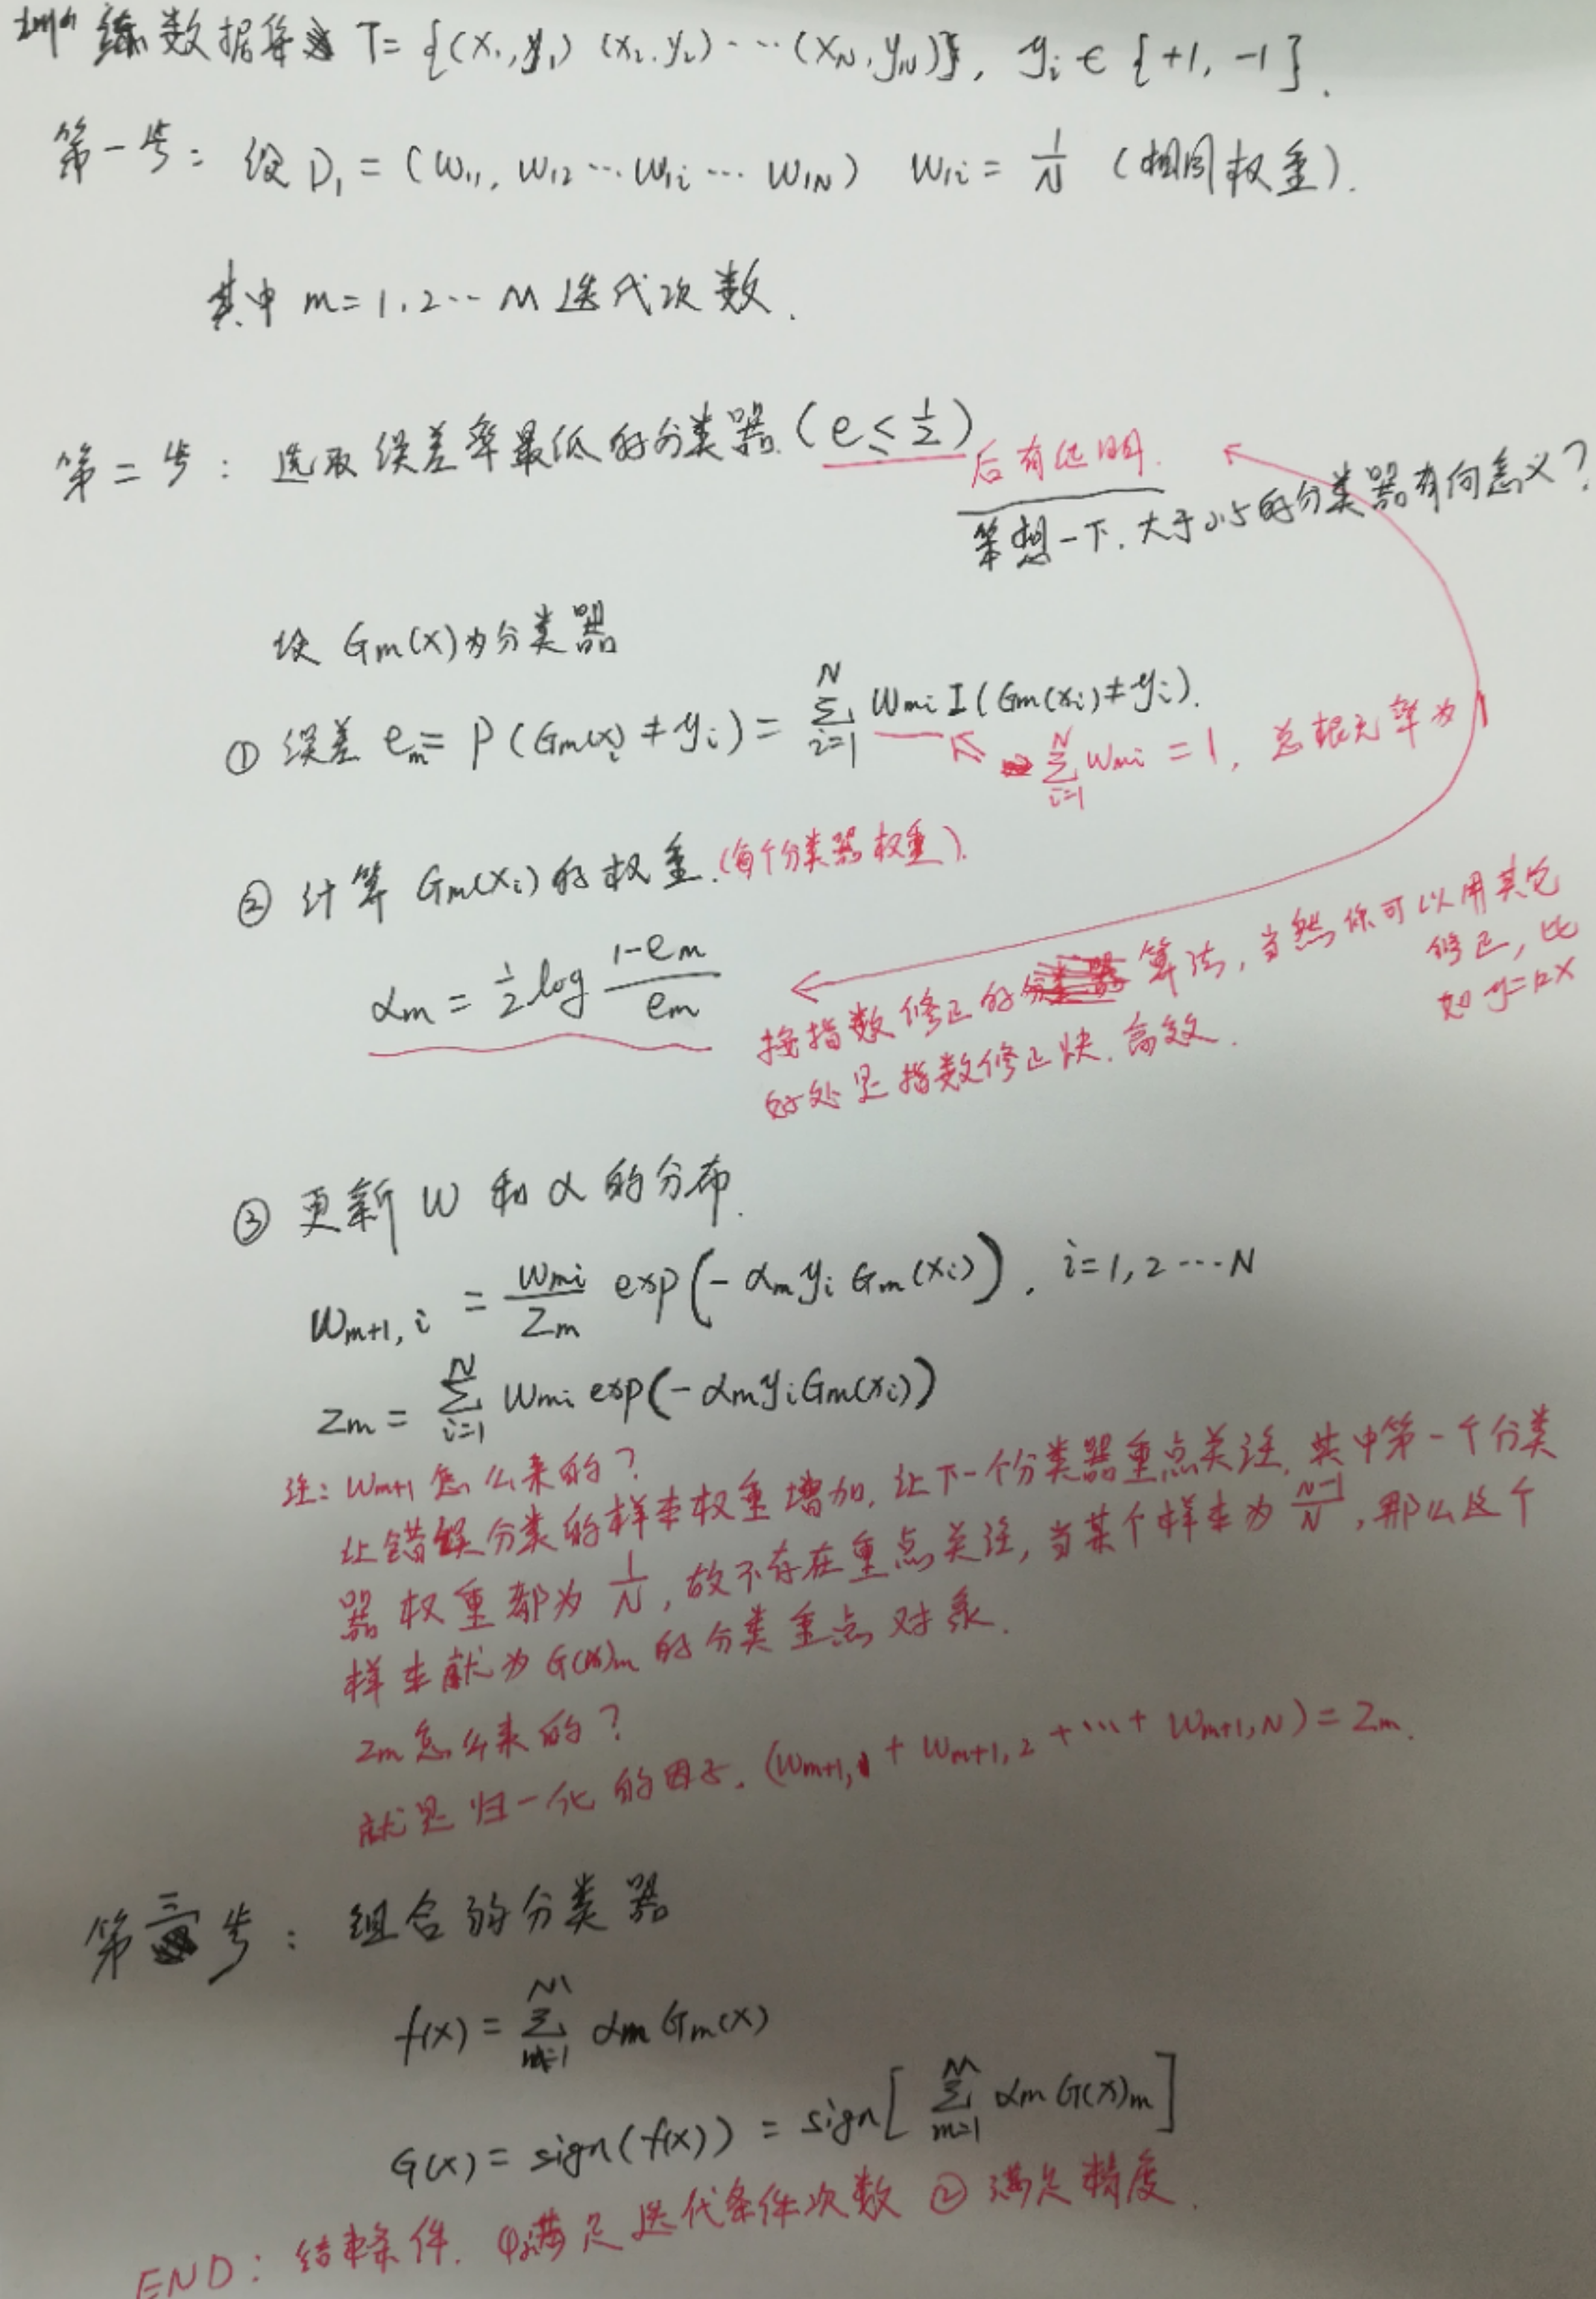
1.2 举例说明算法流程
略,花几分钟就可以看懂的例子。见:《统计学习方法》李航大大
博客都是借鉴(copy)李航博士的:http://blog.csdn.net/v_july_v/article/details/40718799 ,July算总结(copy)最好的吧!
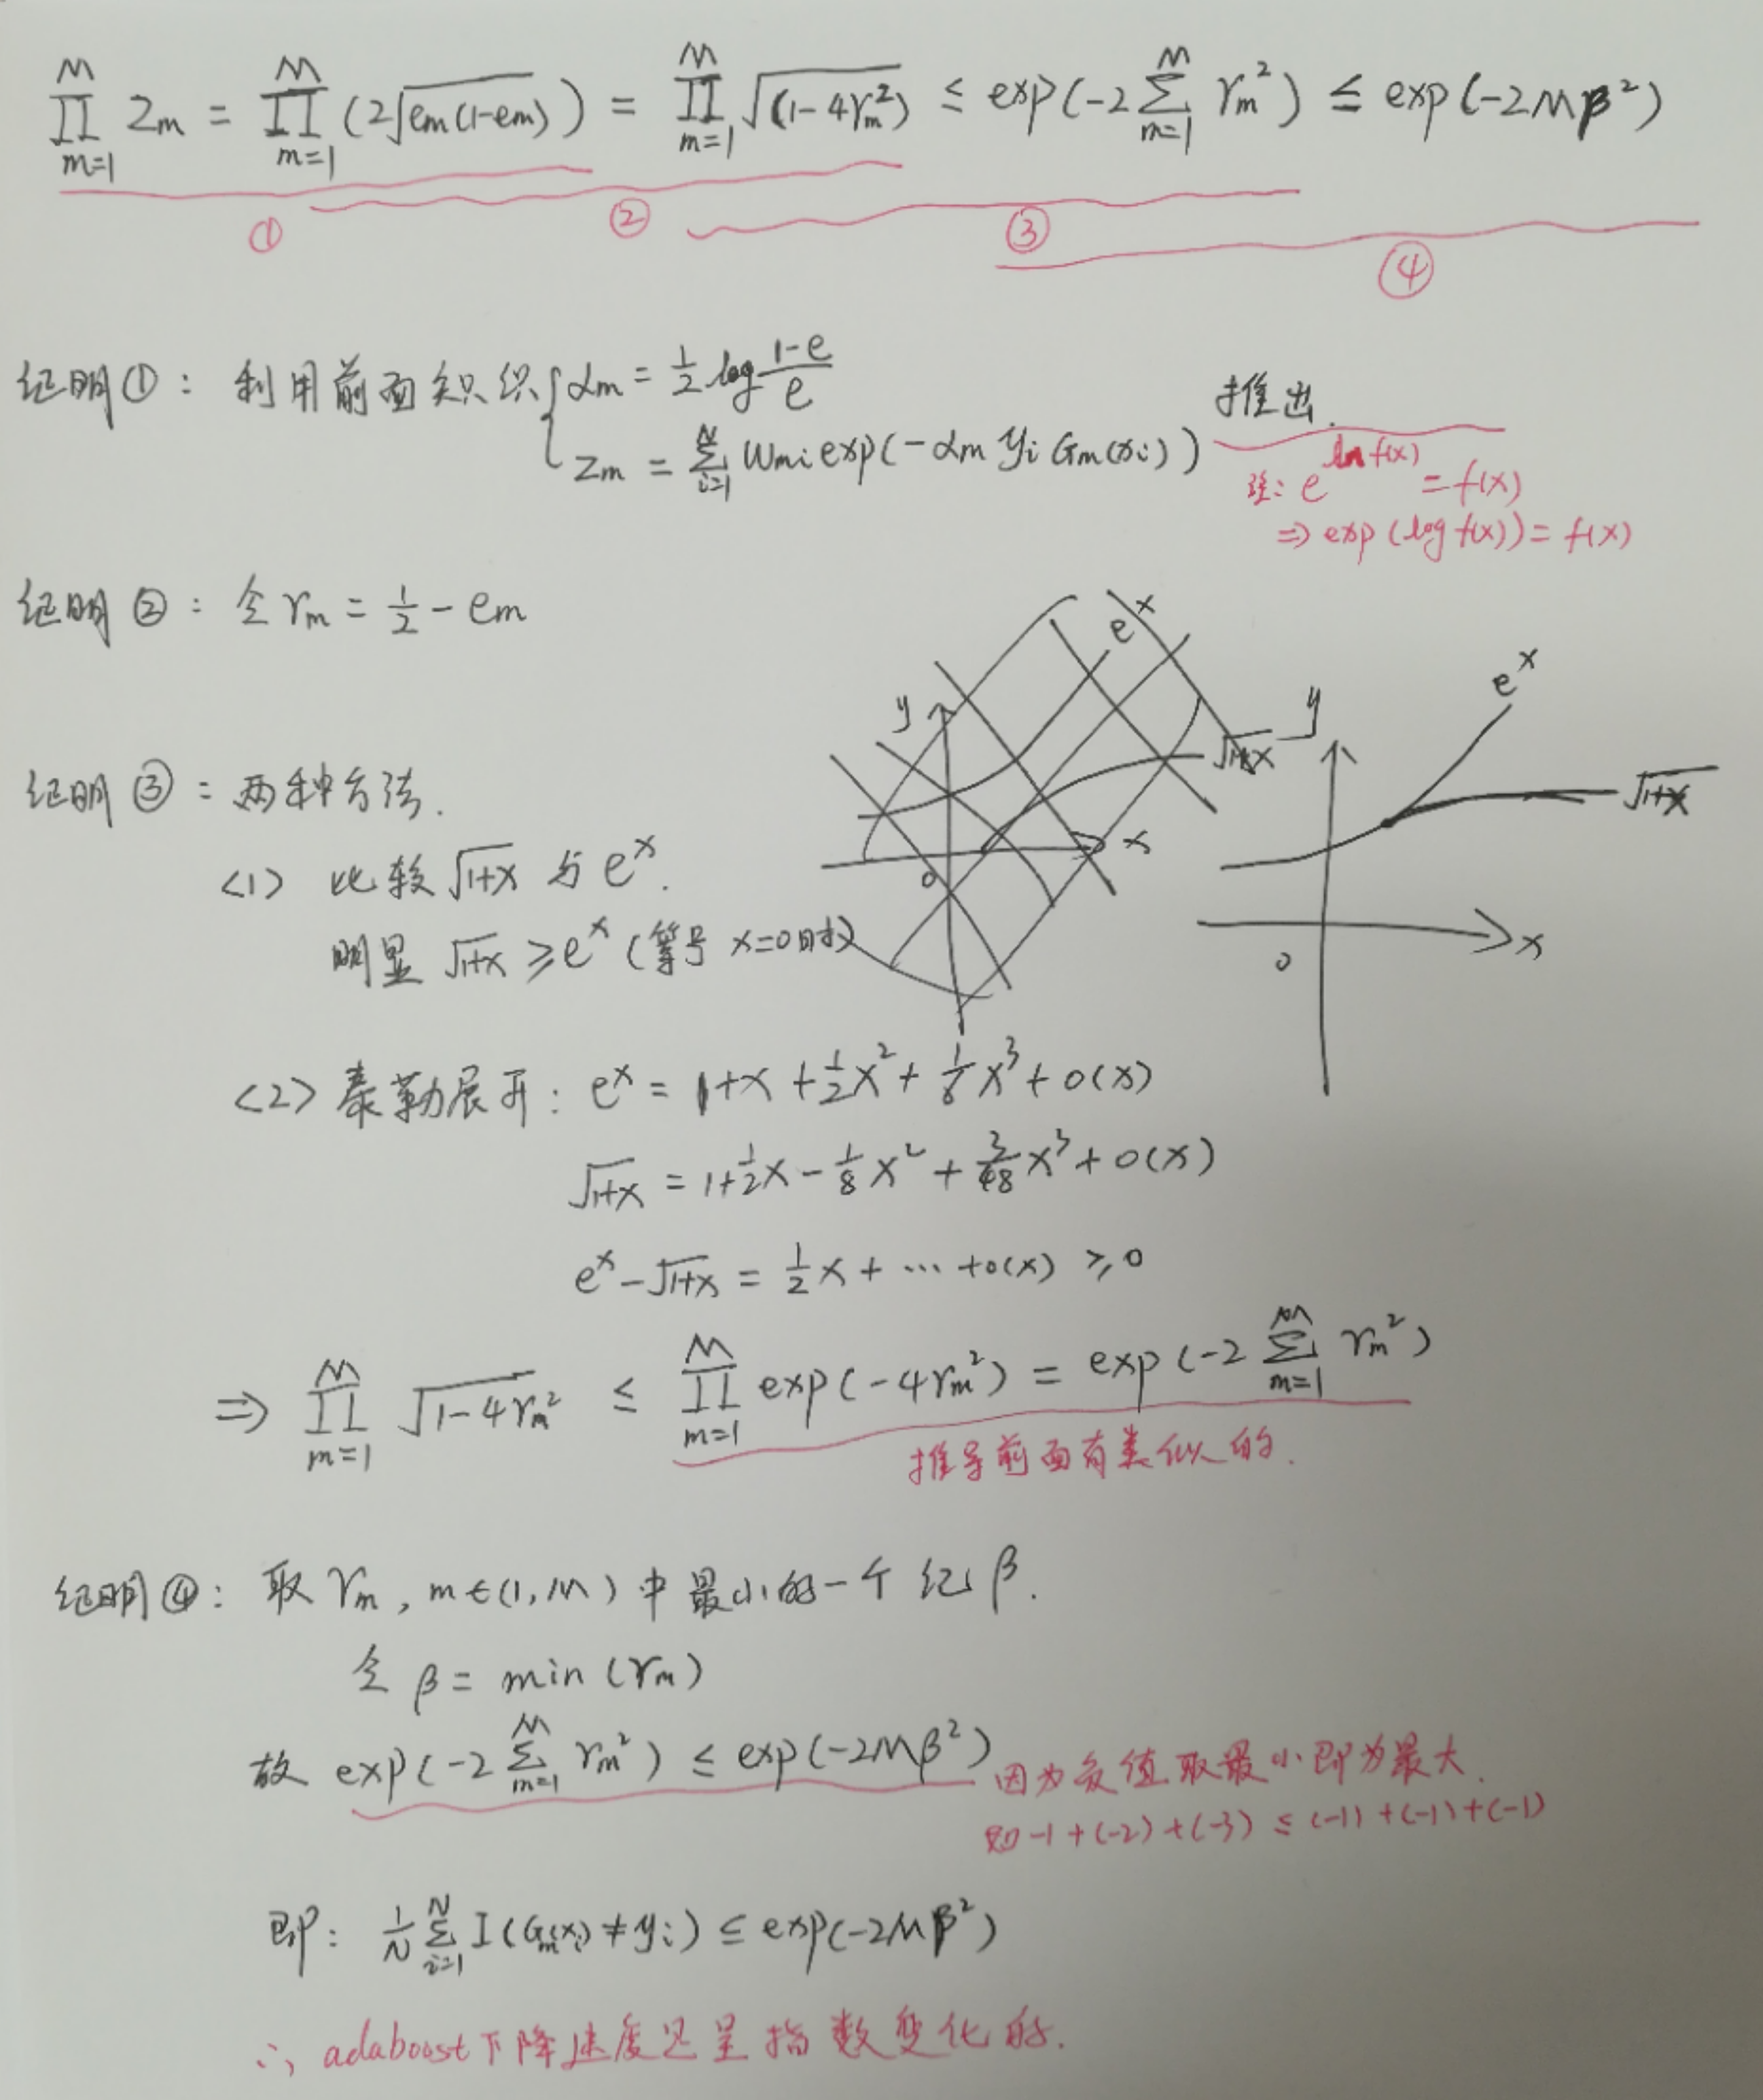
1.3 算法误差界的证明
注释:误差的上界限由Zm约束,然而Zm又是由Gm(xi)约束,所以选择适当的Gm(xi)可以加快误差的减小。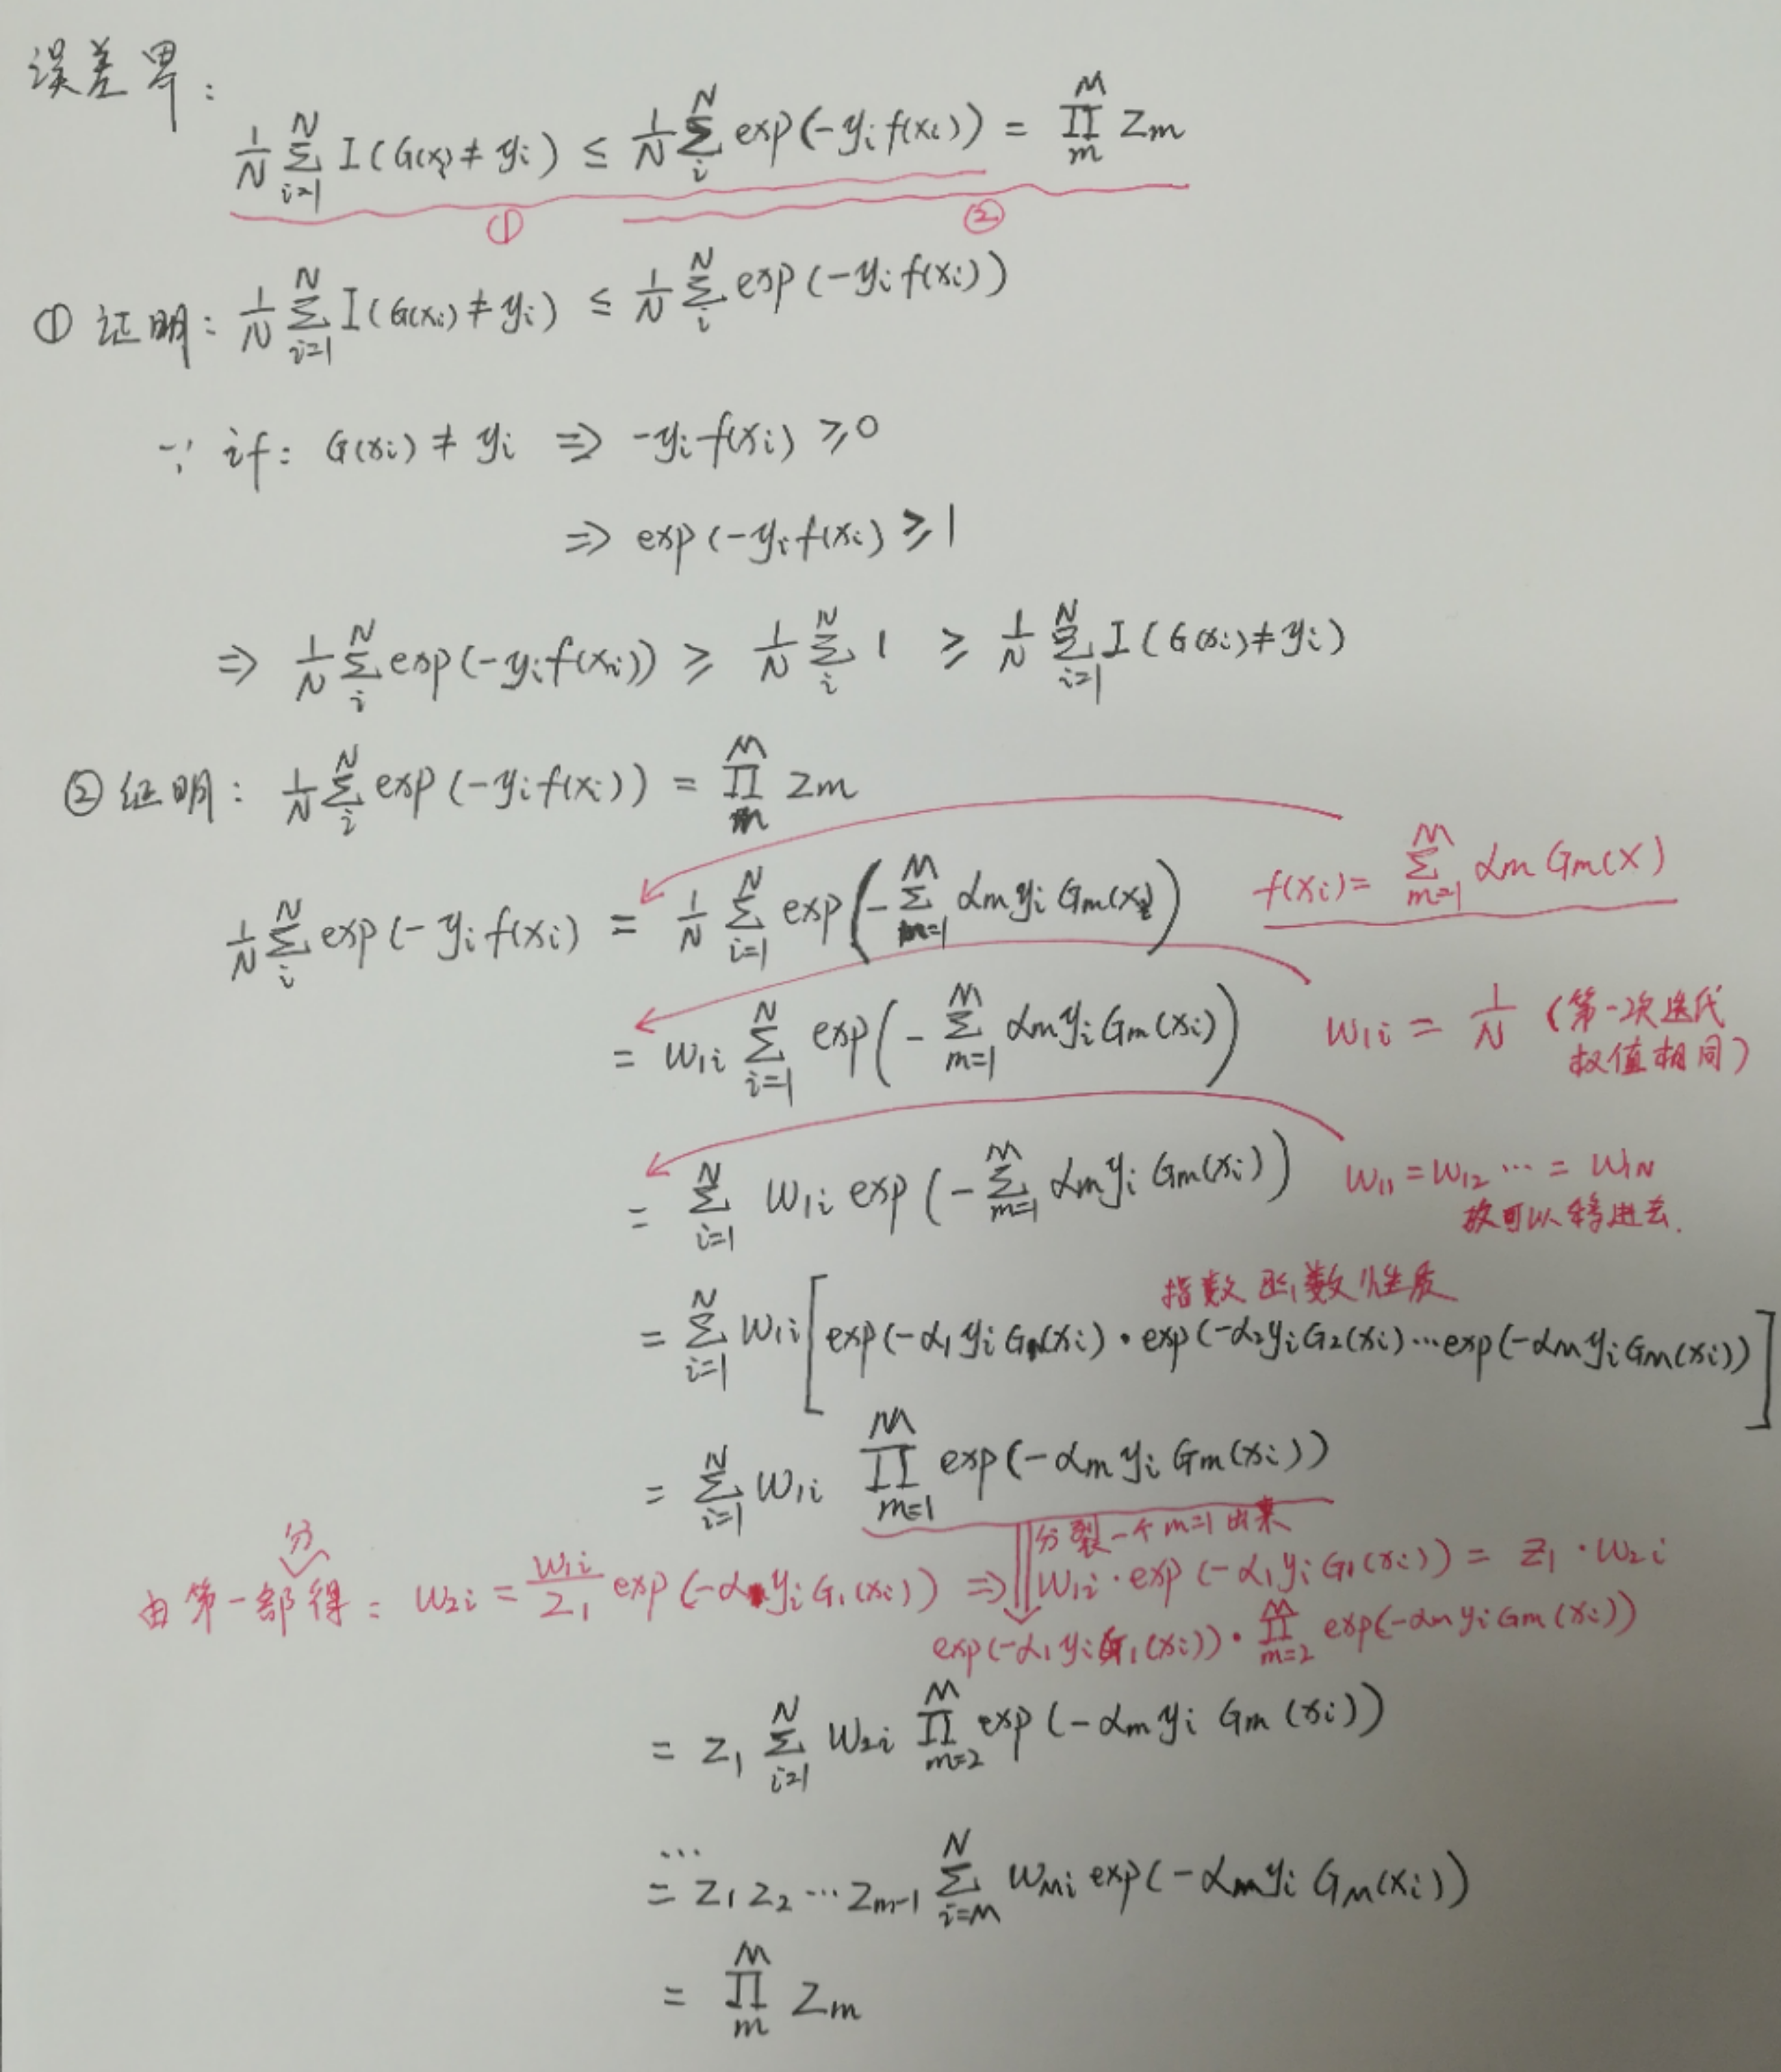
二.代码实现
注释:这里参考大神博客http://blog.csdn.net/guyuealian/article/details/70995333,举例子很详细。
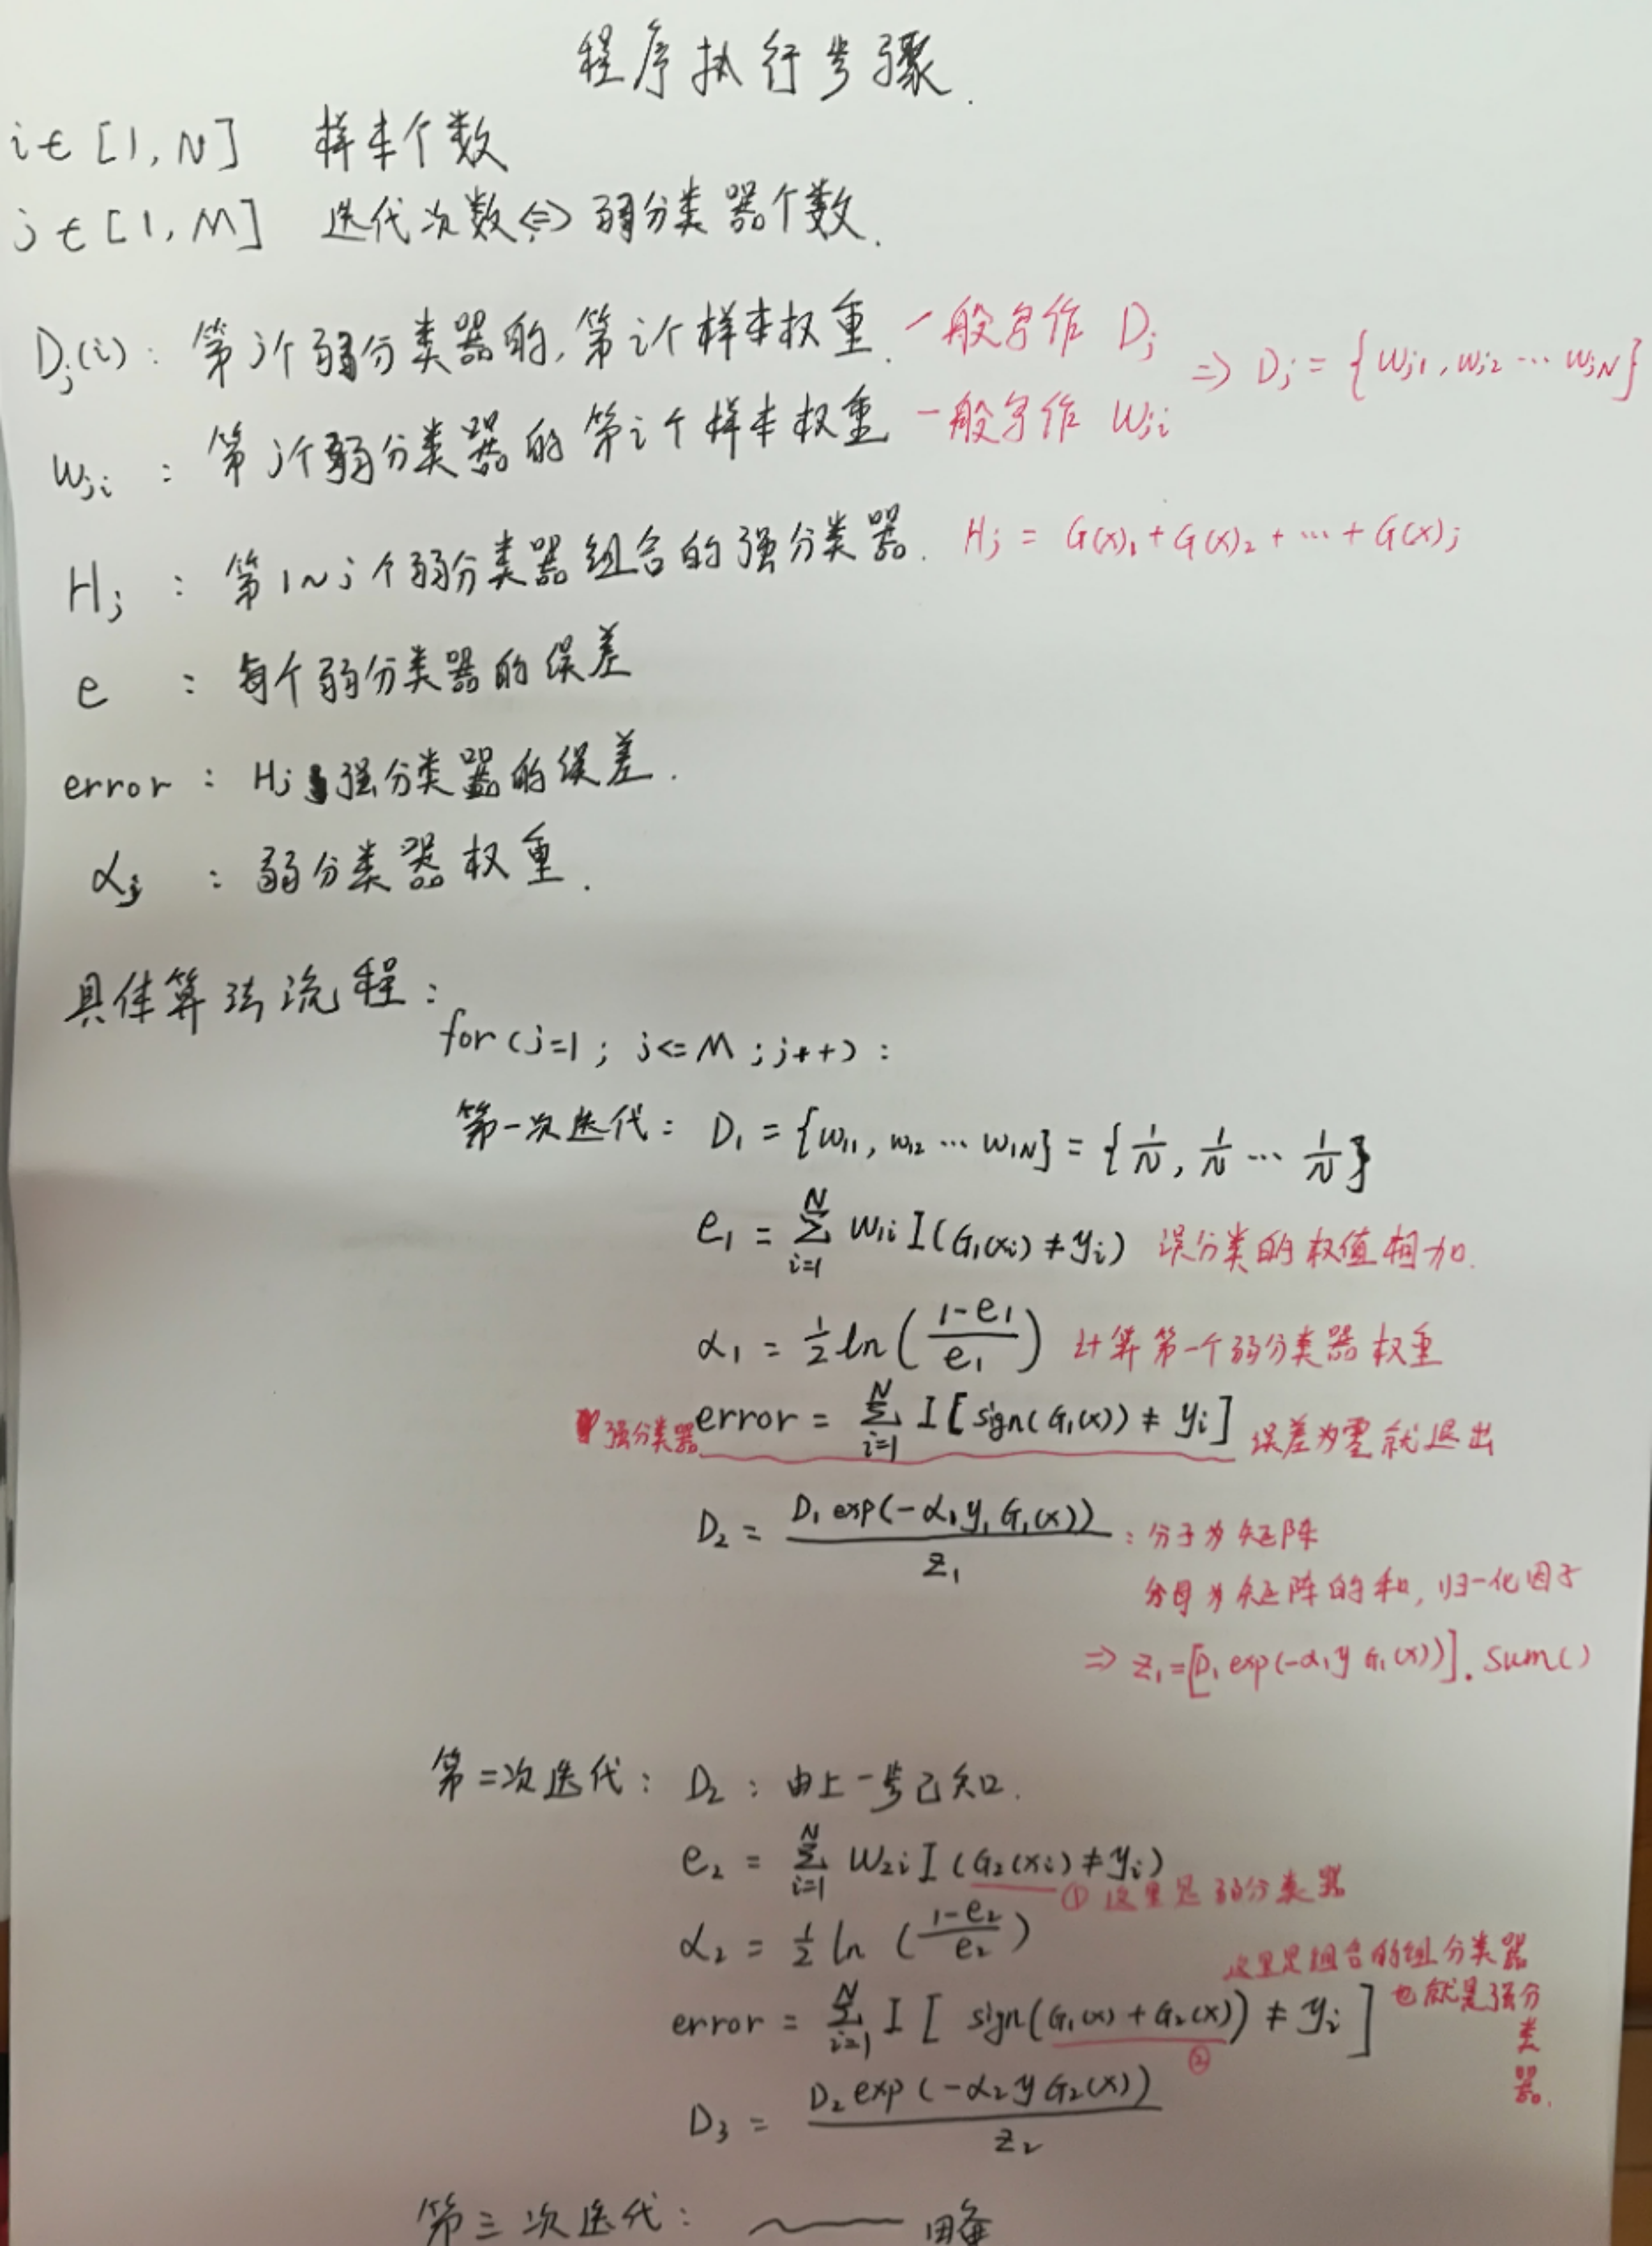
2.1程序流程图
2.2基本程序实现
注释:真是倒霉玩意,本来代码全部注释好了,突然Ubuntu奔溃了,全部程序就GG了。。。下面的代码就是官网的代码,部分补上注释。现在使用Deepin桌面版了,其它方面都比Ubuntu好,但是有点点卡。
 from numpy import *

 def loadDataSet(fileName):      #general function to parse tab -delimited floats

     numFeat = len(open(fileName).readline().split('\t')) #get number of fields

     dataMat = []; labelMat = []

     fr = open(fileName)

     for line in fr.readlines():

         lineArr =[]

         curLine = line.strip().split('\t')

         for i in range(numFeat-1):

             lineArr.append(float(curLine[i]))

         dataMat.append(lineArr)

         labelMat.append(float(curLine[-1]))

     return dataMat,labelMat

 def stumpClassify(dataMatrix,dimen,threshVal,threshIneq):#just classify the data

     retArray = ones((shape(dataMatrix)[0],1))

     if threshIneq == 'lt':

         retArray[dataMatrix[:,dimen] <= threshVal] = -1.0

     else:

         retArray[dataMatrix[:,dimen] > threshVal] = -1.0

     return retArray

 def buildStump(dataArr,classLabels,D):

     dataMatrix = mat(dataArr); labelMat = mat(classLabels).T

     m,n = shape(dataMatrix)

     numSteps = 10.0; bestStump = {}; bestClasEst = mat(zeros((m,1)))

     minError = inf #init error sum, to +infinity

     for i in range(n):#loop over all dimensions

         rangeMin = dataMatrix[:,i].min(); rangeMax = dataMatrix[:,i].max();

         stepSize = (rangeMax-rangeMin)/numSteps

         for j in range(-1,int(numSteps)+1):#loop over all range in current dimension

             for inequal in ['lt', 'gt']: #go over less than and greater than

                 threshVal = (rangeMin + float(j) * stepSize)

                 predictedVals = stumpClassify(dataMatrix,i,threshVal,inequal)#call stump classify with i, j, lessThan

                 errArr = mat(ones((m,1)))

                 errArr[predictedVals == labelMat] = 0

                 weightedError = D.T*errArr  #calc total error multiplied by D

                 #print "split: dim %d, thresh %.2f, thresh ineqal: %s, the weighted error is %.3f" % (i, threshVal, inequal, weightedError)

                 if weightedError < minError:

                     minError = weightedError

                     bestClasEst = predictedVals.copy()

                     bestStump['dim'] = i

                     bestStump['thresh'] = threshVal

                     bestStump['ineq'] = inequal

     return bestStump,minError,bestClasEst

 def adaBoostTrainDS(dataArr,classLabels,numIt=40):

     weakClassArr = []

     m = shape(dataArr)[0]

     D = mat(ones((m,1))/m)   #init D to all equal

     aggClassEst = mat(zeros((m,1)))

     for i in range(numIt):

         bestStump,error,classEst = buildStump(dataArr,classLabels,D)#build Stump

         #print "D:",D.T

         alpha = float(0.5*log((1.0-error)/max(error,1e-16)))#calc alpha, throw in max(error,eps) to account for error=0

         bestStump['alpha'] = alpha

         weakClassArr.append(bestStump)                  #store Stump Params in Array

         #print "classEst: ",classEst.T

         expon = multiply(-1*alpha*mat(classLabels).T,classEst) #exponent for D calc, getting messy

         D = multiply(D,exp(expon))                              #Calc New D for next iteration

         D = D/D.sum()

         #calc training error of all classifiers, if this is 0 quit for loop early (use break)

         aggClassEst += alpha*classEst

         #print "aggClassEst: ",aggClassEst.T

         aggErrors = multiply(sign(aggClassEst) != mat(classLabels).T,ones((m,1)))

         errorRate = aggErrors.sum()/m

         print ("total error: ",errorRate)

         if errorRate == 0.0: break

     return weakClassArr,aggClassEst

 def adaClassify(datToClass,classifierArr):

     dataMatrix = mat(datToClass)#do stuff similar to last aggClassEst in adaBoostTrainDS

     m = shape(dataMatrix)[0]

     aggClassEst = mat(zeros((m,1)))

     for i in range(len(classifierArr)):

         classEst = stumpClassify(dataMatrix,classifierArr[i]['dim'],\

                                  classifierArr[i]['thresh'],\

                                  classifierArr[i]['ineq'])#call stump classify

         aggClassEst += classifierArr[i]['alpha']*classEst

         #print aggClassEst

     return sign(aggClassEst)

 def plotROC(predStrengths, classLabels):

     import matplotlib.pyplot as plt

     cur = (1.0,1.0) #cursor

     ySum = 0.0 #variable to calculate AUC

     numPosClas = sum(array(classLabels)==1.0)#标签等于1的和(也等于个数)

     yStep = 1/float(numPosClas); xStep = 1/float(len(classLabels)-numPosClas)

     sortedIndicies = predStrengths.argsort()#get sorted index, it's reverse

     sortData = sorted(predStrengths.tolist()[0])

     fig = plt.figure()

     fig.clf()

     ax = plt.subplot(111)

     #loop through all the values, drawing a line segment at each point

     for index in sortedIndicies.tolist()[0]:

         if classLabels[index] == 1.0:

             delX = 0; delY = yStep;

         else:

             delX = xStep; delY = 0;

             ySum += cur[1]

         #draw line from cur to (cur[0]-delX,cur[1]-delY)

         ax.plot([cur[0],cur[0]-delX],[cur[1],cur[1]-delY], c='b')

         cur = (cur[0]-delX,cur[1]-delY)

     ax.plot([0,1],[0,1],'b--')

     plt.xlabel('False positive rate'); plt.ylabel('True positive rate')

     plt.title('ROC curve for AdaBoost horse colic detection system')

     ax.axis([0,1,0,1])

     plt.show()

     print ("the Area Under the Curve is: ",ySum*xStep)
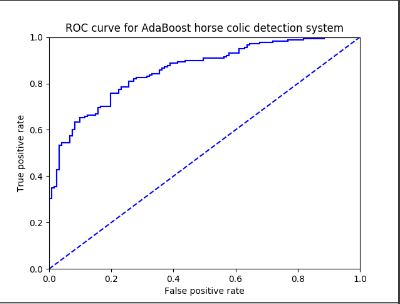
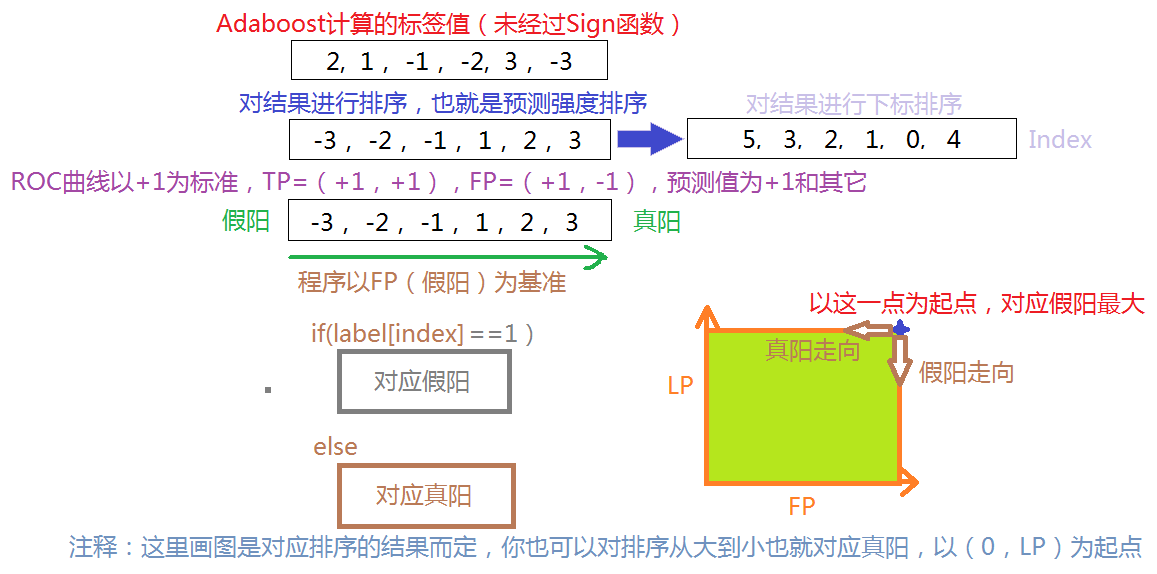
注释:重点说明一下非均衡分类的图像绘制问题,想了很久才想明白!
都是相对而言的,其中本文说的曲线在左上方就为好,也是相对而言的,看你怎么定义个理解!
参考文献:
《统计学习方法》李航
http://blog.csdn.net/v_july_v/article/details/40718799没有书的就看这个大神的博客,基本是上面那本数的原版
《机器学习实战》AdaBoost算法(手稿+代码)的更多相关文章
- 机器学习之AdaBoost原理与代码实现
AdaBoost原理与代码实现 本文系作者原创,转载请注明出处: https://www.cnblogs.com/further-further-further/p/9642899.html 基本思路 ...
- Adaboost算法及其代码实现
. . Adaboost算法及其代码实现 算法概述 AdaBoost(adaptive boosting),即自适应提升算法. Boosting 是一类算法的总称,这类算法的特点是通过训练若干弱分类器 ...
- 机器学习实战-AdaBoost
1.概念 从若学习算法出发,反复学恶习得到一系列弱分类器(又称基本分类器),然后组合这些弱分类器构成一个强分类器.简单说就是假如有一堆数据data,不管是采用逻辑回归还是SVM算法对当前数据集通过分类 ...
- 机器学习之Adaboost算法原理
转自:http://www.cnblogs.com/pinard/p/6133937.html 在集成学习原理小结中,我们讲到了集成学习按照个体学习器之间是否存在依赖关系可以分为两类,第一个是个体学习 ...
- 机器学习实战 logistic回归 python代码
# -*- coding: utf-8 -*- """ Created on Sun Aug 06 15:57:18 2017 @author: mdz "&q ...
- 《机器学习实战》学习笔记第七章 —— AdaBoost元算法
主要内容: 一.提升方法与AdaBoost算法的简介 二.AdaBoost算法 三.代码解释 一.提升方法与AdaBoost算法的简介 1.提升方法:从弱学习算法出发,反复学习,得到一系列弱分类器(又 ...
- 机器学习&深度学习基础(机器学习基础的算法概述及代码)
参考:机器学习&深度学习算法及代码实现 Python3机器学习 传统机器学习算法 决策树.K邻近算法.支持向量机.朴素贝叶斯.神经网络.Logistic回归算法,聚类等. 一.机器学习算法及代 ...
- 学习笔记之机器学习实战 (Machine Learning in Action)
机器学习实战 (豆瓣) https://book.douban.com/subject/24703171/ 机器学习是人工智能研究领域中一个极其重要的研究方向,在现今的大数据时代背景下,捕获数据并从中 ...
- 一个关于AdaBoost算法的简单证明
下载本文PDF格式(Academia.edu) 本文给出了机器学习中AdaBoost算法的一个简单初等证明,需要使用的数学工具为微积分-1. Adaboost is a powerful algori ...
- 《机器学习实战》学习笔记第十三章 —— 利用PCA来简化数据
相关博文: 吴恩达机器学习笔记(八) —— 降维与主成分分析法(PCA) 主成分分析(PCA)的推导与解释 主要内容: 一.向量內积的几何意义 二.基的变换 三.协方差矩阵 四.PCA求解 一.向量內 ...
随机推荐
- RedHat6.5安装zookeeper集群
版本号: Redhat6.5 zookeeper-3.4.6 JDK1.8 zookeeper下载 官网下载地址:https://mirrors.tuna.tsinghua.edu.cn/apac ...
- DLL何时需共享内存管理器
Delphi创建DLL时,IDE自动生成的文档中写得很清楚,当在DLL中以动态数组或String做为参数或返回值时(即RTL自动维护的数据类型),请在每个工程文件的第一个单元加上ShareMem.这样 ...
- plsql 创建表空间、用户、赋予权限
plsql 创建表空间.用户.赋予权限 --用户名:testuser --密码:bzhs!*6 --1.创建表空间--用SYSTEM用户登陆数据库,执行下面语句创建表空间CREATE TABLESPA ...
- CreateUserWizard控件的使用
“CreateUserWizard”控件用于收集潜在用户所提供的信息.默认情况下,“CreateUserWizard”控件会将新用户添加到 ASP.NET 成员身份系统中.有关 ASP.NET 成员资 ...
- 前端模拟后台返回数据之Mockjs
一.官方文档: https://github.com/nuysoft/Mock/wiki/Syntax-Specification 例子:http://mockjs.com/examples.html ...
- bzoj3491: PA2007 Subsets
Description 有一个集合U={1,2,…,n),要从中选择k个元素作为一个子集A.若a∈A,则要有a*X不属于A,x是一个给定的数.求可选方案对M取模后的值. 1< = N< = ...
- Java学习——this、this()、super 和 super()的使用
编写程序:说明 this.super 和 super()的用法.程序首先定义 Point(点)类,然后创建点的子类 Line(线)),最后通过 LX7_3 类输出线段的长度. package Pack ...
- 学习笔记之1001 Inventions That Changed the World
1001 Inventions That Changed the World: Jack Challoner: 9780764161360: Amazon.com: Books https://www ...
- DevOps安装、部署持续集成
1.重启docker服务,开启iptables转发功能 # systemctl start docker # vi /etc/sysctl.conf # sysctl -p [root@localho ...
- 阿里云线上ROS静态路由转发,有大坑。
原因见上去,阿里云不支持VPC中转流量,VPC1和VPC2都在国内,VPC3在香港,如果按阿里云的做法,必须付费2次国际隧道的钱,才可以实现三个VPC互通.明显很浪费钱. 所以我们只能在三个VPC,各 ...