
Spark SQL 小文件问题处理
在生产中,无论是通过SQL语句或者Scala/Java等代码的方式使用Spark SQL处理数据,在Spark SQL写数据时,往往会遇到生成的小文件过多的问题,而管理这些大量的小文件,是一件非常头疼的事情。
大量的小文件会影响Hadoop集群管理或者Spark在处理数据时的稳定性:
1. Spark SQL写Hive或者直接写入HDFS,过多的小文件会对NameNode内存管理等产生巨大的压力,会影响整个集群的稳定运行
2. 容易导致task数过多,如果超过参数spark.driver.maxResultSize的配置(默认1g),会抛出类似如下的异常,影响任务的处理
Caused by: org.apache.spark.SparkException: Job aborted due to stage failure: Total size of serialized results of 478 tasks (2026.0 MB) is bigger than spark.driver.maxResultSize (1024.0 MB)
当然可以通过调大spark.driver.maxResultSize的默认配置来解决问题,但如果不能从源头上解决小文件问题,以后还可能遇到类似的问题。
此外,Spark在处理任务时,一个分区分配一个task进行处理,多个分区并行处理,虽然并行处理能够提高处理效率,但不是意味着task数越多越好。如果数据量不大,过多的task运行反而会影响效率。
下面通过一个例子,Spark SQL写数据时,导致产生分区数"剧增"的典型场景,通过分区数"剧增",以及Spark中task数和分区数的关系等,来倒推小文件过多的可能原因(这里的分区数是指生成的DataSet/RDD的分区数,不是Hive分区表的分区概念):
1. 现象
1) 对表test_tab进行写入操作

2) t1的分区数是100,t2的分区数是200,union all后生成的tmp分区数是300

3) test_tab产生的小文件数基本也在300左右

select * from t1 union all select * from t2 as tmp;insert overwrite table test_tab select * from tmp;
2. 分析
1)执行上述insert操作时的分区并行度,主要受tmp的分区数(对应一个DataSet)影响,
2)tmp的分区数主要受t1、t2以及union all的影响
3)暂且不考虑t1或t2是物理表还是经过其他处理生成的临时表,它们的分区数是确定的,这里主要看经过union all处理后,生成的tmp的分区数和t1、t2的分区数有何关系?
4)Spark SQL语句中的union all对应到DataSet中即为unionAll算子,底层调用union算子
在之前的文章《重要|Spark分区并行度决定机制》中已经对Spark RDD中的union算子对union产生的新的RDD的分区数是如何受被union的多个RDD的影响的,做过详细介绍,这里直接给出结论:
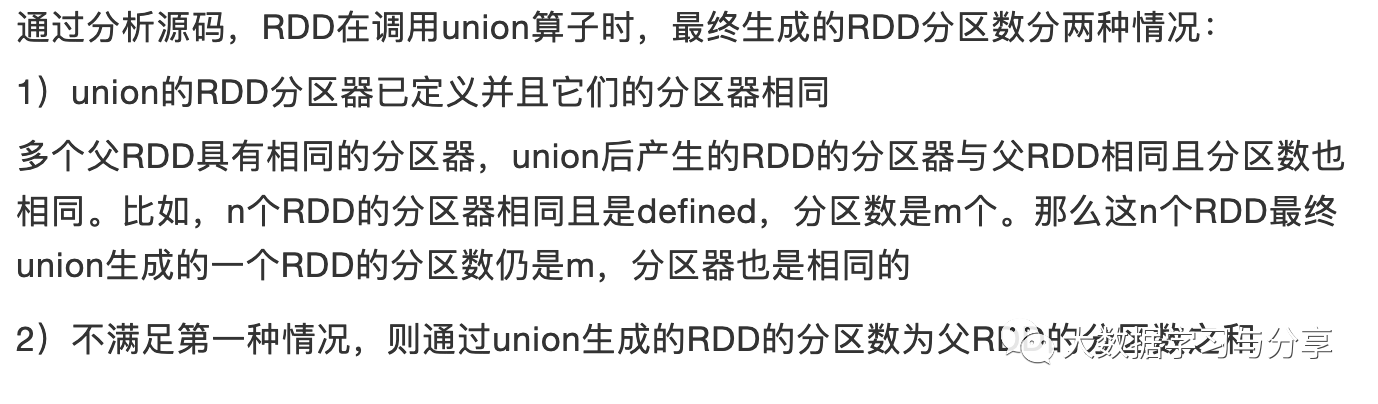
同样的这种机制也可以套用到Spark SQL中的DataSet上,那么就很好解释了tmp的分区数为什么等于t1和t2的分区数的和。
最后,Spark中一个task处理一个分区从而也会影响最终生成的文件数。
当然上述只是以Spark SQL中的一个场景阐述了小文件产生过多的原因之一(分区数过多)。在数仓建设中,产生小文件过多的原因有很多种,比如:
1. 流式处理中,每个批次的处理执行保存操作也会产生很多小文件
2. 为了解决数据更新问题,同一份数据保存了不同的几个状态,也容易导致文件数过多
那么如何解决这种小文件的问题呢?
1. 通过repartition或coalesce算子控制最后的DataSet的分区数
注意repartition和coalesce的区别,具体可以参考文章《重要|Spark分区并行度决定机制》
2. 将Hive风格的Coalesce and Repartition Hint 应用到Spark SQL需要注意这种方式对Spark的版本有要求,建议在Spark2.4.X及以上版本使用,示例:
INSERT ... SELECT /*+ COALESCE(numPartitions) */ ...

INSERT ... SELECT /*+ REPARTITION(numPartitions) */ ...
3. 小文件定期合并
可以定时通过异步的方式针对Hive分区表的每一个分区中的小文件进行合并操作
上述只是给出3种常见的解决办法,并且要结合实际用到的技术和场景去具体处理,比如对于HDFS小文件过多,也可以通过生成HAR 文件或者Sequence File来解决。
推荐文章:
Spark存储Parquet数据到Hive,对map、array、struct字段类型的处理Spark SQL解析查询parquet格式Hive表获取分区字段和查询条件
Spark和Spring整合处理离线数据Spark流式状态管理
关注微信公众号:大数据学习与分享,获取更对技术干货
Spark SQL 小文件问题处理的更多相关文章
- hadoop spark合并小文件
一.输入文件类型设置为 CombineTextInputFormat hadoop job.setInputFormatClass(CombineTextInputFormat.class) sp ...
- Spark SQL如何选择join策略
前言 众所周知,Catalyst Optimizer是Spark SQL的核心,它主要负责将SQL语句转换成最终的物理执行计划,在一定程度上决定了SQL执行的性能. Catalyst在由Optimiz ...
- spark SQL (四)数据源 Data Source----Parquet 文件的读取与加载
spark SQL Parquet 文件的读取与加载 是由许多其他数据处理系统支持的柱状格式.Spark SQL支持阅读和编写自动保留原始数据模式的Parquet文件.在编写Parquet文件时,出于 ...
- Spark SQL之External DataSource外部数据源(二)源代码分析
上周Spark1.2刚公布,周末在家没事,把这个特性给了解一下,顺便分析下源代码,看一看这个特性是怎样设计及实现的. /** Spark SQL源代码分析系列文章*/ (Ps: External Da ...
- spark sql/hive小文件问题
针对hive on mapreduce 1:我们可以通过一些配置项来使Hive在执行结束后对结果文件进行合并: 参数详细内容可参考官网:https://cwiki.apache.org/conflue ...
- Spark:spark df插入hive表后小文件数量多,如何合并?
在做spark开发过程中,时不时的就有可能遇到租户的hive库目录下的文件个数超出了最大限制问题. 一般情况下通过hive的参数设置: val conf = new SparkConf().setAp ...
- 针对小文件的spark wholeTextFiles()
场景:推送过来的数据文件数量很多,并且每个只有10-30M的大小 spark读取hdfs一般都是用textfile(),但是对于这种情况,如果使用textFile默认产生的分区数将与文件数目一致,产生 ...
- 通过Spark SQL关联查询两个HDFS上的文件操作
order_created.txt 订单编号 订单创建时间 -- :: -- :: -- :: -- :: -- :: order_picked.txt 订单编号 订单提取时间 -- :: ...
- Spark使用CombineTextInputFormat缓解小文件过多导致Task数目过多的问题
目前平台使用Kafka + Flume的方式进行实时数据接入,Kafka中的数据由业务方负责写入,这些数据一部分由Spark Streaming进行流式计算:另一部分数据则经由Flume存储至HDFS ...
随机推荐
- 学习笔记:[算法分析]数据结构与算法Python版
什么是算法分析 对比程序,还是算法? ❖如何对比两个程序? 看起来不同,但解决同一个问题的程序,哪个" 更好"? ❖程序和算法的区别 算法是对问题解决的分步描述 程序则是采用某种编 ...
- 追星女孩必备!使用Camtasia制作爱豆视频
制作爱豆视频,我用得比较多的是Camtasia(Windows)教程录制.因为这款软件操作简单,功能强大,用起来相当顺手呢.而且更重要的是,Camtasia有录屏功能,电脑存量不足的情况下,真的很好用 ...
- FL Studio进行侧链的三种方式(上)
在本系列教程中,我们将学习如何在FL Studio中进行侧链.侧链是一种信号处理技术,通过它我们可以使用一个信号波形的振幅(音量)来控制另一个信号的某些参数.在电子音乐中,例如trance,house ...
- python批量生成SQL语句
1,首先写一条能运行成功插入SQL的语句 INSERT INTO sign_guest(realname,phone,email,sign,event_id)VALUES("jack&quo ...
- 分析 5种分布式事务方案,还是选了阿里的 Seata(原理 + 实战)
好长时间没发文了,最近着实是有点忙,当爹的第 43 天,身心疲惫.这又赶上年底,公司冲 KPI 强制技术部加班到十点,晚上孩子隔两三个小时一醒,基本没睡囫囵觉的机会,天天处于迷糊的状态,孩子还时不时起 ...
- kafka producer 概要(看源码前,最好能掌握)
kafakproducer概要(看源码前,最好能理解) 摘要 kafak 被设计用来作为一个统一的平台来处理庞大的数据的实时工具,在设计上有诸多变态的要求 它必须具有高吞吐量才能支持大量事件流 ...
- HTML+JavaScript画函数图像
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- Mybatis【2.3】-- Mybatis一定要使用commit才能成功修改数据么?
代码直接放在Github仓库[https://github.com/Damaer/Mybatis-Learning],mybatis-02可直接运行,就不占篇幅了. 为什么我们有时候不使用commit ...
- 【mq读书笔记】Index索引文件
1.IndexHeader头部,40字节,记录IndexFile的统计信息: begainTimestamp:该索引文件中包含消息的最小存储时间 endTimestamp:该索引文件中包含消息的最大存 ...
- 领域设计:Entity与VO
本文探讨如下内容: 什么是状态 什么是标识 什么是Entity 什么是VO(ValueObject) 在设计中如何识别Entity和VO 要理解Entity和VO,需要先理解两个概念:「状态」和「标识 ...