
记录一次Flink作业异常的排查过程
最近2周开始接手apache flink全链路监控数据的作业,包括指标统计,业务规则匹配等逻辑,计算结果实时写入elasticsearch. 昨天遇到生产环境有作业无法正常重启的问题,我负责对这个问题进行排查跟进。
第一步,基础排查
首先拿到jobmanager和taskmanager的日志,我从taskmanager日志中很快发现2个基础类型的报错,一个是npe,一个是索引找不到的异常
elasticsearch sinker在执行写入数据的前后提供回调接口让作业开发人员对异常或者成功写入进行处理,如果在处理异常过程中有异常抛出,那么框架会让该task失败,导致作业重启。
npe很容易修复,索引找不到是创建索引的服务中的一个小bug,这些都是小问题。
重点是在日志中我看到另一个错误:
java.lang.OutOfMemoryError: unable to create new native thread

	at java.lang.Thread.start0(Native Method)

	at java.lang.Thread.start(Unknown Source)

	at org.apache.flink.runtime.io.network.api.writer.RecordWriter.<init>(RecordWriter.java:122)

	at org.apache.flink.runtime.io.network.api.writer.RecordWriter.createRecordWriter(RecordWriter.java:321)

	at org.apache.flink.streaming.runtime.tasks.StreamTask.createRecordWriter(StreamTask.java:1202)

	at org.apache.flink.streaming.runtime.tasks.StreamTask.createRecordWriters(StreamTask.java:1170)

	at org.apache.flink.streaming.runtime.tasks.StreamTask.<init>(StreamTask.java:212)

	at org.apache.flink.streaming.runtime.tasks.StreamTask.<init>(StreamTask.java:190)

	at org.apache.flink.streaming.runtime.tasks.OneInputStreamTask.<init>(OneInputStreamTask.java:52)

	at sun.reflect.GeneratedConstructorAccessor4.newInstance(Unknown Source)

	at sun.reflect.DelegatingConstructorAccessorImpl.newInstance(Unknown Source)

	at java.lang.reflect.Constructor.newInstance(Unknown Source)

	at org.apache.flink.runtime.taskmanager.Task.loadAndInstantiateInvokable(Task.java:1405)

	at org.apache.flink.runtime.taskmanager.Task.run(Task.java:689)

	at java.lang.Thread.run(Unknown Source)
这种异常,一般是nproc设置太小导致的,或者物理内存耗尽,检查完ulimit和内存,发现都很正常,这就比较奇怪了。
第二步、分析jstack和jmap
perfma有一个产品叫xland,我也是第一次使用,不得不说,确实牛逼,好用!
首先把出问题的taskmanager的线程栈信息和内存dump出来,具体命令:
jstatck pid > 生成的文件名

jmap -dump:format=b,file=生成的文件名 进程号
接着把这两个文件导入xland,xland可以直接看到线程总数,可以方便搜索统计线程数、实例个数等等
最先发现的问题是这个taskmanager 线程总数竟然有17000+,这个数字显然有点大,这个时候我想看一下,哪一种类型的线程比较大,xland可以很方便的搜索,统计,这时候我注意到有一种类型的线程非常多,总数15520
更上层的调用信息看不到了,只看到来自apache http client,根据作业流程,首先想到的就是es sinker的RestHighLevelClient用到这个东西
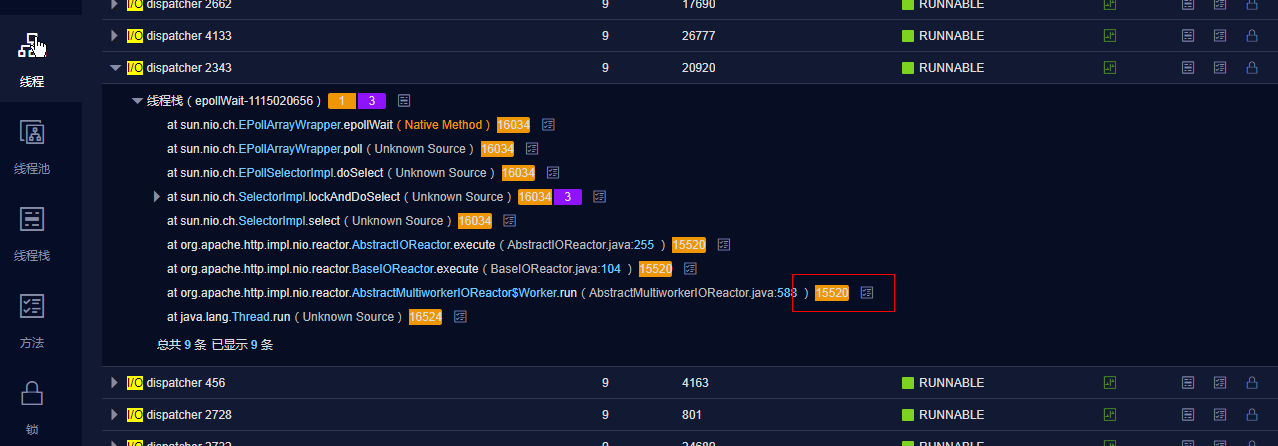
那么我们在xland中统计RestHighLevelClient对象个数,发现有几百个,很显然这里有问题
第三步、定位具体问题
有了前面xland的帮助,我们很容易定位到是esclient出了问题
在我们的作业里面有2个地方用到了es client,一个是es sinker,es sinker使用的就是RestHighLevelClient,另一个是我们同学自己写的一个es client,同样是使用RestHighLevelClient,在es sinker的ElasticsearchSinkFunction中单独构造,用于在写入es前,先搜索一些东西拿来合并,还做了cache
1、怀疑RestHighLevelClient bug
我们通过一个测试,来验证是不是RestHighLevelClient的问题
启动一个单纯使用es sinker的job,调整并发度,观察前面出现较多的
I/O dispatcher线程的个数,最后发现单个es sinker也会有240+个
I/O dispatcher线程,通过调整并发,所有taskmanager的
I/O dispatcher线程总数基本和并发成正向比例
停掉写es作业,此时所有taskmanager是不存在I/O dispatcher线程的
看起来I/O dispatcher那种线程数量大,似乎是“正常的”
2、杀掉作业,观察线程是否被正常回收
杀掉作业,I/O dispatcher线程变成0了,看起来es sinker使用是正常的
这时候基本上可以判断是我们自己写的es client的问题。到底是什么问题呢?
我们再做一个测试进一步确认
3、启动问题作业,杀死job后,观察I/O dispatcher线程个数
重启flink的所有taskmanager,给一个“纯净”的环境,发现杀死作业后,还有I/O dispatcher线程。
这个测试可以判断是我们的es client存在线程泄漏
四、背后的原理
es sinker本质上是一个RichSinkFunction,RichSinkFunction带了open 和close 方法,在close方法中,es sinker正确关闭了http client
@Override

	public void close() throws Exception {

		if (bulkProcessor != null) {

			bulkProcessor.close();

			bulkProcessor = null;

		}

		if (client != null) {

			client.close();

			client = null;

		}

		callBridge.cleanup();

		// make sure any errors from callbacks are rethrown

		checkErrorAndRethrow();

	}
而我们的es client是没有被正确关闭的。
具体原理应该是是这样的,当es sinker出现npe或者写es rejected等异常时,job会被flink重启,es sinker这种RichSinkFunction类型的算子会被flink 调用close关闭释放掉一些资源,而我们写在ElasticsearchSinkFunction中es client,是不会被框架关照到的,而这种写法我们自己也无法预先定义重启后关闭client的逻辑.
如果在构造时使用单例,理论上应该是可以避免作业反复重启时es client不断被构造导致线程泄漏和内存泄漏的,但是编写单例写法有问题,虽然有double check,但是没加volatile,同时锁的是this, 而不是类。
五、小结
1、xland确实好用,排查问题帮助很大
2、flink作业用到的外部客户端不要单独构造,要使用类似RichFunction这种方式,提供open,close方法,确保让资源能够被flink正确释放掉。
3、用到的对象,创建的线程,线程池等等最好都起一个名字,方便使用xland事后排查问题,如果有经验的话,应该一开始就统计下用于构造es client的那个包装类对象个数。
一起来学习吧:
PerfMa KO 系列课之 JVM 参数【Memory篇】
记录一次Flink作业异常的排查过程的更多相关文章
- 一则线上MySql连接异常的排查过程
Mysql作为一个常用数据库,在互联网系统应用很多.有些故障是其自身的bug,有些则不是,这里以前段时间遇到的问题举例. 问题 当时遇到的症状是这样的,我们的应用在线上测试环境,JMeter测试过程中 ...
- 基于TBDS的flume异常问题排查过程
版权声明:本文由王亮原创文章,转载请注明出处: 文章原文链接:https://www.qcloud.com/community/article/214 来源:腾云阁 https://www.qclou ...
- 【Redis连接超时】记录线上RedisConnectionFailureException异常排查过程
项目架构: 部分组件如下: SpringCloudAlibaba(Nacos+Gateway+OpenFeign)+SpringBoot2.x+Redis 问题背景: 最近由于用户量增大,在高峰时期, ...
- Linux(2)---记录一次线上服务 CPU 100%的排查过程
Linux(2)---记录一次线上服务 CPU 100%的排查过程 当时产生CPU飙升接近100%的原因是因为项目中的websocket时时断开又重连导致CPU飙升接近100% .如何排查的呢 是通过 ...
- CentOS服务器上搭建Gitlab安装步骤、中文汉化详细步骤、日常管理以及异常故障排查
一, 服务器快速搭建gitlab方法 可以参考gitlab中文社区 的教程centos7安装gitlab:https://www.gitlab.cc/downloads/#centos7centos6 ...
- Java第六次作业--异常处理和Java类集
Deadline: 2017-5-4 23:00 一.学习要点 认真看书并查阅相关资料,掌握以下内容: 理解Java的异常处理机制 掌握捕获异常和声明抛出异常的方法 掌握List接口的实现类Array ...
- 一个flink作业的调优
最近接手了一个flink作业,另外一个同事断断续续有的没的写了半年的,不着急,也一直没上线,最近突然要上线,扔给我,要调通上线. 现状是: 1.代码跑不动,资源给的不少,但是就是频繁反压. 2.che ...
- 记录一次redis cpu异常升高的排插思路
好久没有写博客 现在重新捡起来 记录工作中遇到的问题 方便以后在遇到类似的问题也有一个参考. 背景:有一天生产服务器redis cpu 频繁报警 单核cpu 所以在想是不是业务量上来了. ...
- Apache Flink 进阶(六):Flink 作业执行深度解析
本文根据 Apache Flink 系列直播课程整理而成,由 Apache Flink Contributor.网易云音乐实时计算平台研发工程师岳猛分享.主要分享内容为 Flink Job 执行作业的 ...
随机推荐
- overflow:hidden的清除浮动效果
我们都知道"overflow:hidden"可以溢出隐藏,即当内容元素的高度大于其包含块的高度时,设置该属性即可把内容区域超出来的部分隐藏,使内容区域完全包含在该包含块中. 然而& ...
- Android | 超简单集成HMS ML Kit实现最大脸微笑抓拍
前言 如果大家对HMS ML Kit 人脸检测功能有所了解,相信已经动手调用我们提供的接口编写自己的APP啦.目前就有小伙伴在调用接口的过程中反馈,不太清楚HMS ML Kit 文档中的MLMax ...
- 【半译】扩展shutdown超时设置以保证IHostedService正常关闭
我最近发现一个问题,当应用程序关闭时,我们的应用程序没有正确执行在IHostedService中的StopAsync方法.经过反复验证发现,这是由于某些服务对关闭信号做出响应所需的时间太长导致的.在这 ...
- async/await 内幕【译文】
C# Under the Hood: async/await 原文地址:https://www.markopapic.com/csharp-under-the-hood-async-await/ 前言 ...
- React-Native 爬坑爬坑
出现函数找不到问题一般都是this的指向问题,一般是用箭头函数解决,解决不了就传入this 在setState里面一定不能要直接写state引入的值,如: this.setState({now: th ...
- dsPIC33EP单片机的PPS(外设引脚选择)
利用dsPIC33EP单片机进行can通信的时候用到引脚复用 引脚复用通过查询数据手册: C1RX的寄存器为RPINR26.C1RXR=(设置为需要用到的引脚) 引脚设置为输入(C1RX),TRIS= ...
- 基于 kubeadm 搭建高可用的kubernetes 1.18.2 (k8s)集群 部署 dashboard 2.x
1. 部署dashboard 2.x版本 Dashboard 分为 1.x版本 和 2.x版本, k8s 使用的是1.18.2 故部署2.x版本的 # dashboard 2.x版本的部署 # 上传d ...
- 货车运输 noip2013 luogu P1967 (最大生成树+倍增LCA)
luogu题目传送门! 首先,题目让我们求每个货车的最大运输量,翻译一下就是求路径上边权最小的边. 利用一下贪心思想可知,所有货车肯定都会尽量往大的边走. 进一步翻译,即为有一些小边货车根本不会走,或 ...
- [SD心灵鸡汤]010.每月一则 - 2016.02
1.世上只有一种英雄主义,就是在认清生活真相之后依然热爱生活. 2.要想赢,就一定不能怕输.不怕输,结果未必能赢.但是怕输,结果则一定是输. 3.你要做的就是别人换不掉的,那你做不到怪谁,就是你自己没 ...
- [JavaWeb基础] 031.dom4j写入xml的方法
上一篇我们讲述了dom4j读取xml的4种方法,甚是精彩,那么怎么样写入xml呢?我们直接看下源码实现. public static void main(String[] args) throws E ...