
【机器学习算法-python实现】协同过滤(cf)的三种方法实现
(转载请注明出处:http://blog.csdn.net/buptgshengod)
1.背景
icf指的是item collaborative filtering,是将商品进行分析推荐。同理ucf的u指的是user,他是找出知趣类似的人,进行推荐。
通常来讲icf的准确率可能会高一些。通过这次參加天猫大数据比赛。我认为仅仅有在数据量很庞大的时候才适合用cf,假设数据量很小。cf的准确率会很可怜。
博主在比赛s1阶段,大概仅仅有几万条数据的时候,尝试了icf,准确率不到百分之中的一个。
。。
。。
2.经常用法

(1)欧氏距离法
数值越小。表示类似的越高。
def OsDistance(vector1, vector2):

    sqDiffVector = vector1-vector2

    sqDiffVector=sqDiffVector**2

    sqDistances = sqDiffVector.sum()

    distance = sqDistances**0.5

    return distance
(2)皮尔逊相关系数
两个变量之间的相关系数越高。从一个变量去预測还有一个变量的准确度就越高,这是由于相关系数越高,就意味着这两个变量的共变部分越多,所以从当中一个变量的变化就可越多地获知还有一个变量的变化。
假设两个变量之间的相关系数为1或-1,那么你全然可由变量X去获知变量Y的值。
· 当相关系数为0时。X和Y两变量无关系。
· 当X的值增大。Y也增大。正相关关系,相关系数在0.00与1.00之间
· 当X的值减小,Y也减小,正相关关系。相关系数在0.00与1.00之间
· 当X的值增大。Y减小,负相关关系。相关系数在-1.00与0.00之间
当X的值减小。Y增大,负相关关系,相关系数在-1.00与0.00之间
相关系数的绝对值越大。相关性越强,相关系数越接近于1和-1,相关度越强,相关系数越接近于0,相关度越弱。

在python中用函数corrcoef实现。详细方法见http://infosec.pku.edu.cn/~dulz/doc/Numpy_Example_List.htm
(3)余弦类似度
0度角的余弦值是1,而其它不论什么角度的
在比較过程中。向量的规模大小不予考虑,仅仅考虑到向量的指向方向。余弦相
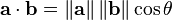
def cosSim(inA,inB):

    num = float(inA.T*inB)

    denom = la.norm(inA)*la.norm(inB)

    return 0.5+0.5*(num/denom)
【机器学习算法-python实现】协同过滤(cf)的三种方法实现的更多相关文章
- python每次处理一个字符的三种方法
python每次处理一个字符的三种方法 a_string = "abccdea" print 'the first' for c in a_string: print ord(c) ...
- Python 文件行数读取的三种方法
Python三种文件行数读取的方法: #文件比较小 count = len(open(r"d:\lines_test.txt",'rU').readlines()) print c ...
- Python 判断文件是否存在的三种方法
通常在读写文件之前,需要判断文件或目录是否存在,不然某些处理方法可能会使程序出错.所以最好在做任何操作之前,先判断文件是否存在. 这里将介绍三种判断文件或文件夹是否存在的方法,分别使用os模块.Try ...
- python webdriver api-上传文件的三种方法
上传文件: 第一种方式,sendkeys(),最简单的 #encoding=utf-8 from selenium import webdriver import unittest import ti ...
- Python 中删除列表元素的三种方法
列表基本上是 Python 中最常用的数据结构之一了,并且删除操作也是经常使用的. 那到底有哪些方法可以删除列表中的元素呢?这篇文章就来总结一下. 一共有三种方法,分别是 remove,pop 和 d ...
- python列表删除重复元素的三种方法
给定一个列表,要求删除列表中重复元素. listA = ['python','语','言','是','一','门','动','态','语','言'] 方法1,对列表调用排序,从末尾依次比较相邻两个元素 ...
- 用Python获取Linux资源信息的三种方法
方法一:psutil模块 #!usr/bin/env python # -*- coding: utf-8 -*- import socket import psutil class NodeReso ...
- Python判断文件是否存在的三种方法
通常在读写文件之前,需要判断文件或目录是否存在,不然某些处理方法可能会使程序出错.所以最好在做任何操作之前,先判断文件是否存在. 这里将介绍三种判断文件或文件夹是否存在的方法,分别使用os模块.Try ...
- Python判断文件是否存在的三种方法【转】
转:http://www.cnblogs.com/jhao/p/7243043.html 通常在读写文件之前,需要判断文件或目录是否存在,不然某些处理方法可能会使程序出错.所以最好在做任何操作之前,先 ...
- python删除list中元素的三种方法
a.pop(index):删除列表a中index处的值,并且返回这个值. del(a[index]):删除列表a中index处的值,无返回值. del中的index可以是切片,所以可以实现批量删除. ...
随机推荐
- verilog behavioral modeling --loop statement
1.forever 2.repeat 3.while 4.for The for statement accomplishes the same results as the following ps ...
- Python9-装饰器进阶-day12
wapers方法 def wahaha(): ''' sljfldsjflds :return: ''' print('娃哈哈') print(wahaha.__name__) #查看字符串格式的函数 ...
- cs229_part2
part2 这节课主要讲的是生成式模型,那么与这个生成式模型相对于的就是我们上节课所讲那几个辨别式模型.所以生成式模型和辨别式模型的区别是什么呢.我先给出数学上的定义: 这是我们上节课线性回归所用的给 ...
- Python3的基本数据类型及常用的方法
python3的基本数据类型: 在python3当中有这么几种基本的数据类型:int(整形).str(字符串).list(列表).tuple(元组).dict(字典).bool(布尔值)等.数字整体划 ...
- Java的9种基本数据类型以及封装类
Java的9种基本数据类型以及封装类 基本类型 大小(单位/字节) 默认值 封装类 byte 1 (byte)0 Byte short 2 (short)0 Short int 4 0 Integer ...
- Web自动化Selenium2环境配置中Selenium IDE的安装
下载的firefox32.0的版本,但是在附件组件中只有selenuim IDE button,本以为这个就是selenium IDE插件,自以为是的后果就是把自己坑了.并且像一些selenium I ...
- python基础学习笔记——开发规范
> 编码 1 2 3 4 5 所有的 Python 脚本文件都应在文件头标上 # -*- coding:utf-8 -*- 用于设置编辑器,默认保存为 utf-8 格式. > 注释 ...
- Django中的app及mysql数据库篇(ORM操作)
Django常见命令 在Django的使用过程中需要使用命令让Django进行一些操作,例如创建Django项目.启动Django程序.创建新的APP.数据库迁移等. 创建Django项目 一把我们都 ...
- ubuntu14.04 Cannot find OpenSSL's <evp.h>
Cannot find OpenSSL's <evp.h> when i configure php7 manually,i get trouble with that problem,f ...
- js对文字进行编码
js对文字进行编码涉及3个函数:escape,encodeURI,encodeURIComponent,相应3个解码函数:unescape,decodeURI,decodeURIComponent 1 ...