
机器学习实战基础(三十七):随机森林 (四)之 RandomForestRegressor 重要参数,属性与接口
RandomForestRegressor
class sklearn.ensemble.RandomForestRegressor (n_estimators=’warn’, criterion=’mse’, max_depth=None,

min_samples_split=2, min_samples_leaf=1, min_weight_fraction_leaf=0.0, max_features=’auto’,

max_leaf_nodes=None, min_impurity_decrease=0.0, min_impurity_split=None, bootstrap=True, oob_score=False,

n_jobs=None, random_state=None, verbose=0, warm_start=False)
所有的参数,属性与接口,全部和随机森林分类器一致。仅有的不同就是回归树与分类树的不同,不纯度的指标,
参数Criterion不一致。
1 重要参数,属性与接口
criterion
回归树衡量分枝质量的指标,支持的标准有三种:
1)输入"mse"使用均方误差mean squared error(MSE),父节点和叶子节点之间的均方误差的差额将被用来作为特征选择的标准,这种方法通过使用叶子节点的均值来最小化L2损失
2)输入“friedman_mse”使用费尔德曼均方误差,这种指标使用弗里德曼针对潜在分枝中的问题改进后的均方误差
3)输入"mae"使用绝对平均误差MAE(mean absolute error),这种指标使用叶节点的中值来最小化L1损失
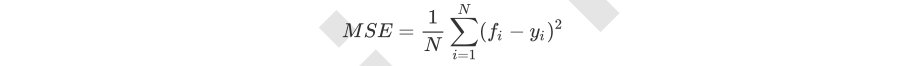
其中N是样本数量,i是每一个数据样本,fi是模型回归出的数值,yi是样本点i实际的数值标签。所以MSE的本质,其实是样本真实数据与回归结果的差异。
在回归树中,MSE不只是我们的分枝质量衡量指标,也是我们最常用的衡量回归树回归质量的指标,当我们在使用交叉验证,或者其他方式获取回归树的结果时,我们往往选择均方误差作为我们的评估(在分类树中这个指标是score代表的预测准确率)。在回归中,我们追求的是,MSE越小越好。
然而,回归树的接口score返回的是R平方,并不是MSE。R平方被定义如下:
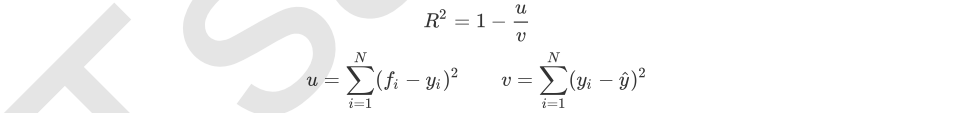
其中u是残差平方和(MSE * N),v是总平方和,N是样本数量,i是每一个数据样本,fi是模型回归出的数值,yi是样本点i实际的数值标签。y帽是真实数值标签的平均数。R平方可以为正为负(如果模型的残差平方和远远大于模型的总平方和,模型非常糟糕,R平方就会为负),而均方误差永远为正。
值得一提的是,虽然均方误差永远为正,但是sklearn当中使用均方误差作为评判标准时,却是计算”负均方误差“(neg_mean_squared_error)。这是因为sklearn在计算模型评估指标的时候,会考虑指标本身的性质,均方误差本身是一种误差,所以被sklearn划分为模型的一种损失(loss),因此在sklearn当中,都以负数表示。真正的均方误差MSE的数值,其实就是neg_mean_squared_error去掉负号的数字。
重要属性和接口
最重要的属性和接口,都与随机森林的分类器相一致,还是apply, fit, predict和score最为核心。值得一提的是,随机森林回归并没有predict_proba这个接口,因为对于回归来说,并不存在一个样本要被分到某个类别的概率问题,因此没有predict_proba这个接口。
随机森林回归用法
和决策树完全一致,除了多了参数n_estimators。
from sklearn.datasets import load_boston

from sklearn.model_selection import cross_val_score

from sklearn.ensemble import RandomForestRegressor

boston = load_boston()

regressor = RandomForestRegressor(n_estimators=100,random_state=0)

cross_val_score(regressor, boston.data, boston.target, cv=10

               ,scoring = "neg_mean_squared_error")

sorted(sklearn.metrics.SCORERS.keys())
返回十次交叉验证的结果,注意在这里,如果不填写scoring = "neg_mean_squared_error",交叉验证默认的模型
衡量指标是R平方,因此交叉验证的结果可能有正也可能有负。而如果写上scoring,则衡量标准是负MSE,交叉验
证的结果只可能为负。
机器学习实战基础(三十七):随机森林 (四)之 RandomForestRegressor 重要参数,属性与接口的更多相关文章
- 机器学习实战基础(十七):sklearn中的数据预处理和特征工程(十)特征选择 之 Embedded嵌入法
Embedded嵌入法 嵌入法是一种让算法自己决定使用哪些特征的方法,即特征选择和算法训练同时进行.在使用嵌入法时,我们先使用某些机器学习的算法和模型进行训练,得到各个特征的权值系数,根据权值系数从大 ...
- 机器学习实战基础(三十六):随机森林 (三)之 RandomForestClassifier 之 重要属性和接口
重要属性和接口 至此,我们已经讲完了所有随机森林中的重要参数,为大家复习了一下决策树的参数,并通过n_estimators,random_state,boostrap和oob_score这四个参数帮助 ...
- 机器学习实战基础(三十五):随机森林 (二)之 RandomForestClassifier 之重要参数
RandomForestClassifier class sklearn.ensemble.RandomForestClassifier (n_estimators=’10’, criterion=’g ...
- python机器学习实战(三)
python机器学习实战(三) 版权声明:本文为博主原创文章,转载请指明转载地址 www.cnblogs.com/fydeblog/p/7277205.html 前言 这篇notebook是关于机器 ...
- R语言︱机器学习模型评估方案(以随机森林算法为例)
笔者寄语:本文中大多内容来自<数据挖掘之道>,本文为读书笔记.在刚刚接触机器学习的时候,觉得在监督学习之后,做一个混淆矩阵就已经足够,但是完整的机器学习解决方案并不会如此草率.需要完整的评 ...
- 机器学习实战基础(三十八):随机森林 (五)RandomForestRegressor 之 用随机森林回归填补缺失值
简介 我们从现实中收集的数据,几乎不可能是完美无缺的,往往都会有一些缺失值.面对缺失值,很多人选择的方式是直接将含有缺失值的样本删除,这是一种有效的方法,但是有时候填补缺失值会比直接丢弃样本效果更好, ...
- 机器学习实战基础(二十二):sklearn中的降维算法PCA和SVD(三) PCA与SVD 之 重要参数n_components
重要参数n_components n_components是我们降维后需要的维度,即降维后需要保留的特征数量,降维流程中第二步里需要确认的k值,一般输入[0, min(X.shape)]范围中的整数. ...
- 机器学习实战基础(十四):sklearn中的数据预处理和特征工程(七)特征选择 之 Filter过滤法(一) 方差过滤
Filter过滤法 过滤方法通常用作预处理步骤,特征选择完全独立于任何机器学习算法.它是根据各种统计检验中的分数以及相关性的各项指标来选择特征 1 方差过滤 1.1 VarianceThreshold ...
- 机器学习实战基础(二十七):sklearn中的降维算法PCA和SVD(八)PCA对手写数字数据集的降维
PCA对手写数字数据集的降维 1. 导入需要的模块和库 from sklearn.decomposition import PCA from sklearn.ensemble import Rando ...
随机推荐
- 分享我在前后端分离项目中Gitlab-CI的经验
长话短说,今天分享我为前后端分离项目搭建Gitlab CI/CD流程的一些额外经验. Before Gitlab-ci是Gitlab提供的CI/CD特性,结合Gitlab简单友好的配置界面,能愉悦的在 ...
- iOS/swift 单选框和复选框
/** 复选框 */ import UIKit class LYBmutipleSelectView: UIView { var selectindexs:[Int]=[]//选中的 //标题数组 v ...
- 一文读懂Redis的四种模式,单机、主从、哨兵、集群
少点代码,多点头发 本文已经被GitHub收录,欢迎大家踊跃star 和 issues. https://github.com/midou-tech/articles 入职第一周,我被坑了 最近刚入职 ...
- [每日一题2020.06.13]leetcode #739 #15 单调栈 双指针查找
739 每日温度 ( 单调栈 ) 题目 : https://leetcode-cn.com/problems/daily-temperatures/ 题意 : 找到数组每一个元素之后第一个大于它的元素 ...
- 2019-02-07 selenium...
今天是超级郁闷的一天 看教程 下了mysql-----配置-----不会----查资料------2小时后 mongodb-----配置------不会------查资料------1小时后 然后是各 ...
- mysql HAVING用法
原文链接:https://www.cnblogs.com/mr-wuxiansheng/p/11188733.html having字句可以让我们筛选分组之后的各种数据,where字句在聚合前先筛选记 ...
- MyISAM和InnoDB的差异
转载:https://www.cnblogs.com/xc-chejj/p/11245034.html MyISAM是默认表类型,基于ISAM(Indexed Sequential Access Me ...
- 测试必备工具之最强抓包神器 Charles,你会了么?
前言 作为软件测试工程师,大家在工作中肯定经常会用到各种抓包工具来辅助测试,比如浏览器自带的抓包工具-F12,方便又快捷:比如时下特别流行的Fiddler工具,使用各种web和APP测试的各种场景 ...
- ASP.NET处理管道初谈
客户端往发送的请求到达服务端到服务端响应回客户端的这段时间内,实际上服务器内并不只是简单地对请求进行处理,然后把处理结果响应回去,而是经过一系列多达19个事件之后才能产生最后地处理结果. 因此:其处理 ...
- vwware虚拟机网卡的三种模式
这里在虚拟机中必须要保证右上角的两个勾选上 三种模式:简单一个比如宿主机器直接连接路由器上网,那虚拟机和宿主机器是一定的可以上外网,相当于虚拟机直接连接在路由器上面,虚拟机需要配置可以上外网的IP地址 ...