
超千个节点OpenStack私有云案例(1):CERN 5000+ 计算节点私有云
CERN:欧洲核子研究组织
本文根据以下几篇文章整理而来:
- https://www.openstack.org/summit/tokyo-2015/videos/presentation/unveiling-cern-cloud-architecture
- https://www.mybookworld.info/view/lcl9u/cern-cloud-architecture-february-2016.html
- http://openstack-in-production.blogspot.com/
1. 系统
(1)系统规模
- 2015 年是 5000个计算节点,16000 个在运行的虚机
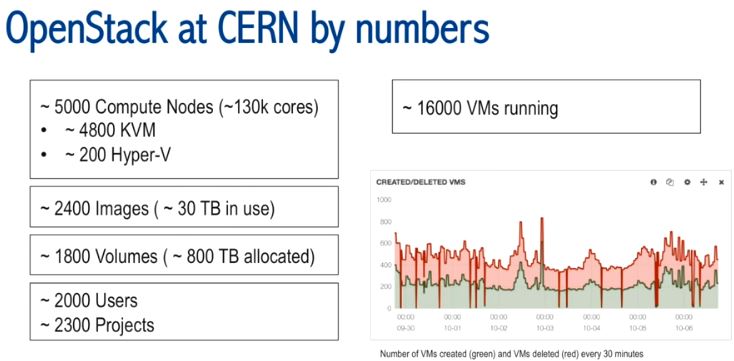
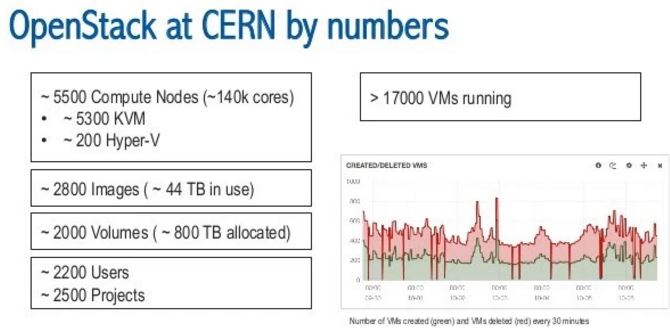
- 2016年2月是 5500 个计算节点,半年期间计算节点增加了 500 个,虚机增加了1000个
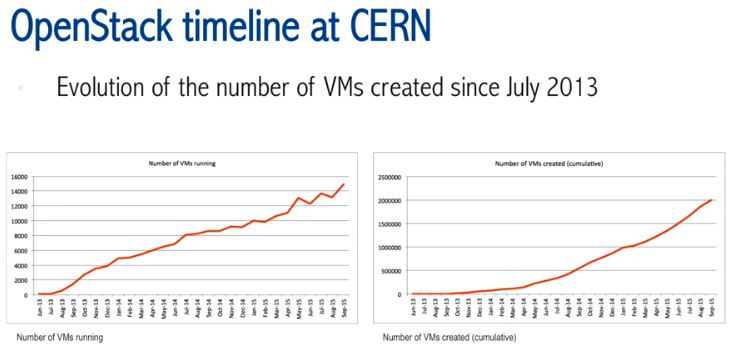
- 左边是当前正在运行的虚机的数量 16000 个,右边是被创建过的虚机的累计数量,超过 25 M。
(2)CERN 使用的 OpenStack 版本保持持续更新,基本上是延迟一个社区版本

(3)2015 年的总体结构:一个 region,2 个数据中心,26 个 Cell,全部使用 nova-network
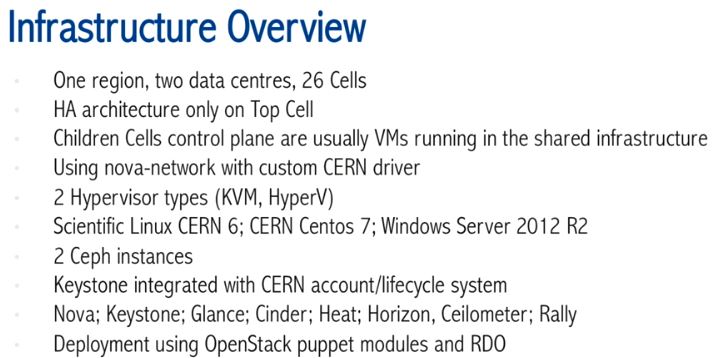
在 2016 年2月,已经增长到了 33 个 Cell,而且在其中一个 Cell 中使用了 Neutron。
(4)Nova 系统架构
- 使用 nova-cell
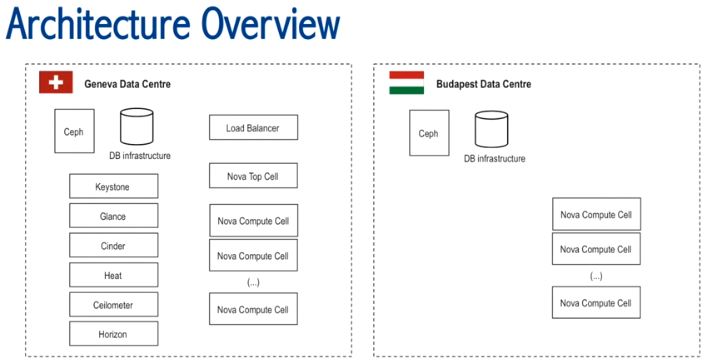
- 每个 Child Cell 有不同的 Use cases
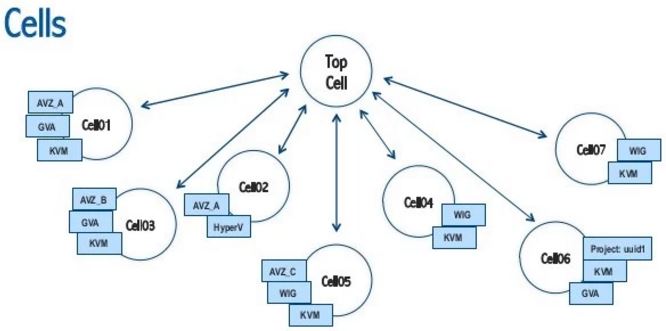
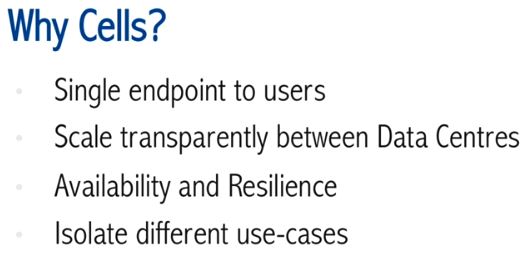
- 为什么要使用 Cell?因为不同的用户有不同的需求,因此,在每个 Child Cell 内部,可以使用不同的配置,包括 nova scheduler 等;Cell 还有助于缩小故障发生时候的影响域。
- Cell V1 的局限性

- Nova-cell 系统架构:两级 Cell 结构。只在 Nova Top Cell Controller 上使用 HA,在 Child Cell controller 上不使用HA。
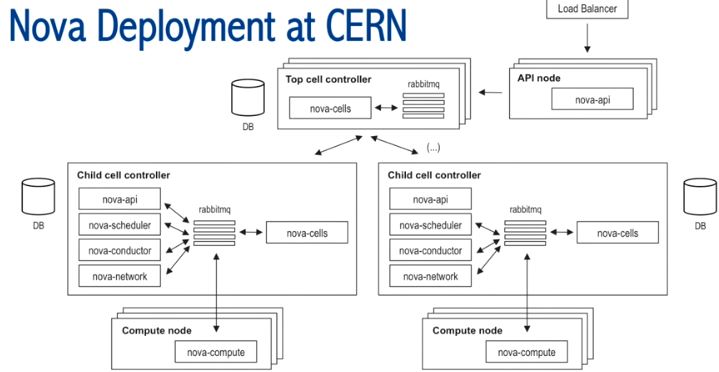
- 每个 Child Cell 大概 200 个计算节点

- CERN 自己开发了 Cell 调度器
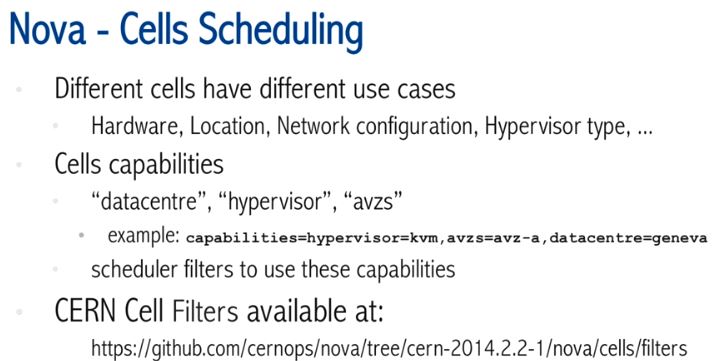
- 如果将特定 project 的虚机调度到特定的 Child cell 上

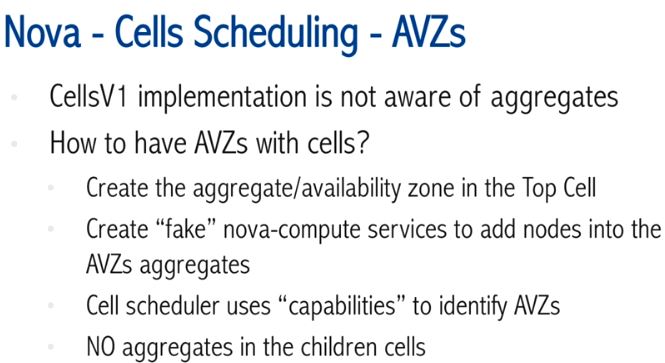
- 如何结合 Cell 使用 AZ
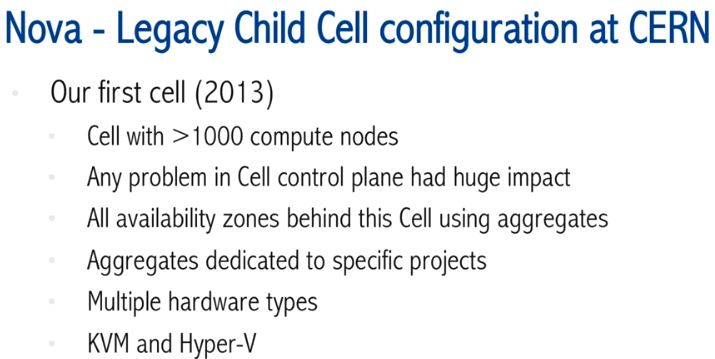
- 在 2013 年的时候,只使用了一个 Cell,考虑到:(1)Nova Cell 的调度机制非常弱,只能随机调度,(2)想使用 host aggregate功能 (3)不能跨Cell 做 live migration。但是最后发现非常难于管理。
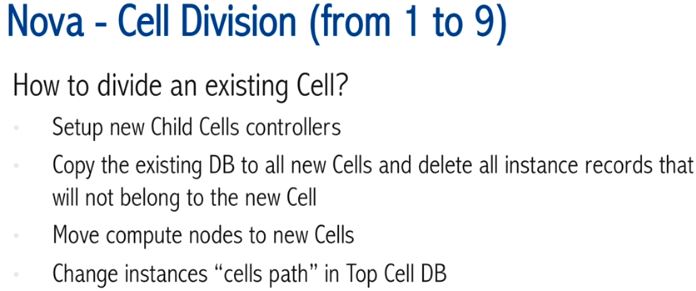
- 随后他们就将其拆分为 9 个 Child cell
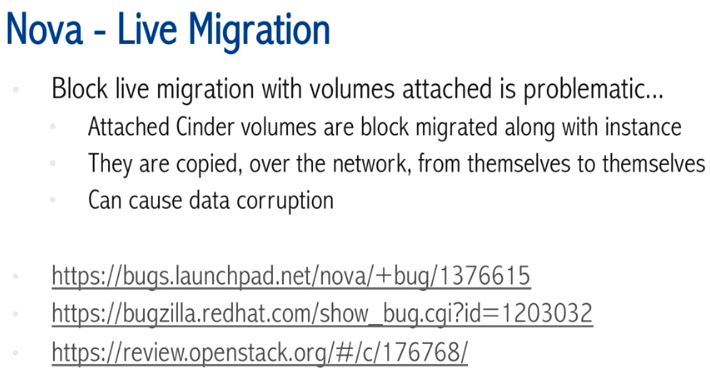
- Nova 做 block live migration 遇到的问题
- Nova kilo 版本与 Python 2.6 不兼容

(5)网络架构
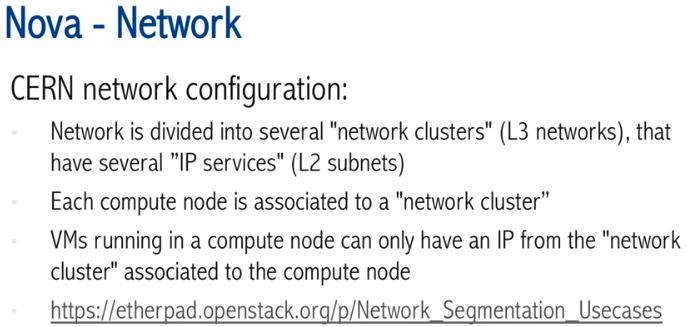
- CERN 使用基于 nova-network 的 网络分段技术
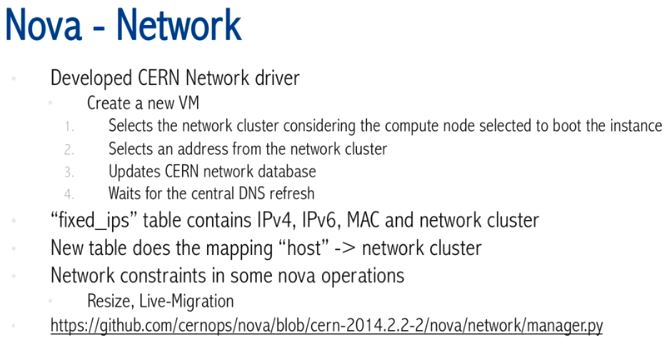
- CERN 自己开发了一个 Network driver
- 他们已经对 Neutron 做了大量的测试,已经在计划迁移(到2016年2月他们已经在一个Child cell 中使用 Neutron)

(6)Keystone
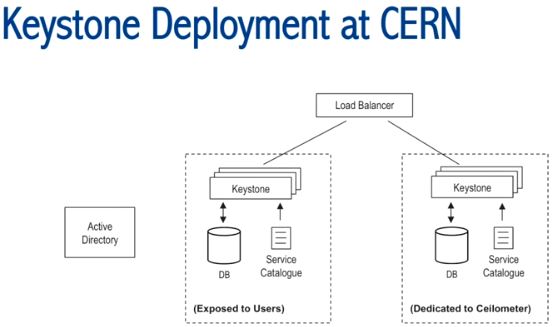
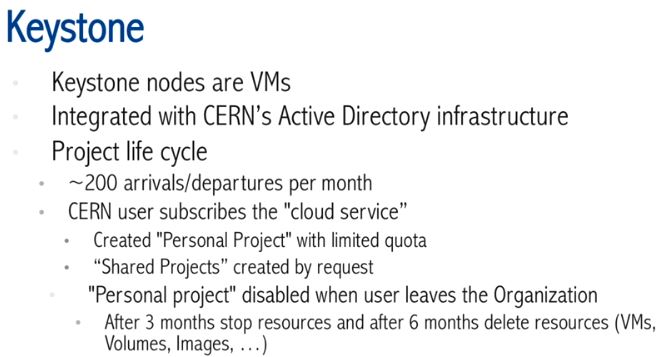
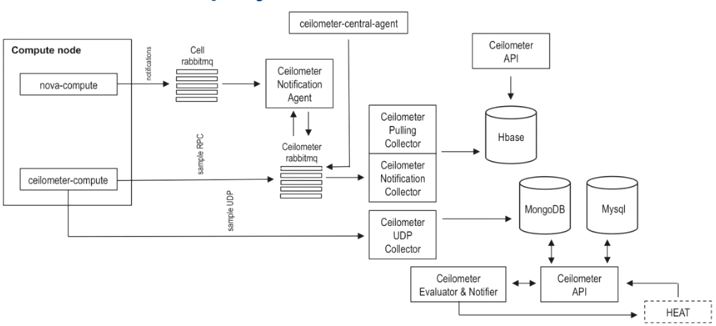
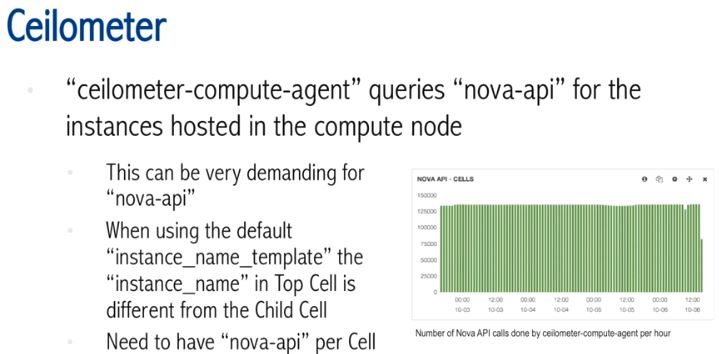
使用两个不同的 Keystone。Ceilometer 需要调用大量的 API,因此给它们一个专有的Keystone,免得影响用户使用 Keystone。
(7)Glance
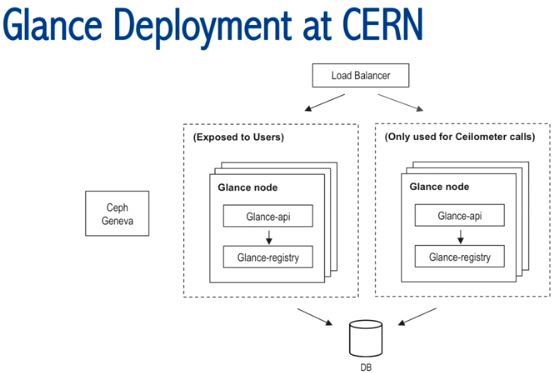
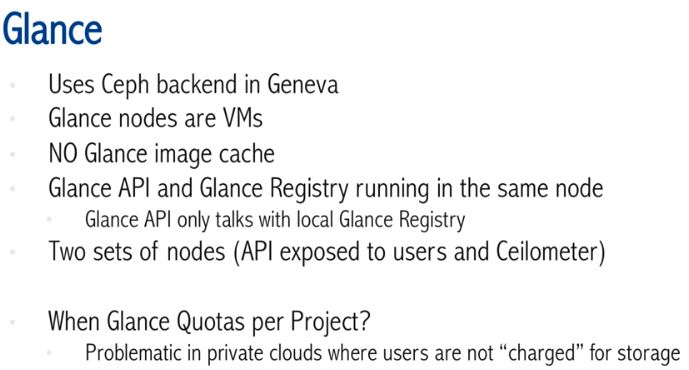
Glance 服务运行在虚机中。之前,Glance registry 可以被别的 Glance API 使用,但是,这导致难于定位问题,因此,现在的 Glance registry 只和本地的 Glance API 通信。但是,Glance 不支持分 Project 设置 Quota,这对他们很重要。
(8)Cinder
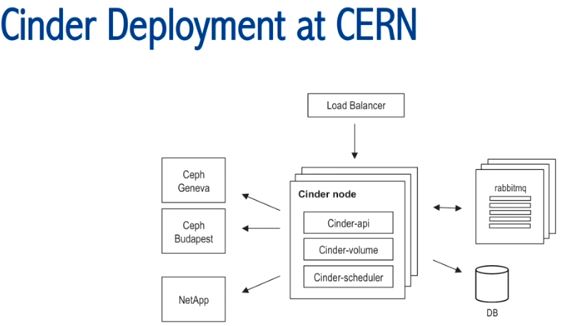
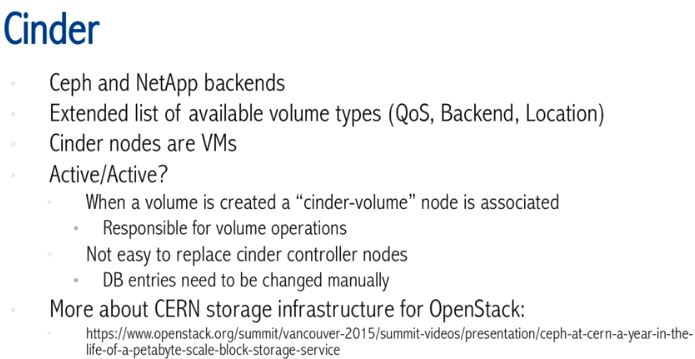
使用了 3个 backend,两个 Ceph,一个 NetApp。目前没有 Ceph Cinder driver for hyper-v,所以他们使用了 NetApp,被 Hyper-V 虚机使用。
(9)Ceilometer

(10)Rally
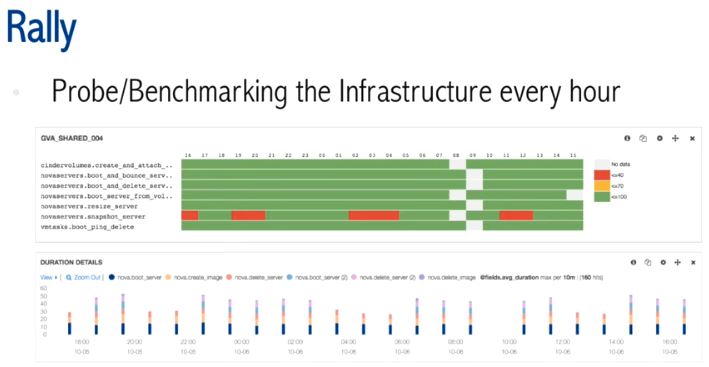
不仅用于 benchmarking 测试,还用于 FVT。
(11)新的挑战
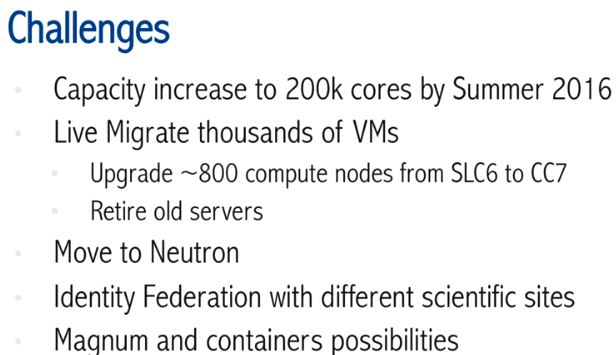
2. 简单分析
2.1 CERN 对 Nova Cell 的看法
对大规模的部署,Nova Cell 有几个优势:
- 能够保持对用户只有单端点可见(single endpoint to users)
- 能够增加基础架构的可用性和弹性(increase the availability and resilience of the Infrastructure)
- 能够避免超出 Nova 和其它外部模块(比如 DB,MQ 等)的上限 (avoid that Nova and external components (DBs, message brokers) reach their limits)
- 能够隔离不同用户 (isolate different user cases)
但是,Cell 目前还是有不少的局限,如下的功能不能和 Nova Cell 一起使用:
- Security Groups;
- Manage aggregates on Top Cell;
- Availability Zone support;
- Server groups;
- Cell scheduler limited functionality;
2.2 本人的一点看法
- 使用现有的 OpenStack 来支持 5000 个计算节点,那是非常牛的事情!这可能是目前最大的 OpenStack 生产系统私有云部署规模。
- 计算扩展性方面,使用 Nova cell 是一个解决方案,但是目前它的 V1 版本已经被冻结,V2 还在开发中,因此,要使用的话,需要做大量的开发和问题定位;而且,它还存在大量的局限性。
- 网络扩展性方面,Neutron 的扩展性和稳定性依然问题很大,CERN 也在一步步尝试,期待他们使用 Neutron 的心得
- 存储扩展性方面,Ceph 居然能做到支撑 30PB 的数据量,这也是非常非常牛的事情!
- Ceilometer 扩展性方面,以及性能和开销等方面,默认情况下依然问题很大,CERN 做出了改进的非常好的示范
- 谢谢 CERN 团队的超强工作和无私分享
超千个节点OpenStack私有云案例(1):CERN 5000+ 计算节点私有云的更多相关文章
- 政务私有云盘系统建设的工具 – Mobox私有云盘
序言 这几年,智慧政务已经成为了政府行业IT建设发展的重要进程.传统办公方式信息传递速度慢.共享程度低.查询利用难,早已成为政府机关获取和利用信息的严重制约因素.建立文档分享共用机制,加强数据整合,避 ...
- 四种方案:将OpenStack私有云部署到Hadoop MapReduce环境中
摘要:OpenStack与Hadoop被誉为继Linux之后最有可能获得巨大成功的开源项目.这二者如何结合成为更猛的新方案?业内给出两种答案:Hadoop跑在OpenStack上或OpenStack部 ...
- CentOS7安装OpenStack(Rocky版)-05.安装一个nova计算节点实例
上一篇文章分享了控制节点的nova计算服务的安装方法,在实际生产环境中,计算节点通常会安装一些单独的节点提供服务,本文分享单独的nova计算节点的安装方法 ---------------- 完美的分 ...
- openstack Q版部署-----nova服务配置-计算节点(6)
一.服务安装(计算节点) 安装软件: yum install openstack-nova-compute -y 编辑/etc/nova/nova.conf文件并设置如下内容: [DEFAULT] e ...
- S1_搭建分布式OpenStack集群_07 nova服务配置 (计算节点)
一.服务安装(计算节点)安装软件:# yum install openstack-nova-compute -y 编辑/etc/nova/nova.conf文件并设置如下内容:# vim /etc/n ...
- openstack私有云布署实践【13.2 网络Neutron-compute节点配置(办公网环境)】
所有compute节点 下载安装组件 # yum install openstack-neutron openstack-neutron-linuxbridge ebtables ipset -y ...
- openstack私有云布署实践【13.1 网络Neutron-compute节点配置(科兴环境)】
所有kxcompute节点 下载安装组件 # yum install openstack-neutron openstack-neutron-linuxbridge ebtables ipset ...
- openstack私有云布署实践【12.2 网络Neutron-controller节点配置(办公网环境)】
网络这一块推荐使用的是 Neutron--LinuxBirdge的Ha高可用,此高可用方案对Public作用不是很大,Public只用到DHCP,而Private则会用到L3 Agent,则此方案是有 ...
- openstack私有云布署实践【12.1 网络Neutron-controller节点配置(科兴环境)】
网络这一块推荐使用的是 Neutron--LinuxBirdge的Ha高可用,此高可用方案对Public作用不是很大,Public只用到DHCP,而Private则会用到L3 Agent,则此方案是有 ...
随机推荐
- .net 大型分布式电子商务架构说明
.net大型分布式电子商务架构说明 背景 构建具备高可用,高扩展性,高性能,能承载高并发,大流量的分布式电子商务平台,支持用户,订单,采购,物流,配送,财务等多个项目的协作,便于后续运营报表,分析,便 ...
- HIVE教程
完整PDF下载:<HIVE简明教程> 前言 Hive是对于数据仓库进行管理和分析的工具.但是不要被“数据仓库”这个词所吓倒,数据仓库是很复杂的东西,但是如果你会SQL,就会发现Hive是那 ...
- Python 基础之一变量和赋值
变量:程序在运行的时候会用到很多临时存储数据,这个时候就用到了变量,临时数据的名字. Python中变量不需要声明,直接可以使用,变量的数据类型由赋值确定. >>> name=&qu ...
- win10上部署Hadoop-2.7.3——非Cygwin、非虚拟机
开始接触Hadoop,听人说一般都是在Lunix下部署Hadoop,但是本人Lunix不是很了解,所以Google以下如何在Win10下安装Hadoop(之后再在Lunix下弄),找到不少文章,以下是 ...
- iOS开源项目周报1229
由OpenDigg 出品的iOS开源项目周报第三期来啦.我们的iOS开源周报集合了OpenDigg一周来新收录的优质的iOS开发方面的开源项目,方便iOS开发人员便捷的找到自己需要的项目工具等. Ma ...
- iOS10之Expected App Behaviors
昨天上架到appStore的时候碰到个问题,构建好后上传到itunesconnect的的包都用不了, 显示错误为:此构建版本无效. 或者英文显示为:ITC.apps.preReleaseBuild.e ...
- 支付宝web支付
过程 1. 用户下单 2. 商户后台产生订单 3. 请求支付宝web支付页面(将订单信息返回给用户---放在form里面---隐藏起来-----并通过脚本自动提交此form到支付宝web支付页) 4. ...
- js月份,日期加一天
js没有直接可以用的函数,所以只能自己写,其中需要涉及到每个月天数的判断,如果是2月份的话,还要涉及到闰年的判断 var addDate = { //日期,在原有日期基础上,增加days天数,默认增加 ...
- php杂记(二)
1.获取客户端真实IP if (!empty($_SERVER['HTTP_CLIENT_IP'])) { $onlineip = $_SERVER['HTTP_CLIENT_IP']; } else ...
- 微信硬件H5面板开发(二) ---- 实现一个灯的控制
在第一节中讲解了openApi的调用,这一篇讲一下如何实现一个灯的控制.就用微信提供的lamp例子来做,将代码扒下来(实在是没办法,没有示例),整合到自己的项目中.lamp源码:http://file ...