
Elasticsearch中的Term查询和全文查询
前言
在 Elasticsearch 中,Term 查询和全文查询是两种完全不同的处理方式,在上一篇我们也简单对比了 Term 查询和全文查询中的 Phrase 中的区别,那么本文就彻底的来理清这两种查询之间的关系。
我们重新创建一个新的索引 index_002,并插入以下数据
POST /_bulk

{"index":{"_index":"index_002"}}

{"id":"1","name":"lonely wolf","address":null,"count":1}

{"index":{"_index":"index_002"}}

{"id":"2","name":"lonely hello wolf","address":[],"count":3}

{"index":{"_index":"index_002"}}

{"id":"3","name":"lonely hello word wolf","address":"[广东]","count":1}

{"index":{"_index":"index_002"}}

{"id":"4","name":"Lonely Wolf","address":"['广东','深圳']","count":2}

{"index":{"_index":"index_002"}}

{"id":"5","name":"wolf","address":null,"count":1}
Term 查询
Term 查询一般表达的是最小单位查询,也就是说对我们传入的关键字会作为一个整体进行查询,而不会进行分词。
如下查询,满足条件的只有第一条数据,需要注意的是对 text 类型字段需要加上 .keyword:
POST index_001/_search

{

  "query": {

    "term": {

      "name.keyword": {

        "value": "lonely wolf"

      }

    }

  }

}
这里如果不加上 .keyword 则不会返回任何结果,这是因为 text 类型的字段会被倒排索引进行存储,倒排索引会利用分析器将文本进行分词,我们可以利用分词器来查看下分词结果:
POST /_analyze

{

 "analyzer": "standard",

 "text": ["lonely wolf"]

}

可以看到,lonely wolf 被分成了 lonely 和 wolf 两个单词,所以我们将 lonely wolf 作为一个进行查询自然是无法查询到结果的。
这里有个地方需要注意,如果我们存入的是大写单词,如 Lonely Wolf,分词器也是一样的结果,也就是会将大写字母统一转化为小写进行存储,所以进行全文查询的时候也是无法查询出结果。
exists 查询
用来判定是否存在某一个字段,返回包含字段的任何索引值的文档。
GET index_002/_search

{

  "query": {

    "exists": {

      "field": "address"

    }

  }

}
这里返回的结果就是第三条和第四条数据,像 null 值和空数组 [] 不会被返回。
如果想要返回 null 值或者空数组 [] 的数据,那么可以利用 bool 查询的 must_not 语句:
GET index_002/_search

{

  "query": {

    "bool": {

      "must_not": [

        {

          "exists": {"field": "address"}

        }

      ]

    }

  }

}
fuzzy 查询
用于近似查询,比如我们有时候在用百度搜索的时候,输错了字会被纠正:
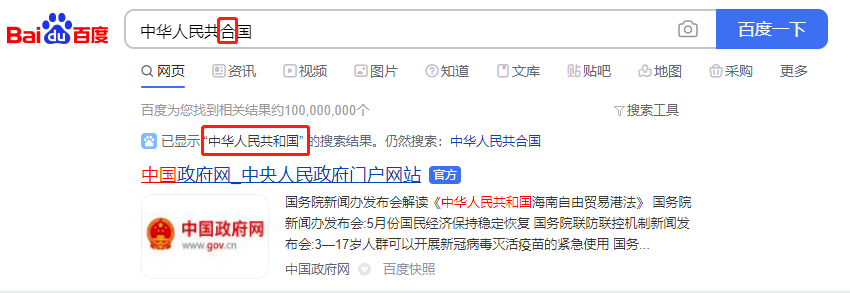
一般情况下有一个单词错误的情况下,fuzzy 查询可以找到另一个近似的词来代替,主要有以下场景:
- 修改一个单词,如:
box--->fox。 - 移除一个单词,如:
black-->lack。 - 插入一个单词,如:
sic-->sick。 - 转换两个单词顺序,如:
act-->cat。
为了可以查询到这种近似的单词,fuzzy 查询需要创建一个所有近似词的集合,这样搜索的时候就可以采用精确查询找到近似的词来代替查询。
比如下面这个查询就可以查询出前面四条数据,同样的,value 修改为 loneyl 或 lonelyy 或 loneyle 都能查询出前面四条数据:
GET index_002/_search

{

  "query": {

    "fuzzy": {

      "name": {

        "value": "lonel"

      }

    }

  }

}
ids 查询
通过文档 id 进行查询返回,这里的 id 为文档中的 _id。
GET index_002/_search

{

  "query": {

    "ids": {

      "values": ["id1","id2"]

    }

  }

}
prefix 查询
通过指定字段的前缀进行查询。
GET index_002/_search

{

  "query": {

    "prefix": {

      "name": {

        "value": "lo"

      }

    }

  }

}
range 查询
通过范围进行查询。
GET index_002/_search

{

  "query": {

   "range": {

     "id": {

       "gte": 1,

       "lte": 2

     }

   }

  }

}
其中:
- gt:表示大于。
- gte:表示大于等于。
- lt:表示小于。
- lte:表示小于等于。
这种范围查询还可以用于日期的范围查询,此时将会对日期进行毫秒数转换后进行查询,如下面的例子就是查询昨天到今天的区间,而且可以通过 time_zone 指定时区:
GET _search

{

    "query": {

        "range" : {

            "timestamp" : {

                "gte" : "now-1d/d",

                "lt" :  "now/d"

            }

        }

    }

}
regexp 查询
通过正则表达式进行查询。如下例子可以查询出 lon 开头的所有数据:
GET index_002/_search

{

  "query": {

   "regexp": {

     "name": "lon.*"

   }

  }

}
term 查询
返回一个或者多个单词精确匹配的文档。
# 返回前面四条数据

GET index_002/_search

{

  "query": {

   "term": {

     "name": {

       "value": "lonely"

     }

   }

  }

}

# 只返回第一条数据

GET index_002/_search

{

  "query": {

   "term": {

     "name.keyword": {

       "value": "lonely wolf"

     }

   }

  }

}
terms 查询
terms 查询和 term 查询是一个含义,区别只是 terms 可以一次精确匹配多个词。
# 返回全部五条数据

GET index_002/_search

{

  "query": {

   "terms": {

     "name": [

       "lonely",

       "wolf"

     ]

   }

  }

}
terms_set 查询
terms_set 查询和 terms 查询是一样的查询规则,不同的是 terms_set 查询可以定义匹配词项的数量,定义的数量只能从文档中的某一列中进行获取或者使用脚本进行配置:
# 这里只能查询第一和第三两条数据,因为 `Wolf` 中的首字母大写,无法被精确匹配上,count列不能是text类型

GET index_002/_search

{

  "query": {

    "terms_set": {

      "name": {

        "terms": [

          "lonely",

          "Wolf"

        ],

        "minimum_should_match_field": "count"

      }

    }

  }

}
type 查询
指定类型查询,type 类型在 7.0 版本已经标注为过期,8.0 版本已经被废弃。
wildcard 查询
通过通配符进行查询,这个可以理解为是简易版本的正则表达式查询:
GET index_002/_search

{

  "query": {

   "wildcard": {

     "name": {

       "value": "lone*"

     }

   }

  }

}
全文查询
高级全文查询通常用于对全文字段 text 类型(比如电子邮件的正文)进行全文查询。全文查询在搜索和索引时,都会对字段进行分词处理,查询之前会先对输入的词进行分词处理,然后对每个词项进行查询,最后将结果进行合并,并根据算分结果将结果进行返回。
全文查询也包括很多种,在这里我们主要介绍 match 查询和 match_phrase 查询。
match 查询
match 查询是执行全文搜索的标准查询,包括模糊匹配选项。如下就是一个标准的 match 查询语句:
# 返回全部5条数据

POST index_002/_search

{

  "query": {

    "match": {

      "name": "lonely wolf"

    }

  }

}
对比 term 查询:
# 没有满足条件的结果

POST index_002/_search

{

  "query": {

    "term": {

      "name": "lonely wolf"

    }

  }

}

# 返回第一条数据

POST index_002/_search

{

  "query": {

    "term": {

      "name.keyword": "lonely wolf"

    }

  }

}
根据上面几个查询的结果我们可以得出 term 查询和全文 match 查询的区别:
term查询会将搜索关键字作为一个整体进行查询。match查询会将搜索关键字进行分词,且分词后默认是or的关系。
根据这两个结论,也可以很明显知道,一般不对 text 类型字段采用 term 查询,因为 text 类型字段会被分词索引,可能会导致无法被 term 查询匹配出结果。
再看下面这个例子,会返回第二和第三两条数据(分词后的搜索和顺序无关):
# 查询出最少匹配中3个词项的结果

POST index_002/_search

{

  "query": {

    "match": {

      "name": {

        "query": "hello wolf lonely",

        "operator": "or",

        "minimum_should_match": 3

      }

    }

  }

}
match_phrase 查询
match_phrase 会将输入的搜索关键字作为一个短语进行查询,这点看来类似于 term 查询,但是 match_phrase 查询内嵌了一个参数 slot 用来定义短语中允许的空隙,默认是 0 表示中间不允许有其他词:
POST index_002/_search

{

  "query": {

    "match_phrase": {

      "name": {

        "query": "lonely wolf"

      }

    }

  }

}
这条语句的结果就能查询出第一和第四条数据,注意,虽然第四条数据中的 lonely wolf 是大写字母开头,但是索引的时候会将其转为小写进行索引,所以也能查询出结果。
此时我们加入 slot=1 条件进行查询,表示允许短语之间存在一个间隙,所以此时能查询出第二条数据:
POST index_002/_search

{

  "query": {

    "match_phrase": {

      "name": {

        "query": "hello wolf lonely",

        "slop": 1

      }

    }

  }

}
总结
本文主要讲述了 Term 查询和全文查询中 match 查询的区别,总结起来主要有以下几点:
Term查询对搜索关键字不会进行分词处理,而是作为一个整体进行查询。- 全文查询如
match等查询,会对搜索关键字进行分词,并对每个词项进行搜索,默认or的关系进行合并,并最终算法返回结果。 - 对
Text类型字段,索引时会进行分词,大写字母会转成小写,所以如果用Term或者match_phrase查询时要注意因分词而对查询结果产生的影响。
Elasticsearch中的Term查询和全文查询的更多相关文章
- elasticsearch中的mapping映射配置与查询典型案例
elasticsearch中的mapping映射配置与查询典型案例 elasticsearch中的mapping映射配置示例比如要搭建个中文新闻信息的搜索引擎,新闻有"标题".&q ...
- ES 22 - Elasticsearch中如何进行日期(数值)范围查询
目录 1 范围查询的符号 2 数值范围查询 3 时间范围查询 3.1 简单查询示例 3.2 关于时间的数学表达式(date-math) 3.3 关于时间的四舍五入 4 日期格式化范围查询(format ...
- Elasticsearch+Mongo亿级别数据导入及查询实践
数据方案: 在Elasticsearch中通过code及time字段查询对应doc的mongo_id字段获得mongodb中的主键_id 通过获得id再进入mongodb进行查询 1,数据情况: ...
- 使用Hive或Impala执行SQL语句,对存储在Elasticsearch中的数据操作(二)
CSSDesk body { background-color: #2574b0; } /*! zybuluo */ article,aside,details,figcaption,figure,f ...
- 使用Hive或Impala执行SQL语句,对存储在Elasticsearch中的数据操作
http://www.cnblogs.com/wgp13x/p/4934521.html 内容一样,样式好的版本. 使用Hive或Impala执行SQL语句,对存储在Elasticsearch中的数据 ...
- Elasticsearch 5.0 中term 查询和match 查询的认识
Elasticsearch 5.0 关于term query和match query的认识 一.基本情况 前言:term query和match query牵扯的东西比较多,例如分词器.mapping ...
- 在Elasticsearch中查询Term Vectors词条向量信息
这篇文章有点深度,可能需要一些Lucene或者全文检索的背景.由于我也很久没有看过Lucene了,有些地方理解的不对还请多多指正. 更多内容还请参考整理的ELK教程 关于Term Vectors 额, ...
- Elasticsearch Query DSL 整理总结(一)—— Query DSL 概要,MatchAllQuery,全文查询简述
目录 引言 概要 Query and filter context Match All Query 全文查询 Full text queries 小结 参考文档 引言 虽然之前做过 elasticse ...
- ElasticSearch中的简单查询
前言 最近修改项目,又看了下ElasticSearch中的搜索,所以简单整理一下其中的查询语句等.都是比较基础的.PS,好久没写博客了..大概就是因为懒吧.闲言少叙书归正传. 查询示例 http:// ...
随机推荐
- 使用GitHub绑定域名免费创建自己的博客
通过GitHub创建一个免费的.有上传网页功能的.可以绑定域名的个人博客,或者网站. 在这之前的必要条件: 1.有自己的域名,能添加CNAME或者A记录 2.注册好了GitHub账号 方法: 1.添加 ...
- 如何使用ghost备份系统?
如何使用ghost备份系统? 如何使用ghost工具电脑系统备份?需要具体的详细步骤 关注者 11 被浏览 13,197 关注问题写回答 邀请回答 添加评论 分享 1 个回答 默认排 ...
- shell应用之cobbler批量部署
如果使用的是原始源,可直接使用该脚本,如果是用的其它源且有cobbler安装包的可删除脚本中的配置yum源步骤.批量部署使用的软件有:cobbler dhcp httpd tftp-server xi ...
- Java JOptionPane 对话框
如果你对 Java 控制台界面下的输入数据和打印输出结果感到有些乏味和厌倦,希望能够像其他计算机软件一样有一个 GUI 界面(图形用户界面). 那么 JOptionPane 对话框也许会让你眼前一亮, ...
- STM32自己的封装库
以前一直使用STM32的标准库,需要一步步地将代码加进去,将编译选项设置好,然后再编译整个工程. 这个编译过程是一个相当慢的过程!完全编译大约需要一支烟的时间.每次建立工程都这么编译,是一个相当浪费时 ...
- 源码篇:Flutter Provider的另一面(万字图文+插件)
前言 阅读此文的彦祖,亦菲们,附送一枚Provider模板代码生成插件! 我为啥要写这个插件呢? 此事说来话短,我这不准备写解析Provider源码的文章,肯定要写这框架的使用样例啊,然后再哔哔源码呀 ...
- GO学习-(34) Go实现日志收集系统3
Go实现日志收集系统3 再次整理了一下这个日志收集系统的框,如下图 这次要实现的代码的整体逻辑为: 完整代码地址为: etcd介绍 高可用的分布式key-value存储,可以用于配置共享和服务发现 ...
- jenkins配置基于角色的项目权限管理设置步骤
jenkins配置基于角色的项目权限管理设置步骤 本文链接:https://blog.csdn.net/russ44/article/details/52276222 由于jenkins默认的权限管理 ...
- Jmeter- 笔记8 - 分布式
分布式: 原因:在实际工作中,jmeter可能需要虚拟上千并发用户,而每台实际能虚拟的线程数时有限的,一般一台电脑小于2000个,1.5k - 2k可能就出现无法虚拟. 多台机器,一起虚拟并发用户数, ...
- 《MySQL面试小抄》索引考点一面总结
<MySQL面试小抄>索引考点一面总结 我是肥哥,一名不专业的面试官! 我是囧囧,一名积极找工作的小菜鸟 囧囧表示:面试最怕的就是面试官问的知识点太笼统,自己无法快速定位到关键问题点!!! ...