
Elasticsearch+Mongo亿级别数据导入及查询实践
- 在Elasticsearch中通过code及time字段查询对应doc的mongo_id字段获得mongodb中的主键_id
- 通过获得id再进入mongodb进行查询
- 全部为股票及指数的分钟K线数据(股票代码区分度较高)
- Elasticsearch及mongodb都未分片且未优化参数配置,mongo表中只有主键_id索引
- mongodb数据量:

- Elasticsearch数据量:

2,将数据从mongo源库导入Elasticsearch
import time

from pymongo import MongoClient

from elasticsearch import Elasticsearch

from elasticsearch.helpers import bulk

es = Elasticsearch()

conn = MongoClient('127.0.0.1', 27017)

db = conn.kline_db

my_set = db.min_kline

x = 1

tmp = []

#此处有个坑mongo查询时由于数据量比较大时间较长需要设置游标不过期:no_cursor_timeout=True

for i in my_set.find(no_cursor_timeout=True):

    x+=1

    #每次插入100000条

    if x%100000 == 99999:

        #es批量插入

        success, _ = bulk(es, tmp, index='test_2', raise_on_error=True)

        print('Performed %d actions' % success)

        tmp = []

    if i['market'] == 'sz':

        market = 0

    else:

        market = 1

    #此处有个秒数时间类型及时区转换

    tmp.append({"_index":'test_2',"_type": 'kline','_source':{'code':i['code'],'market':market,\

                'time':time.strftime("%Y-%m-%d %H:%M:%S", time.localtime(i['kline_time']/1000 - 8*60*60))\

                ,'mongo_id':str(i['_id'])}})

#将最后剩余在tmp中的数据插入

if len(tmp)>0:

    success, _ = bulk(es, tmp, index='test_2', raise_on_error=True)

    print('Performed %d actions' % success)
3,Elasticsearch+mongo查询时间统计
import time

from pymongo import MongoClient

from elasticsearch import Elasticsearch

from elasticsearch.helpers import scan

from bson.objectid import ObjectId

#es连接

es = Elasticsearch()

#mongo连接

conn = MongoClient('127.0.0.1', 27017)

db = conn.kline_db  #连接kline_db数据库,没有则自动创建

my_set = db.min_kline

tmp = []

#计算运行时间装饰器

def cal_run_time(func):

    def wrapper(*args,**kwargs):

        start_time = time.time()

        res = func(*args,**kwargs)

        end_time = time.time()

        print(str(func) +'---run time--- %s' % str(end_time-start_time))

        return res

    return wrapper

@cal_run_time

def query_in_mongo(tmp_list):

    k_list = []

    kline_data = my_set.find({'_id':{'$in':tmp_list}})

    for k in kline_data:

        k_list.append(k)

    return k_list

@cal_run_time

def query_in_es():

    #bool多条件查询 must相当于and

    body = {

        "query": {

            "bool": {

                "must": [{

                    "range": {#范围查询

                        "time": {

                            "gte": '2017-01-10 00:00:00',  # >=

                            "lte": '2017-04-12 00:00:00'  # <=

                        }

                    }

                },

                    {"terms": {# == 或  in:terms 精确查询

                        "code": ['','']

                    }

                    }

                ]

            }

        }

    }

    #根据body条件记性查询

    scanResp = scan(es, body, scroll="10m", index="test_2",doc_type="kline", timeout="10m")

    #解析结果字典并放入tmp列表中

    for resp in scanResp:

        tmp.append(ObjectId(resp['_source']['mongo_id']))

    print(len(tmp))

    #--------------此处有个坑,直接使用search方法查询到的结果集中最多只有10条记录----------------

    # zz = es.search(index="test_2", doc_type="kline", body=body)

    # print(zz['hits']['total'])

    # for resp in zz['hits']['hits']:

    #     tmp.append(ObjectId(resp['_source']['mongo_id']))

query_in_es()

query_in_mongo(tmp)
运行结果如下:
第一行:查询的doc个数:28320
第二行:es查询所用时间:0.36s
第三行:mongo使用_id查询所用时间 :0.34s
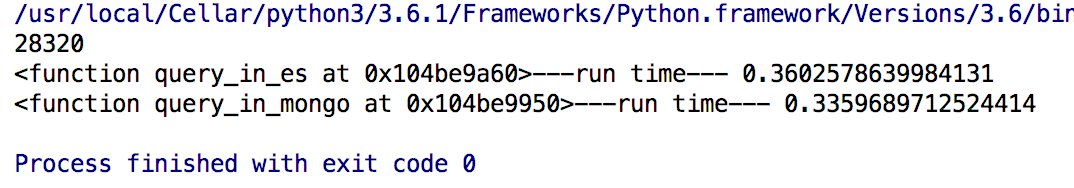
从结果来看对于3亿多数据的查询Elasticsearch的速度还是相当不错的
※Elasticsearch主要的优势在于可以进行快速的分词模糊查询,所以股票K线这个场景并没有充分发挥其优势,至于查询效率,其实mysql,mongo等只要分库分表合理一样能够达到。
※Elasticsearch+Mongo这个架构主要针对场景:使用mongo存储海量数据,且这张表读写都很频繁。
Elasticsearch+Mongo亿级别数据导入及查询实践的更多相关文章
- clickhouse安装数据导入及查询测试
官网 https://clickhouse.tech/ quick start ubantu wget https://repo.yandex.ru/clickhouse/deb/lts/main/c ...
- JuiceFS 在 Elasticsearch/ClickHouse 温冷数据存储中的实践
企业数据越存越多,存储容量与查询性能.以及存储成本之间的矛盾对于技术团队来说是个普遍难题.这个难题在 Elasticsearch 与 ClickHouse 这两个场景中尤为突出,为了应对不同热度数据对 ...
- Elasticsearch学习笔记——安装、数据导入和查询
到elasticsearch网站下载最新版本的elasticsearch 6.2.1 ? 1 https://www.elastic.co/downloads/elasticsearch 中文文档请参 ...
- [原创]PostgreSQL Plus Advanced Server批量创建分区表写入亿级别数据实例
当前情况:大表的数据量已接近2亿条我的解决思路:为它创建n*100个分区表,将各个分区表放在不同的tablespace上这样做的优点:1.首先是对这个级别的数据表的性能会有所提升2.数据管理更科学3. ...
- 百亿级别数据量,又需要秒级响应的案例,需要什么系统支持呢?下面介绍下大数据实时分析工具Yonghong Z-Suite
Yonghong Z-Suite 除了提供优秀的前端BI工具之外,Yonghong Z-Suite让用户可以选购分布式数据集市来支持实时大数据分析. 对于这种百亿级的大数据案例,Yonghong Z- ...
- Elasticsearch的脚本化数据导入导出
我用的ES的版本是2.4.1,由于没有相应的命令实现数据的导入和导出,就是像mysql的那种mysqldump类似的指令. 更苦逼的是,我们的生产和测试环境,还不能联网,连ES的第三方的插件都没有办法 ...
- 使用Mongo dump 将数据导入到hive
概述:使用dump 方式将mongo数据导出,上传到hdfs,然后在hive中建立外部表. 1. 使用mongodump 将集合导出 mongodump --host=localhost:27 ...
- Mongo实战之数据空洞的最佳实践
问题背景: 某天,开发部的同事跑过来反映: mongodb数据文件太大,快把磁盘撑爆了!其中某个db占用最大(运营环境这个db的数据量其实很小) 分析: 开发环境有大量测试的增/删/改操作,而由于Mo ...
- 转载:MongoDB 在 58 同城百亿量级数据下的应用实践
为什么要使用 MongoDB? MongoDB 这个来源英文单词“humongous”,homongous 这个单词的意思是“巨大的”.“奇大无比的”,从 MongoDB 单词本身可以看出它的目标是提 ...
随机推荐
- Git使用之pull request
一直对git的使用都不熟,由于工作需要经常需要在github上pull request,第一次还是有些麻烦的,写个笔记记录下 1. fork源项目到自己的github仓库中 fork之后自己也会多出一 ...
- kafka笔记9(监控)
Kafka提供的所有度量指标都是通过JMX(Java Management Extensions)接口访问 JMX端口查询: zookeeper上获取端口信息 /brokers/ids/<I ...
- springMVC--XML解析
一 springMVC 入口 web.xml; DispatcherServlet二 初始化过程 1.寻找init(); 查看DispatcherServlet时候时,继承自servlet,肯定有初始 ...
- (转)Oracle EBS 有效银行账户取值 银行科目
SELECT ba.bank_account_id, --银行账户key ftv.territory_short_name, --国家 ftv.territory_code, --国家简称 cb.ba ...
- uva 10123 - No Tipping dp 记忆化搜索
这题的题意是 在双脚天平上有N块东西,依次从上面取走一些,最后使得这个天平保持平衡! 解题: 逆着来依次放入,如果可行那就可以,记得得有木板自身的重量. /********************** ...
- Angular4 组件间通讯
- 第一个Python窗口
import tkinter def my_window(w, h): ws = root1.winfo_screenwidth(); hs = root1.winfo_screenheight(); ...
- java线程学习之yield方法
yield方法是暂停当前正在执行的线程对象,并执行其他线程. 这是一个静态方法,一旦执行,它会使当前线程让出CPU.让出的cpu并不代表当前线程不执行了.当前线程让出CPU后,还会CPU资源的争夺,但 ...
- 第十六节 BOM基础
打开.关闭窗口 open:蓝色理想运行代码功能 <button onclick="window.open('http://www.baidu.com')">打开窗口&l ...
- 移动端js调试工具:eruda
通常写前端页面都在Chrome浏览器的开发模式下进行调试,但是写放在移动端的H5页面时,有时候会遇到在Chrome上调试没有问题,但是在手机的浏览器上有问题的情况:或者有些功能只能在特定的容器中才能其 ...