
Scrapy爬虫框架之爬取校花网图片
Scrapy
Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中。
其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的, 也可以应用在获取API所返回的数据(例如 Amazon Associates Web Services ) 或者通用的网络爬虫。Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试。
一、安装
注:windows平台需要依赖pywin32,请根据自己系统32/64位选择下载安装
https://sourceforge.net/projects/pywin32/files/pywin32/
linux:
yum install libxml2-devel libxslt-devel sqlite-devel
pip install lxml
pip install pyOpenSSL
pip install pysqlite
|
1
|
pip install Scrapy
|
二、基本使用
1、创建项目
运行命令:
|
1
|
scrapy startproject your_project_name |
自动创建目录:
|
1
2
3
4
5
6
7
8
9
|
project_name/ scrapy.cfg project_name/ __init__.py items.py pipelines.py settings.py spiders/ __init__.py |
文件说明:
- scrapy.cfg 项目的配置信息,主要为Scrapy命令行工具提供一个基础的配置信息。(真正爬虫相关的配置信息在settings.py文件中)
- items.py 设置数据存储模板,用于结构化数据,如:Django的Model
- pipelines 数据处理行为,如:一般结构化的数据持久化
- settings.py 配置文件,如:递归的层数、并发数,延迟下载等
- spiders 爬虫目录,如:创建文件,编写爬虫规则
注意:一般创建爬虫文件时,以网站域名命名
2、编写爬虫
在spiders目录中新建 xiaohuar_spider.py 文件
#!/usr/bin/env python

# -*- coding:utf-8 -*-

import scrapy

class XiaoHuarSpider(scrapy.spiders.Spider):

    name = "xiaohuar"

    allowed_domains = ["xiaohuar.com"]

    start_urls = [

        "http://www.xiaohuar.com/hua/",

    ]

    def parse(self, response):

        # print(response, type(response))

        # from scrapy.http.response.html import HtmlResponse

        # print(response.body_as_unicode())

        current_url = response.url

        body = response.body

        #unicode_body = response.body_as_unicode()

        print body  #爬取结果
3、运行
进入project_name目录,运行命令
|
1
|
scrapy crawl spider_name --nolog |
4、递归的访问
以上的爬虫仅仅是爬去初始页,而我们爬虫是需要源源不断的执行下去,直到所有的网页被执行完毕
爬取页面中所有的图片
注:可以修改settings.py 中的配置文件,以此来指定“递归”的层数,如: DEPTH_LIMIT = 1
#!/usr/bin/env python

#encoding: utf-8

import scrapy

from scrapy.http import Request

from scrapy.selector import HtmlXPathSelector

import re

import urllib

import os

class XiaoHuarSpider(scrapy.spiders.Spider):

    name = "xiaohuar"

allowed_domains = ["xiaohuar.com"]

    start_urls = [

        "http://www.xiaohuar.com/list-1-1.html",

]

    def parse(self, response):

        # 分析页面

# 找到页面中符合规则的内容(校花图片),保存

# 找到所有的a标签,再访问其他a标签,一层一层的搞下去

hxs = HtmlXPathSelector(response)

        # 如果url是 http://www.xiaohuar.com/list-1-\d+.html

if re.match('http://www.xiaohuar.com/list-1-\d+.html', response.url):

            items = hxs.select('//div[@class="item_list infinite_scroll"]/div')

            for i in range(len(items)):

                src = hxs.select('//div[@class="item_list infinite_scroll"]/div[%d]//div[@class="img"]/a/img/@src' % i).extract()

                name = hxs.select('//div[@class="item_list infinite_scroll"]/div[%d]//div[@class="img"]/span/text()' % i).extract()

                school = hxs.select('//div[@class="item_list infinite_scroll"]/div[%d]//div[@class="img"]/div[@class="btns"]/a/text()' % i).extract()

                if src:

                    ab_src = "http://www.xiaohuar.com" + src[0]

                    #file_name = "%s_%s.jpg" % (school[0].encode('utf-8'), name[0].encode('utf-8'))

                    #file_path = os.path.join("/Users/wupeiqi/PycharmProjects/beauty/pic", file_name)

file_name = '%d_pic.jpg'%i

                    urllib.urlretrieve(ab_src, file_name)

        # 获取所有的url,继续访问,并在其中寻找相同的url

all_urls = hxs.select('//a/@href').extract()

        for url in all_urls:

            if url.startswith('http://www.xiaohuar.com/list-1-'):

                yield Request(url, callback=self.parse)
开始爬取
#scrapy crawl xiaohuar --nolog
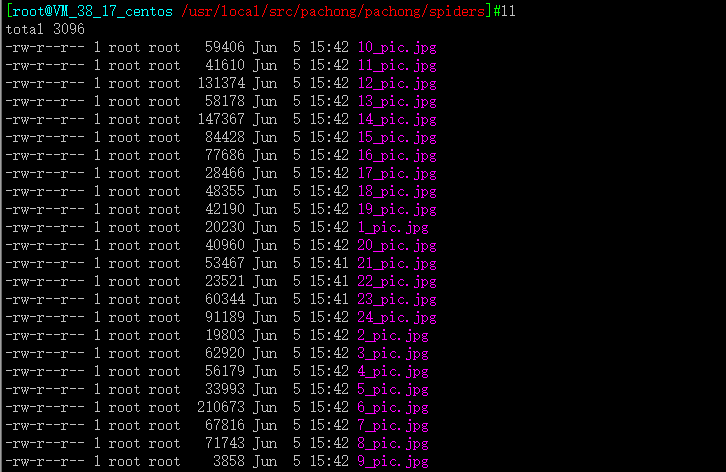
打包传到windows打开

Scrapy爬虫框架之爬取校花网图片的更多相关文章
- python爬虫基础应用----爬取校花网视频
一.爬虫简单介绍 爬虫是什么? 爬虫是首先使用模拟浏览器访问网站获取数据,然后通过解析过滤获得有价值的信息,最后保存到到自己库中的程序. 爬虫程序包括哪些模块? python中的爬虫程序主要包括,re ...
- Go语言实战-爬取校花网图片
一.目标网站分析 爬取校花网http://www.xiaohuar.com/大学校花所有图片. 经过分析,所有图片分为四个页面,http://www.xiaohuar.com/list-1-0.htm ...
- python实战项目 — 爬取 校花网图片
重点: 1. 指定路径创建文件夹,判断是否存在 2. 保存图片文件 # 获得校花网的地址,图片的链接 import re import requests import time import os ...
- scrapy爬取校花网男神图片保存到本地
爬虫四部曲,本人按自己的步骤来写,可能有很多漏洞,望各位大神指点指点 1.创建项目 scrapy startproject xiaohuawang scrapy.cfg: 项目的配置文件xiaohua ...
- windows下使用python的scrapy爬虫框架,爬取个人博客文章内容信息
scrapy作为流行的python爬虫框架,简单易用,这里简单介绍如何使用该爬虫框架爬取个人博客信息.关于python的安装和scrapy的安装配置请读者自行查阅相关资料,或者也可以关注我后续的内容. ...
- 第六篇 - bs4爬取校花网
环境:python3 pycharm 模块:requests bs4 urlretrieve os time 第一步:获取网页源代码 import requests from bs4 imp ...
- scrapy从安装到爬取煎蛋网图片
下载地址:https://www.lfd.uci.edu/~gohlke/pythonlibs/pip install wheelpip install lxmlpip install pyopens ...
- Python-爬取校花网视频(单线程和多线程版本)
一.参考文章 python爬虫爬取校花网视频,单线程爬取 爬虫----爬取校花网视频,包含多线程版本 上述两篇文章都是对校花网视频的爬取,由于时间相隔很久了,校花网上的一些视频已经不存在了,因此上述文 ...
- Java基础-爬虫实战之爬去校花网网站内容
Java基础-爬虫实战之爬去校花网网站内容 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 爬虫这个实现点我压根就没有把它当做重点,也没打算做网络爬虫工程师,说起爬虫我更喜欢用Pyt ...
随机推荐
- Mysql-外键foreign key
1.定义:如果一张表中有一个字段指向另一张表的主键,就子表中将该主键字段叫做外键. 一张表中可存在多个外键 2.外键的作用 保持数据的一致性.完整性 a.对子表(外键所在的表)的作用:子表在进行写操作 ...
- RPM 安装oracle18c 修改字符集的方法
1. 安装完preinstall 和 oracle 的rpm版本之后 到这个界面 rpm -ivh oracle-database-preinstall-18c-.el7.x86_64.rpm war ...
- Linux上的free命令详解-收藏
解释一下Linux上free命令的输出. 下面是free的运行结果,一共有4行.为了方便说明,我加上了列号.这样可以把free的输出看成一个二维数组FO(Free Output).例如: FO[2][ ...
- spring 中 ThreadPoolTaskExecutor 的使用
配置文件代码如下: <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="htt ...
- 数据库性能优化之SQL语句优化(下)
(1) 选择最有效率的表名顺序(只在基于规则的优化器中有效): ORACLE 的解析器按照从右到左的顺序处理FROM子句中的表名,FROM子句中写在最后的表(基础表 driving table)将被最 ...
- System Board Replacement Notice
System Board Replacement Notice System Board Replacement Notice for TP 770E and TP 600 Restoring the ...
- c++11 闭包的实现
c++11 闭包的实现 什么是闭包 闭包有很多种定义,一种说法是,闭包是带有上下文的函数.说白了,就是有状态的函数.更直接一些,不就是个类吗?换了个名字而已. 一个函数,带上了一个状态,就变成了闭包了 ...
- python模块之 paramiko
paramiko模块提供了ssh及sft进行远程登录服务器执行命令和上传下载文件的功能.这是一个第三方的软件包,使用之前需要安装. 1 基于用户名和密码的 sshclient 方式登录 # 建立一个s ...
- DataTables实现rowspan思路
直接看例子吧 <table id="example" class="display table table-bordered" cellspacing=& ...
- LGP4588[JSOI2018]扫地机器人
题解 需要先说明一点东西: 1 同一副对角线方向相同,共有$gcd(n,m)$条不同的副对角线,机器人的行为是一个$gcd(n,m)$的循环:: 如果左上方是$(1,1)$,容易看出所有的路径是从左或 ...